Text & Reasoning
Claude Fable 5.1
Für aufwendige Analyse, Recherche und lange Agentenabläufe. Adaptive Thinking bleibt immer aktiv.
Technologie verstehen.
Besser entscheiden.
 Text & Reasoning
Claude Sonnet 5.5 ist für klar umrissene Text-, Code- und Werkzeugaufgaben vorgesehen. Text und Bilder können eingegeben werden, die Ausgabe ist Text. Das Profil zeigt, welche Einstellungen bei der API zählen und wie sich eine kleine Aufgabe nachvollziehbar prüfen lässt.
Nutze den in den Quellen genannten Anbieterzugang für genau diese Version. Ein Produktabo enthält nicht automatisch API-Guthaben.
Aktiv · aktuelle FamilieQuellenstand 2026-10-24
Anthropic im Verzeichnis
Nachprüfung am 24. Oktober 2026; Herstellerdokumentation, kein eigener Modelltest.
Anthropic hat die API-Version 2026-10-21 und neue SDK-Hauptversionen veröffentlicht. Das ist keine zusätzliche Modellgeneration. Am 22. Oktober kam ein Anthropic-managed-Zugang über Google Cloud hinzu. Prüfe Plattform, API-Vertrag, Modell-ID und Clientversion gemeinsam; vorhandene Praxisaufgaben bleiben darunter erhalten.
Claude-API-Update vom Oktober 2026: Aktuelle SDK-/API-Änderungen von der Modellversion unterscheiden.
Herstellerquelle zum Update · geprüft am 24. Oktober 2026
Identität, Funktionen und Betrieb getrennt lesen. Die Angaben beziehen sich auf diese konkrete Version.
„Nicht bestätigt“ kennzeichnet eine offene Angabe. Es bedeutet weder „nicht vorhanden“ noch „unbegrenzt“.
| Hersteller | Anthropic |
|---|---|
| Modellfamilie | Claude |
| Modell-/API-ID | claude-sonnet-5-5 |
| Status | Aktiv · aktuelle Familie |
| Modellart | Text & Reasoning |
|---|---|
| Eingabe | Text, Bild |
| Ausgabe | Text |
| Kontext | 1.000.000 Tokens |
|---|---|
| Maximaler Output / Horizont | 128.000 Tokens |
| Bereitstellung | Gehosteter Zugang |
|---|---|
| Gewichte | Gehosteter oder integrierter Zugang |
| Lizenz | Anbieterbedingungen |
Input und Output sind getrennte Texttarife je einer Million Tokens. Preisstufen, Cache, Werkzeuge und weitere Bedingungen stehen im Kostenabschnitt. Kein Preis für eine konkrete Aufgabe.
Datenbasis: Herstellerangaben im Quellenstand 2026-10-24. Quellen zu diesem Profil ↓

Eine einzelne Funktion überarbeiten, eine Tabelle erklären oder aus bereitgestelltem Material einen Entwurf erstellen: Solche abgegrenzten Aufgaben entsprechen den Einsatzgebieten, die Anthropic für Sonnet 5.5 nennt. Umfang und gewünschtes Ergebnis sollten vorab feststehen. Eine überzeugende Antwort belegt noch nicht, dass Code läuft oder eine Zahl richtig übernommen wurde. Das Vergleichsblatt für KI-Tools hilft dir, Ergebnis, Datenweg und erforderliche Nacharbeit für dieselbe Aufgabe festzuhalten.
Die Claude-API-ID lautet claude-sonnet-5-5. Adaptive Thinking ist standardmäßig aktiv, auf der API mit Effort high. Die Claude-Apps und Claude Code verwenden laut Einführung eine andere Voreinstellung: medium. Wer Ergebnisse vergleicht, sollte deshalb die tatsächlich verwendete Einstellung notieren.
Für Anfragen ohne vorgelagertes Thinking dokumentiert Anthropic between_tools als niedrigste Thinking-Einstellung. Sie ist bei low, medium und high zulässig, nicht bei xhigh oder max. Das frühere disabled führt bei Sonnet 5.5 zu einem Fehler. Bei Werkzeugabläufen müssen zurückgegebene Thinking-Blöcke trotzdem korrekt weitergereicht werden.
Einige bisherige Integrationen benötigen weitere Anpassungen: Erzwungene Werkzeugwahl ist nicht unterstützt, und bestimmte ältere Advisor-Modelle werden abgelehnt. Wenn du nur im Chat arbeitest, sind diese API-Details meist keine Einrichtungsschritte für dich. Bei eigener Software sind sie konkrete Punkte für eine Migration.
Stand 24. Oktober 2026
Claude API Standard: 2 USD Input/10 USD Output je Million Tokens. Cache Read seit 07.10.: 0,10 USD/Mio.;5-Minuten-Schreiben 2,50 USD und1-Stunde-Schreiben 4 USD. Kein universeller 50%-Rabatt auf alle Anfragen.
Bereitstellung: Gehosteter Zugang. Prüfe vor Nutzung die tatsächliche Freischaltung, Region und Sondertarife. Die Quelldokumentation steht unter „Quellen“.
Praxisergänzung geprüft am 21. Oktober 2026 · eigene Aufgabe, kein Modellbenchmark
Eine strukturierte Antwort ist besonders nützlich, wenn nachfolgende Systeme bestimmte Felder erwarten. Trotzdem kann ein syntaktisch richtiges JSON eine erfundene Kundennummer oder einen falschen Termin enthalten. Unser Ticket ist deshalb absichtlich unvollständig. Das Ziel ist ein bearbeitbarer Entwurf, keine automatisch versendete Antwort.
Verwende in der Claude API die ID claude-sonnet-5-5. Anthropic dokumentiert Änderungen gegenüber Sonnet 5, unter anderem bei Thinking und erzwungener Werkzeugwahl. Ein Modellwechsel und eine Änderung des Datenformats sind zwei getrennte Dinge. Die Promptvorlage beschreibt das gewünschte JSON; in einer API-Anwendung kommt die zum Endpunkt passende Schema-Konfiguration hinzu.
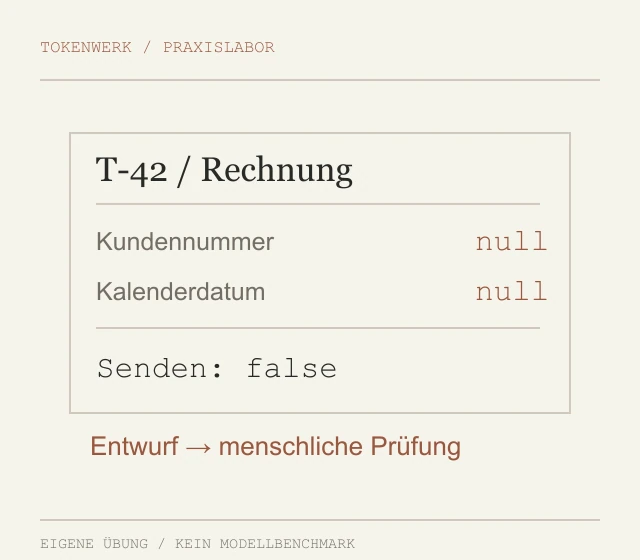
Übernimm die Nachricht unverändert. Lege fest, dass unbekannte Felder null bleiben.
Prüfe zunächst das JSON und anschließend jede Behauptung gegen den Nachrichtentext.
Leite den Entwurf in einer echten Automation erst nach der vorgesehenen menschlichen Prüfung weiter.
Die Angaben sind fiktiv. Speichere den geforderten JSON-Teil der Antwort separat als antwort.json; zusätzliche Erklärungen gehören in eine andere Datei.
Fiktive Supportnachricht T-42:
"Seit gestern kann ich meine Rechnung nicht laden. Bitte helft mir. Meine Kundennummer habe ich gerade nicht zur Hand."
Erzeuge JSON mit ticket_id, thema, kundennummer, stoerungsbeginn_datum und automatisch_senden.
ticket_id ist T-42; thema ist rechnung_download. Nicht vorhandene Angaben bleiben null. "Gestern" hat ohne bekanntes Bezugsdatum kein bestimmtes Kalenderdatum. automatisch_senden muss false sein.
Schreibe außerhalb des JSON einen Antwortentwurf mit einer einzigen Rückfrage. Keine Zugangsdaten anfordern.Vorlage herunterladenLokalen JSON-Prüfer herunterladen
{
  "ticket_id": "T-42",
  "thema": "rechnung_download",
  "kundennummer": null,
  "stoerungsbeginn_datum": null,
  "automatisch_senden": false
}Das Soll ist redaktionell aus der Vorlage abgeleitet, keine aufgezeichnete Modellantwort. Der lokale Prüfer vergleicht die festgelegten Felder und führt keinen generierten Code oder API-Aufruf aus. Er bewertet keine freien Begründungen.
Speichere Prüfer und deine Antwort im selben Ordner. Mit installiertem Python: python pruefen.py antwort.json.
| Beobachtung | Was du prüfst |
|---|---|
| Korrektes JSON, falsches Datum | Formatprüfung und Faktenprüfung wurden verwechselt. |
| automatisch_senden ist true | Die verlangte Freigabegrenze wurde überschritten. |
| Fehler nach dem Modellwechsel | Prüfe die aktuelle Sonnet-Migrationsanleitung, statt alte Thinking-/Tool-Parameter zu übernehmen. |
Für die spätere technische Anbindung zeigt der Guide HTTP-Anfragen mit JSON aufbauen und erläutert den Unterschied zwischen Objekt und JSON-Text.
Den Übergang vom Entwurf zur Aktion kannst du mit KI-Workflows mit Freigabe aufbauen als eigenen Arbeitsschritt gestalten.
Gezielte Praxisergänzung auf Basis aktueller Herstellerunterlagen. Der Datenstand der bisherigen Modell-Faktentabellen bleibt separat ausgewiesen. Neue Beispiele und Grafiken sind eigene Erklärungen; es wurden keine Modellantworten oder Leistungswerte gemessen.
Herstellerunterlagen zur Ergänzung: Claude Sonnet 5.5 - Claude Platform Docs (Abruf 2026-10-21) · Structured outputs - Claude Platform Docs (Abruf 2026-10-21).
Die verlinkten Herstellerunterlagen wurden für dieses Profil ausgewertet. Ältere Versionen und Einführungstexte dienen der Einordnung; aktuelle technische Angaben haben Vorrang. Abrufdaten stehen an den Quellen. Die Grafik ist redaktionell, kein Leistungstest.
Anthropic nennt klar umrissene alltägliche Aufgaben in Programmierung, Werkzeugabläufen und Wissensarbeit. Ob es für deine Aufgabe geeignet ist, hängt von einem passenden eigenen Test ab; dieses Profil stellt keine allgemeine Rangliste auf.
Claude Sonnet 5.5 mit der Claude-API-ID claude-sonnet-5-5. Dokumentiert sind Text- und Bildeingaben, Textausgabe, eine Million Kontexttokens und maximal 128.000 Ausgabetokens.
Es ist die dokumentierte niedrigste Thinking-Einstellung auf Sonnet 5.5 und schaltet vorgelagertes Thinking ab. Sie ist bei Effort low, medium oder high zulässig. Sie ist nicht dasselbe wie das frühere disabled und nicht mit xhigh oder max kombinierbar.
Die aktuelle technische Dokumentation nennt 0,10 USD je Million Cache-Lesetokens. Der Standardpreis für normale Eingabe-/Ausgabetokens ist 2/10 USD je Million. Die ältere Einführung nennt für Cache-Lesen noch 0,20 USD und wurde hier zeitlich eingeordnet.
Nur mit dokumentierten Bedingungen. Die Einführung nennt Effort high als API-Voreinstellung und medium für Apps beziehungsweise Claude Code. Zugänge, Werkzeuge und tatsächlich gesetzte Einstellungen können sich unterscheiden.
Im dokumentierten Quellenstand: 1.000.000 Tokens. Beachte die Bedingungen der konkreten Modellversion und des verwendeten Endpunkts. Kontext ist keine Wortzahl und kein Nachweis, dass jede enthaltene Information zuverlässig verarbeitet wird.
Lege eine kleine Aufgabe mit bekanntem oder nachprüfbarem Ergebnis fest. Notiere Version, Eingabe und Einstellungen. Vergleiche die Ausgabe mit deinem Prüfkriterium und halte Fehler sowie tatsächliche Kosten getrennt fest. Die Testidee auf dieser Seite ist ein Vorschlag und wurde hier nicht als Modelltest ausgeführt.
Nein. Ein Prompt formuliert die gewünschte Form; eine technische Schema-Erzwingung wird gesondert im verwendeten API-Endpunkt eingerichtet.
Die fiktive Nachricht enthält kein bekanntes Bezugsdatum. Ein konkretes Datum wäre deshalb eine zusätzliche, unbelegte Information.
Das entscheidet dein Arbeitsablauf. In dieser Übung ist automatisch_senden ausdrücklich false; vor einem Versand ist eine menschliche Prüfung vorgesehen.
Text & Reasoning
Für aufwendige Analyse, Recherche und lange Agentenabläufe. Adaptive Thinking bleibt immer aktiv.
Text & Reasoning
Für umfangreiche Programmieraufgaben und Arbeit mit Dokumenten. Adaptive Thinking ist immer aktiv.
Text & Reasoning
Für Klassifikation, Extraktion, Routing und häufig wiederholte Aufgaben.