Ollama erleichtert den Betrieb von KI-Modellen. Für lokale Nutzung wählst du ein passendes lokales Modell; Cloud-Modelle und externe Werkzeuge haben einen anderen Datenweg. Prüfe deshalb Modell, Betriebsmodus und die komplette Anwendung.
Was erklärt ist. Was tatsächlich getestet wurde.
- Dieser Guide
- Erklärt Laufzeit, Modell und Datenweg
- Das Lernbeispiel
- Eine entworfene Aufgabe mit Prüfkriterien
- Eigener Versuch
- Separater Laptop-Test mit Rohantworten
Eine lokale Modellanfrage, ein Download und die Nutzung externer Werkzeuge sind unterschiedliche Datenwege. Der praktische Einstieg und ein gemessenes Ergebnis haben deshalb jeweils einen eigenen Nachweis.
Inhaltlich eingeordnet am .
Software, Modell und Oberfläche haben verschiedene Aufgaben
Beim Einstieg werden häufig drei Dinge unter einem Namen zusammengefasst. Die Trennung hilft dir, Fragen zur Qualität, Bedienung und Speicherung richtig zuzuordnen:
| Bestandteil | Aufgabe | Deine Entscheidung |
|---|---|---|
| Ollama | Modelle bereitstellen und Anfragen ausführen | Wo und wie die Software läuft |
| KI-Modell | Die eigentliche Antwort erzeugen | Welches Modell zur Aufgabe und zum Rechner passt |
| Oberfläche oder Anwendung | Eingaben und Ergebnisse nutzbar machen | App, Terminal oder eigene Integration |
Der aktuelle Ollama-Quickstart nennt macOS, Windows und Linux als Plattformen und zeigt lokale sowie Cloud-Aufrufe. Der gleiche Produktname steht damit für mehrere Betriebswege. Eine Aussage wie „Ollama läuft lokal“ beschreibt dein konkretes Setup erst dann ausreichend, wenn auch das ausgewählte Modell und die verbundenen Dienste feststehen.
So läuft eine lokale Anfrage ab
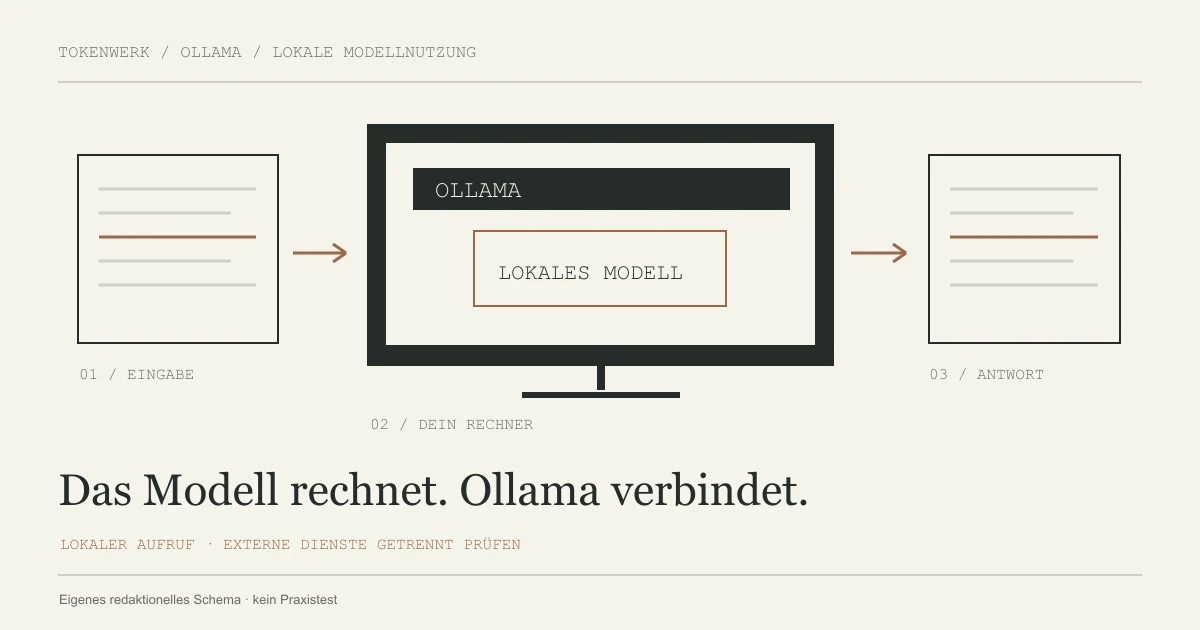
Bei einem einfachen lokalen Beispiel schickst du eine kurze Notiz an ein Modell, das auf deinem Rechner bereitgestellt ist. Ollama lädt beziehungsweise verwendet dieses Modell, verarbeitet die Anfrage und liefert die erzeugte Antwort an die Oberfläche zurück. Eine eigene Anwendung kann dafür die lokale API ansprechen. Wenn das trainierte Modell deine Eingabe verarbeitet und ein Ergebnis berechnet, heißt das Inferenz.
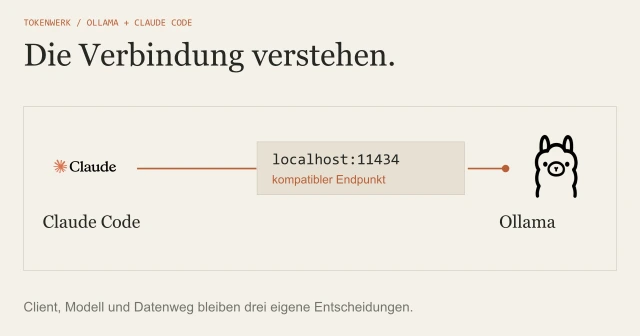
Die Ollama-FAQ nennt für die Standardbindung 127.0.0.1 und Port 11434. Diese Adresse meint den Rechner selbst. Soll ein anderes Gerät zugreifen, ist das eine zusätzliche Netzwerkkonfiguration, die du bewusst einrichten und begrenzen musst. Die Anleitung zum Ollama-Port 11434 erklärt die Verbindungskontrolle und einen möglichen Portwechsel.
Unser eigener Anwendungsfall wäre eine Notiz mit zwei beschlossenen Aufgaben und einer offenen Frage. Das Modell soll daraus eine kurze Übersicht erstellen. Anschließend vergleichst du die Antwort mit der Notiz: Sind beide Aufgaben enthalten, ist die offene Frage als offen erkennbar und wurde kein Termin hinzugefügt? Eine gut lesbare Antwort allein belegt diese Punkte noch nicht. Wie ein solcher Sollabgleich tatsächlich ausfiel, zeigt unser protokollierter lokaler Ollama-Test mit künstlichen Aufgaben.

Lokal und Cloud bewusst unterscheiden
Der Hersteller dokumentiert sowohl lokale Modelle als auch Cloud-Modelle. Für lokale API-Beispiele ist kein Ollama-API-Schlüssel erforderlich. Bei Cloud-Aufrufen werden Anfragen dagegen an den dafür vorgesehenen Dienst gesendet. Auch eine lokal installierte App kann also je nach Auswahl einen entfernten Modellbetrieb verwenden.
Wenn du ausschließlich lokal arbeiten möchtest, beschreibt die FAQ die Umgebungsvariable OLLAMA_NO_CLOUD=1 oder die Einstellung disable_ollama_cloud in der Serverkonfiguration. Nach einer Änderung ist ein Neustart von Ollama vorgesehen. Das deaktiviert die dokumentierten Ollama-Cloud-Funktionen einschließlich Cloud-Modellen und Websuche.
Betrachte außerdem die Werkzeuge um das Modell herum. Eine Oberfläche kann eigene Synchronisation, externe Suche oder weitere Dienste verwenden. Aus der lokalen Ausführung des Modells lässt sich deshalb keine pauschale Aussage über jeden Datenfluss des gesamten Arbeitsablaufs ableiten. Prüfe, welche Anwendung welche Daten wohin sendet.
Ein kleiner erster Test
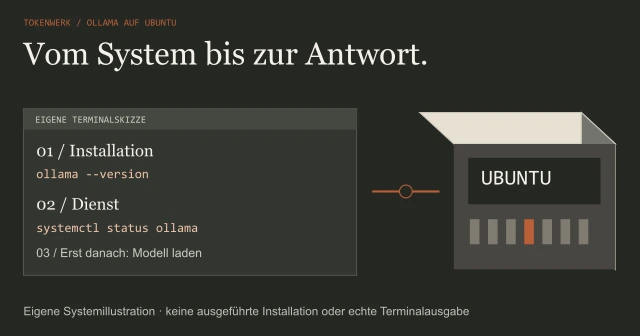
- Installiere Ollama über den offiziellen Download für dein Betriebssystem.
- Wähle im aktuellen Einstieg ausdrücklich ein lokales Modell, wenn du auf deinem Rechner arbeiten möchtest.
- Prüfe mit
ollama list, welche Modelle vorhanden sind. - Rufe eine geeignete lokale Modellbezeichnung mit
ollama run MODELL:TAGauf.MODELL:TAGist ein Platzhalter für deinen tatsächlichen Modellnamen. - Teste eine kleine Aufgabe, deren richtige Antwort du kontrollieren kannst.
Verwende für den ersten Versuch eine selbst erstellte kurze Notiz. Vergleiche mehrere Eingaben mit unterschiedlicher Schwierigkeit: ein klarer Beschluss, eine fehlende Angabe und eine widersprüchliche Information. Halte fest, welche Antworten brauchbar sind und wo eine Kontrolle nötig bleibt. Der Auswahlguide für lokale KI-Modelle hilft dir, Aufgabe, Speicher und Lizenz vor dem Download abzugleichen.
Für Containerbetrieb zeigt der Guide zu Ollama mit Docker ein eigenes Setup mit dauerhaftem Modellordner. Wenn dieselben Vorgaben regelmäßig gelten sollen, kannst du mit einer eigenen Modelfile eine benannte Konfiguration anlegen.
Wann sich Ollama für dich eignet
Ein lokaler Modellbetrieb ist interessant, wenn du eine konkrete Aufgabe auf vorhandener Hardware ausprobieren, Anwendungen über eine lokale Schnittstelle verbinden oder dein Setup selbst verwalten möchtest. Dafür übernimmst du auch die Auswahl des Modells, Updates, Speicherverwaltung und die Prüfung der Ergebnisse.
Die Geschwindigkeit und die mögliche Eingabelänge hängen von Modell, Hardware und Konfiguration ab. Beginne deshalb mit einer kleinen Aufgabe auf deinem tatsächlichen Rechner. Allgemeine Tabellen mit Tokens pro Sekunde ersetzen diesen Test nicht, solange Modellvariante, Eingabe und Messbedingungen nicht vergleichbar sind.
Plane auch Speicherplatz, Stromverbrauch und Wartungszeit ein. Lokale Nutzung macht die Infrastrukturkosten nicht automatisch bedeutungslos. Prüfe bei jedem Modell die eigenen Nutzungsbedingungen, insbesondere für Weitergabe oder geschäftliche Verwendung. Die Software und die Modellgewichte können unterschiedlichen Bedingungen unterliegen.
Eine gute erste Entscheidung ist daher konkret: Welche Aufgabe soll die Antwort erfüllen, wie kontrollierst du sie und welcher Betriebsweg passt zu deinen Daten? Daraus folgt die Modellwahl verlässlicher als aus einer pauschalen Empfehlung für „die beste KI“.
Eine erste Notizaufgabe mit klaren Prüfkriterien
Für deinen ersten Versuch hilft eine Aufgabe mit einer bekannten Vorlage. Damit prüfst du etwas Konkretes, statt dich nur auf einen flüssig klingenden Antworttext zu verlassen. Wähle dafür ein zu deinem Rechner passendes lokales Modell. Die folgende Notiz ist vollständig erfunden:
Fasse diese Notiz in zwei Bereiche zusammen: Aufgaben und offene Angaben.
Ordne jede Aufgabe der genannten Person zu. Ergänze keine Termine oder Beträge.
Kennzeichne ausdrücklich, wenn eine Angabe fehlt.

Beschlossen: Mira prüft den Entwurf.
Beschlossen: Leon sammelt zwei Rückfragen.
Offen: Startdatum.
Zum Budget liegt keine Angabe vor.| Prüfpunkt | Was die Vorlage hergibt | Woran du eine Ergänzung erkennst |
|---|---|---|
| Aufgabe 1 | Mira prüft den Entwurf | Andere Person oder neue Zusatzaufgabe |
| Aufgabe 2 | Leon sammelt zwei Rückfragen | Andere Anzahl oder erfundener Termin |
| Startdatum | Offen | Konkretes Datum ohne Beleg |
| Budget | Keine Angabe | Erfundener Geldbetrag |

Bevor du ein Problem der Antwortqualität zuschreibst, unterscheide den Bestand von der laufenden Sitzung. Laut CLI-Referenz zeigt ollama ls die Modellliste; ollama ps zeigt laufende Modelle:
ollama ls
ollama psEine leere Laufzeitliste vor dem ersten Aufruf ist ein anderer Befund als eine fehlende Installation. Notiere beim Versuch den genauen Modellnamen, deine Eingabe und die vier Prüfpunkte. Ein einzelner guter Durchlauf belegt weder eine allgemeine Qualitätsrangfolge noch vollständige Offline-Nutzung der übrigen Anwendung.
Quellen & Methode
Vorgehen und Grenzen
Mit KI recherchierter und erstellter Grundlagenartikel. Vier ausgewählte Suchtreffer wurden vollständig gelesen und verglichen; technische Aussagen wurden mit der aktuellen Herstellerdokumentation abgeglichen. Die Notizaufgabe ist ein eigenes Beispiel. Es wurden hier weder Modellleistung noch Stromverbrauch oder Antwortqualität gemessen. Gezielte Ergänzung vom 21. Oktober 2026: eigenes Prüfmaterial und zusätzliche FAQ auf Basis des vorhandenen Vier-Quellen-Briefings; neue Aussagen anhand der verlinkten Originalreferenzen geprüft. Keine neue vollständige SERP-Erhebung und keine Ausführung einer n8n- oder Ollama-Instanz.
Bei Recherche, Texterstellung und Grafiken wird KI eingesetzt. Welche eigenen Versuche vorliegen und was nur als Beispiel dient, beschreibt dieser Beitrag. Unser Redaktionsstandard erklärt die Anforderungen an Belege und Berichtigungen.