Claude · DeepSeek · OpenAI · Google
Was passt zu deiner Aufgabe?
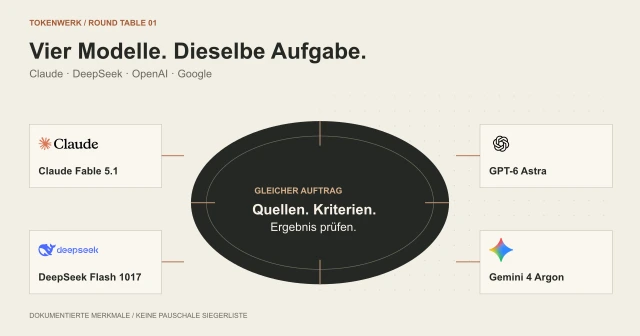
Vier KI-Modelle am gemeinsamen Tisch stellt Claude, DeepSeek, GPT und Gemini mit Vorteilen, Grenzen und Kosten gegenüber.
Technologie verstehen.
Besser entscheiden.
Entscheiden
12 Vergleiche mit klarer Auswahlfrage. Neu dabei: DeepSeek Flash 1017, Gemini 4 Argon, GPT-6 Astra und die aktuellen Claude-Modelle. Prüfe Eingaben, Zugang, Kosten und die Bedingungen deines Einsatzfalls.
Claude · DeepSeek · OpenAI · Google
Vier KI-Modelle am gemeinsamen Tisch stellt Claude, DeepSeek, GPT und Gemini mit Vorteilen, Grenzen und Kosten gegenüber.
Neu · Eingaben & Betrieb
API-Kosten, Eingabeformate und eigener Betrieb: Was den neuen DeepSeek-Checkpoint von Gemini 4 Argon unterscheidet.
Vergleich lesenNeu · Medien & Werkzeuge
Multimodale Eingaben, Kontext, lange Ausgaben und API-Kosten im Vergleich – mit einer klaren Trennung zwischen Modell und Werkzeug.
Vergleich lesenNeu · Recherche & Thinking
Recherche und Agentenarbeit nach Eingaben, Thinking, Integration und Kosten auswählen. Mit einer Aufgabe, die du selbst überprüfen kannst.
Vergleich lesenNeu · Coding & Integration
Coding mit dem neuen DeepSeek-Checkpoint oder Sonnet 5.5: Kosten, offene Gewichte und die Grenzen einer kompatiblen API einordnen.
Vergleich lesenHier stehen weiterhin die bisherigen Versionen gegenüber. Prüfe den jeweiligen Quellenstand; die neuen Modellgenerationen findest du oben.
Modellvergleich
Versionsstand 2026-10-12. Zwei gehostete Modelle mit dokumentierter Bild-Eingabe und Unterstützung für mehrstufige Aufgaben. Google veröffentlicht zusätzlich Audio-, Video- und PDF-Eingabe sowie einen zeitlich begrenzten Einführungspreis; OpenAI dokumentiert zahlreiche Responses-Werkzeuge und einen höheren Tokenpreis.
Vergleich lesen →Modellvergleich
Versionsstand 2026-10-12. Beide sind gehostete APIs mit aktiver Modell-ID. OpenAI veröffentlicht in dieser Datengrundlage konkrete Preis- und Funktionswerte; für Claude Sonnet 5 ist der genaue aktuelle Einheitspreis hier noch nicht bestätigt.
Vergleich lesen →Modellvergleich
Versionsstand 2026-10-12. Zwei gehostete Optionen für anspruchsvolle Aufgaben. Die Anbieter belegen aktive Modelle und lange Kontextgrenzen; die geprüften Preisangaben reichen nur für GPT-5.5 Pro.
Vergleich lesen →Modellvergleich
Versionsstand 2026-10-12. Beide bieten offene Gewichte und damit grundsätzlich lokale Ausführung; konkrete lokale Eignung hängt von Speicher, Quantisierung, Laufzeit und Kontext ab.
Vergleich lesen →Modellvergleich
Versionsstand 2026-10-12. Zwei multimodale offene Gewichtmodelle, deren Hersteller unterschiedliche Angaben zu Kontext und aktiven Parametern veröffentlichen. Lizenz und Hardwareanforderungen müssen je Modell geprüft werden.
Vergleich lesen →Modellvergleich
Versionsstand 2026-10-12. Beide Anbieter dokumentieren ein Million-token-Kontextfenster, Bildverarbeitung und Tool-Funktionen. Preise hängen bei Google von der laufenden Einführungsphase, bei DeepSeek zusätzlich von Cache und UTC-Zeitfenster ab.
Vergleich lesen →Modellvergleich
Versionsstand 2026-10-12. Mistral Large 3 stellt offene Gewichte bereit; GPT-5.5 ist eine gehostete proprietäre API. Das verändert Betriebsoptionen, aber beweist keine allgemeine Qualitäts- oder Kostenvorteile.
Vergleich lesen →Modellvergleich
Versionsstand 2026-10-12. Zwei gehostete multimodale Modelle mit unterschiedlichen Funktions- und Preissnapshots. Mistral beschreibt Medium 3.5 als für agentische Abläufe und Coding optimiert; Google dokumentiert Video-, Audio- und PDF-Eingaben für Flash.
Vergleich lesen →Kontextlänge, Modalitäten und Preis sind nur einzelne Merkmale. Sie zeigen weder Latenz noch Zuverlässigkeit oder Qualität auf deinem Datensatz. Die Quellenlinks führen zu den Anbieterangaben; unbekannte Werte bleiben offen.
Bei lokalen Gewichten zusätzlich Lizenz, Downloadgröße, Quantisierung, Hardware und Runtime prüfen. Bei APIs Werkzeugkosten, Caching, Abopreise und regionale Tarife getrennt berücksichtigen.
Vom Nachlesen zum Anwenden
Die Vergleichsartikel ordnen Herstellerangaben ein. Der Praxistest mit 27 Modellantworten ergänzt konkrete Beobachtungen von GPT, Claude und Gemini: Fakten konnten stimmen, obwohl ein verlangtes Ausgabeformat verfehlt wurde.
Für die anschließende Datenprüfung zeigen acht JSON-Testfälle mit zwei Prüfregeln, warum lesbares JSON und ein eingehaltenes Schema verschiedene Fragen sind. Dieser Offline-Versuch testete Prüfregeln, kein KI-Modell.
Beide Versuche liefen am 22.10.2026 mit künstlichen Eingaben. Protokolle und Grenzen stehen direkt im Beitrag; daraus entsteht keine allgemeine Rangliste.
Die Akademie enthält 12 redaktionelle Gegenüberstellungen. Neu sind konkrete Vergleiche zu DeepSeek Flash 1017, Gemini 4 Argon, GPT-6 Astra, Claude Fable 5.1 und Claude Sonnet 5.5.
Die Seiten vergleichen dokumentierte Merkmale wie Anbieterzugang, Kontext, Modalitäten, bekannte Preise und Grenzen. Ein eigener Leistungstest wird nicht behauptet.
Nein. Die passende Option hängt von Aufgabe, Datenweg, Werkzeugen, Kosten und den Ergebnissen deines eigenen Tests ab.
Nutze dieselben Eingaben, Einstellungen und Prüfkriterien. Halte Modellversion, Datum und Grenzen fest und bewerte Qualität, Laufzeit und Kosten getrennt.