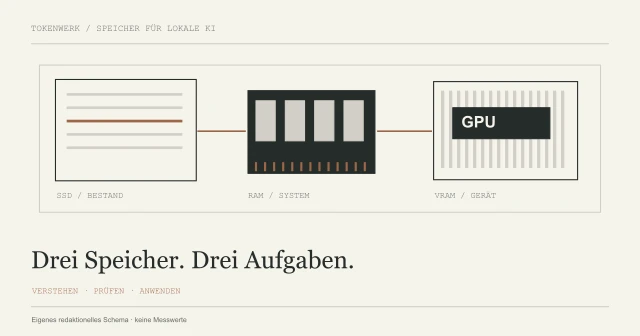
Für eine Sitzung oder native API-Anfrage verwendest du num_ctx; für den Serverstandard gibt es OLLAMA_CONTEXT_LENGTH. Prüfe das geladene Modell mit ollama ps. Ein großer Wert im Modellkatalog und eine lange Eingabe deiner Anwendung belegen noch keinen entsprechend großen aktiven Kontext.
Was in das Kontextfenster gehört
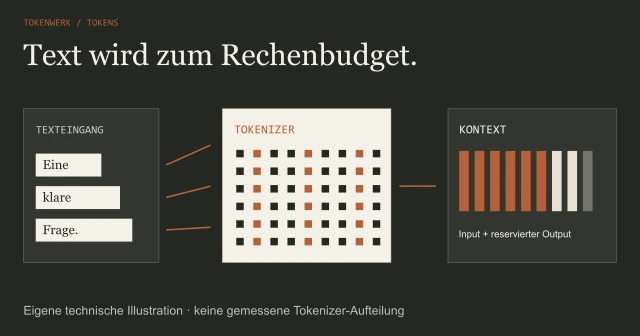
Zum Kontext können Frage, Systemvorgaben, Gesprächsverlauf und beigefügte Quellen oder Werkzeugergebnisse gehören. Tokens sind die Einheiten, in denen das Modell Texte verarbeitet. Ihre Zahl entspricht nicht unmittelbar einer festen Zahl von Wörtern oder Seiten. Die Grundlagen zu Eingabe, Ausgabe und Grenzen findest du unter Kontextfenster allgemein erklärt.
Die Ollama-Kontextdokumentation definiert die Kontextlänge als maximale Zahl der Tokens, auf die das Modell im Speicher zugreifen kann. Bei einer langen Eingabe solltest du auch Platz für die erzeugte Antwort einplanen. Wie eine Anwendung Eingaben kürzt, Historie auswählt oder Informationen nachlädt, ist eine zusätzliche Entscheidung dieser Anwendung.
Unser Beispiel ist ein Notizassistent: Eine kurze Vorgabe, mehrere Sitzungsnotizen und die Frage nach offenen Aufgaben kommen zusammen. Statt nur die letzte Frage zu zählen, prüfst du die gesamten übertragenen Informationen. Die Grafik zeigt diese Bestandteile schematisch; die Flächen sind keine gemessenen Tokenanteile.

Den tatsächlichen Kontext prüfen
Verlasse dich für deinen laufenden Versuch auf den tatsächlich zugewiesenen Wert. Die aktuelle Kontextseite zeigt dafür ollama ps mit den Spalten CONTEXT und PROCESSOR:
ollama psDas Modell muss dafür bereits geladen sein. Prüfe außerdem ollama --version, damit du den Befund einer Version zuordnen kannst. Die Prozessorausgabe hilft beim Einordnen, ob ein Modell vollständig auf der GPU oder teilweise auf der CPU liegt; sie ist keine Geschwindigkeitsmessung.
| VRAM laut Kontextdokumentation | Genannter Standardkontext |
|---|---|
| Unter 24 GiB | 4k |
| 24 bis unter 48 GiB | 32k |
| Ab 48 GiB | 256k |
Die FAQ nennt an ihrer Kontextstelle dagegen 4096 Tokens. Die Dokumentationsstellen sind somit nicht vollständig gleichlautend. Die Tabelle ist keine Zusage für jedes Modell oder jede Version. Prüfe in deinem Setup den aktiven Wert, die Modellunterstützung und die übergebenen Einstellungen.
Vier Wege, den Kontext einzustellen
App oder laufende CLI-Sitzung
Die Kontextdokumentation zeigt einen Regler in den App-Einstellungen. Für eine Sitzung mit ollama run DEIN_MODELL:TAG dokumentiert die FAQ die folgende Anweisung innerhalb des Modellchats:
/set parameter num_ctx 8192DEIN_MODELL:TAG ist ein Platzhalter. Auch 8192 ist hier ein Beispielwert, kein für dich gemessener Optimalwert.
Native API-Anfrage
Speichere diese eigene Anfrage als request.json und ersetze die Modellbezeichnung durch eine vorhandene geeignete Variante:
{
  "model": "DEIN_MODELL:TAG",
  "prompt": "Notiz: Die Lieferung wird geprüft. Wer zuständig ist, bleibt offen. Nenne die Aufgabe und die offene Frage.",
  "stream": false,
  "options": { "num_ctx": 8192 }
}curl http://127.0.0.1:11434/api/generate -H "Content-Type: application/json" --data-binary "@request.json"Unter Windows PowerShell verwende bei Bedarf curl.exe. Das Beispiel gilt für die native Ollama-API. Ein kompatibler Client muss zusätzliche Parameter ausdrücklich unterstützen und weiterreichen; die gleiche JSON-Struktur kann dort nicht automatisch vorausgesetzt werden.
Serverstandard und benannte Variante
Für einen manuell gestarteten Server in einer POSIX-Shell kannst du den Standard mit OLLAMA_CONTEXT_LENGTH=8192 ollama serve setzen. Für eine bereits laufende App oder einen Dienst musst du die Variable an dessen Startweg setzen und Ollama neu starten. Starte keine zusätzliche Instanz auf einer bereits belegten Bindung.
Eine Modelfile kann PARAMETER num_ctx 8192 enthalten. Der Guide zur eigenen Modelfile erklärt das Erstellen und Prüfen einer benannten Variante. Halte serverweite, modellbezogene und anfragebezogene Einstellungen getrennt fest, damit du später erkennst, wo ein Wert vorgegeben wurde.
Mit einer kontrollierten Aufgabe testen
Ein größerer Kontext benötigt laut Hersteller mehr Speicher. Er macht die Antwort nicht automatisch richtiger. Beginne deshalb mit einer Aufgabe, deren Informationen du selbst prüfen kannst, und ändere für einen Vergleich möglichst nur die Kontexteinstellung.
- Notiere Modellvariante, Ollama-Version, Einstellung und tatsächlich angezeigten Kontext.
- Teste eine kurze Notiz mit einer bekannten Aufgabe und einer ausdrücklich fehlenden Angabe.
- Ergänze längere Notizen mit relevanten und irrelevanten Details. Prüfe, ob die entscheidenden Informationen erhalten bleiben.
- Beobachte Speicherbedarf, Laufzeit und Ergebnis. Halte deinen Befund fest, bevor du den nächsten Wert ausprobierst.
Diese Prüfung ist ein eigener Methodenvorschlag. Hier wurden keine Modelle gestartet oder Tokens pro Sekunde gemessen. Wenn die Ausgabe in einen weiteren Workflow eingeht, hilft zusätzlich eine definierte Form wie im Guide zu strukturierten JSON-Antworten. Formprüfung und sachlicher Abgleich erfüllen unterschiedliche Aufgaben.
Gewünschten und zugewiesenen Kontext abgleichen
num_ctx: 8192 in deiner Datei beschreibt einen gewünschten Wert. Ob das richtige laufende Modell diesen Kontext erhalten hat, prüfst du separat. Dafür kannst du die Ausgabe von /api/ps speichern: Sie enthält die aktuell geladenen Modelle und deren context_length. Der folgende Ablauf vergleicht Anforderung und Beobachtung; er misst keine Antwortqualität.

Direkt nach deinem Modellaufruf nachsehen
- Notiere
ollama --version, die genaue Modellkennung samt Tag und den beabsichtigten Wert. Verwende für den Vergleich ein einzelnes Modell und ändere nicht gleichzeitig mehrere Einstellungen. - Führe die oben gezeigte kurze Anfrage mit
num_ctx: 8192selbst aus, sofern Modell und Rechner diesen Beispielwert unterstützen. Das ist keine Empfehlung für jede Hardware. - Speichere unmittelbar danach den beobachteten Zustand und starte den lokalen Vergleich:
curl http://127.0.0.1:11434/api/ps --output ps.json
python kontext-pruefen.py ps.json "DEIN_MODELL:TAG" 8192Zum eigenen Versuch: Lokalen Vergleich herunterladen · Leeres Prüfprotokoll · Fiktive Vergleichsfälle.
Ersetze den Platzhalter durch die genaue Kennung in deiner tatsächlichen Antwort. Ein anderer Tag oder ein inzwischen entladenes Modell darf nicht als bestätigter Kontext gelten. Der Python-Prüfer liest nur die gespeicherte Datei; er ändert weder Ollama-Einstellungen noch Umgebungsvariablen.
Den Befund richtig einordnen
| Befund | Bedeutung | Nächste Prüfung |
|---|---|---|
| wert_bestaetigt | Genau ein passendes Modell meldet den gewünschten Wert. | Die eigentliche Antwort weiter am Ausgangstext prüfen. |
| abweichung_pruefen | Zugewiesener und gewünschter Wert unterscheiden sich. | Modellkennung, Anfrageparameter und tatsächlichen Server kontrollieren. |
| modell_nicht_eindeutig_geladen | Es gibt keinen eindeutigen passenden Eintrag. | Modell erneut bewusst aufrufen und unmittelbar danach prüfen. |
| beobachtung_unpassend | Der erwartete positive Zahlenwert fehlt oder hat den falschen Typ. | Gespeicherte Originalantwort und Ollama-Version ansehen. |
Auch ein größerer zugewiesener Wert führt hier zu abweichung_pruefen. Es geht um einen kontrollierten Vergleich mit genau einer Anforderung, nicht um einen automatischen Wettbewerb um den größten Wert. Die Länge einer konkreten Eingabe und die maximale Kapazität sind außerdem verschiedene Größen. Aus context_length folgt nicht, wie viele Tokens eine bestimmte Antwort tatsächlich sinnvoll genutzt hat.
Den lokalen Kontextprüfer vollständig ansehen
# Liest eine gespeicherte /api/ps-Antwort. Keine API-Anfrage, kein Modellstart.
import json, sys
def check(document, model, requested):
    if type(requested) is not int or requested <= 0 or not isinstance(model, str) or not model.strip():
        return "angaben_unpassend"
    if not isinstance(document, dict) or not isinstance(document.get("models"), list):
        return "api_form_unpassend"
    matches = [m for m in document["models"] if isinstance(m, dict)
               and model in (m.get("name"), m.get("model"))]
    if len(matches) != 1:
        return "modell_nicht_eindeutig_geladen"
    actual = matches[0].get("context_length")
    if type(actual) is not int or actual <= 0:
        return "beobachtung_unpassend"
    return "wert_bestaetigt" if actual == requested else "abweichung_pruefen"
if __name__ == "__main__":
    if len(sys.argv) != 4:
        raise SystemExit('Aufruf: python kontext-pruefen.py ps.json "DEIN_MODELL:TAG" 8192')
    with open(sys.argv[1], encoding="utf-8-sig") as f:
        raw = f.read(1000001)
    if len(raw) > 1000000:
        raise SystemExit("Protokoll zu gross.")
    try:
        data = json.loads(raw)
        requested = int(sys.argv[3])
    except ValueError:
        raise SystemExit("Protokoll ist kein gueltiges JSON.")
    result = check(data, sys.argv[2], requested)
    print(result)
    print("Keine Token-, Speicher-, Geschwindigkeits- oder Qualitaetsmessung.")
    raise SystemExit(0 if result == "wert_bestaetigt" else 1)
Die offizielle API-Referenz zu laufenden Modellen zeigt den Beobachtungspfad. Der Prüfer ist unsere eigene kleine Auswertung dafür. Die herunterladbaren Testfälle sind erfundene Datensätze; für Speicher- und Geschwindigkeitsaussagen wären eigene dokumentierte Messungen nötig.
Wenn die Antwort trotz größerem Kontext scheitert
Prüfe zunächst, ob die Anwendung den gewünschten Parameter tatsächlich sendet und ob der Server ihn für das geladene Modell verwendet. Eine Einstellung in einer Oberfläche kann neben einem eigenen Modellwert oder Serverstandard bestehen. Die Beobachtung im laufenden Setup ist deshalb entscheidend.
Bei Dokumentabläufen sind außerdem Textstücklänge und Modellkontext getrennte Größen. Ein großes Textstück in einer Anwendung vergrößert nicht automatisch den Kontext des nachfolgenden Modells. Vergleiche die gesamte übergebene Anfrage mit dem tatsächlichen Limit.
Wenn relevante Details fehlen, sind mehrere Ursachen möglich: Die Anwendung hat sie schon vor dem Aufruf ausgelassen, der verfügbare Kontext reicht nicht oder das Modell beantwortet die Frage trotz vorhandener Information unzuverlässig. Prüfe diese Möglichkeiten nacheinander an kleinen bekannten Beispielen. So erkennst du eher, ob du die Konfiguration, die Dokumentaufteilung oder die Aufgabe ändern solltest.
Wenn du zusätzlich den Rechner für dein Setup einordnen möchtest, hilft die Speicherplanung für lokale KI. Sie trennt gespeicherte Dateien, laufenden Arbeitsspeicher und Grafikspeicher und zeigt ein eigenes Prüfprotokoll.
Quellen & Methode
Vorgehen und Grenzen
Mit KI recherchierte und erstellte Dokumentationsanleitung. Vier ausgewählte Haupttexte wurden vollständig gelesen und verglichen; technische Aussagen wurden mit aktueller Originaldokumentation abgeglichen. Beispiele und Grafiken sind eigene Erläuterungen. Es wurden hier keine Laufzeiten, Modellantworten oder produktiven Workflow-Ausführungen gemessen. Praxisergänzung vom 21.10.2026: eigene lokale Prüfskripte und konstruierte Positiv-/Negativfälle. Die Offline-Prüfung bewertet die Skriptlogik, keine Modellleistung und keine ausgeführte n8n-Instanz. Aktuelle Belege zur Ergänzung stehen separat in den Quellen.
Bei Recherche, Texterstellung und Grafiken wird KI eingesetzt. Welche eigenen Versuche vorliegen und was nur als Beispiel dient, beschreibt dieser Beitrag. Unser Redaktionsstandard erklärt die Anforderungen an Belege und Berichtigungen.