Text & Reasoning
Claude Opus 5.5
Für umfangreiche Programmieraufgaben und Arbeit mit Dokumenten. Adaptive Thinking ist immer aktiv.
Technologie verstehen.
Besser entscheiden.
 Text & Reasoning
Claude Fable 5.1 verarbeitet Text und Bilder und antwortet mit Text. Anthropic sieht es für aufwendige Recherche und lange Agentenaufgaben vor. Für die Auswahl zählen neben dem Kontextfenster vor allem die höhere Kostenklasse und die Bedingungen zur Datenspeicherung.
Nutze den in den Quellen genannten Anbieterzugang für genau diese Version. Ein Produktabo enthält nicht automatisch API-Guthaben.
Aktiv · aktuelle FamilieQuellenstand 2026-10-24
Anthropic im Verzeichnis
Nachprüfung am 24. Oktober 2026; Herstellerdokumentation, kein eigener Modelltest.
Anthropic hat die API-Version 2026-10-21 und neue SDK-Hauptversionen veröffentlicht. Das ist keine zusätzliche Modellgeneration. Am 22. Oktober kam ein Anthropic-managed-Zugang über Google Cloud hinzu. Prüfe Plattform, API-Vertrag, Modell-ID und Clientversion gemeinsam; vorhandene Praxisaufgaben bleiben darunter erhalten.
Claude-API-Update vom Oktober 2026: Aktuelle SDK-/API-Änderungen von der Modellversion unterscheiden.
Herstellerquelle zum Update · geprüft am 24. Oktober 2026
Identität, Funktionen und Betrieb getrennt lesen. Die Angaben beziehen sich auf diese konkrete Version.
„Nicht bestätigt“ kennzeichnet eine offene Angabe. Es bedeutet weder „nicht vorhanden“ noch „unbegrenzt“.
| Hersteller | Anthropic |
|---|---|
| Modellfamilie | Claude |
| Modell-/API-ID | claude-fable-5-1 |
| Status | Aktiv · aktuelle Familie |
| Modellart | Text & Reasoning |
|---|---|
| Eingabe | Text, Bild |
| Ausgabe | Text |
| Kontext | 1.000.000 Tokens |
|---|---|
| Maximaler Output / Horizont | 128.000 Tokens |
| Bereitstellung | Gehosteter Zugang |
|---|---|
| Gewichte | Gehosteter oder integrierter Zugang |
| Lizenz | Anbieterbedingungen |
Input und Output sind getrennte Texttarife je einer Million Tokens. Preisstufen, Cache, Werkzeuge und weitere Bedingungen stehen im Kostenabschnitt. Kein Preis für eine konkrete Aufgabe.
Datenbasis: Herstellerangaben im Quellenstand 2026-10-24. Quellen zu diesem Profil ↓

Ein möglicher Einsatz ist eine Recherche, bei der mehrere Dokumente zusammengeführt und ihre Widersprüche geprüft werden müssen. Das Modell erhält dafür Material und Werkzeugzugänge; die Anwendung legt fest, welche Quellen und Aktionen erlaubt sind. Aus einer Modell-ID allein entsteht noch kein selbstständiger Arbeitsablauf. Das Vergleichsblatt für KI-Tools hilft dir, Ergebnis, Datenweg und erforderliche Nacharbeit für dieselbe Aufgabe festzuhalten.
Anthropic empfiehlt Opus 5.5 als Ausgangspunkt für die meisten Aufgaben. Fable 5.1 kommt nach dieser Empfehlung infrage, wenn eine anspruchsvolle Aufgabe bei eigenen Prüfungen mit Opus nicht ausreichend gelöst wird. Das ist eine Auswahlstrategie des Herstellers, kein von Tokenwerk gemessener Qualitätsrang.
Adaptive Thinking ist immer aktiv, die voreingestellte Effort-Stufe ist high. Ein Wechsel von Fable 5 betrifft mehr als den Namen: erzwungene Werkzeugaufrufe werden nicht akzeptiert. Außerdem können Änderungen an einer früheren Unterhaltung gespeicherte Thinking-Blöcke ungültig machen. Eine bestehende Agenten-Anwendung sollte deshalb auch mehrere aufeinanderfolgende Schritte prüfen.
Fable 5.1 und Mythos 5.1 haben laut Anthropic dieselben Spezifikationen und Preise, aber unterschiedliche Zugangsbedingungen. Für Fable ist keine Programmzulassung erforderlich. Die dokumentierte Regel zur Datenaufbewahrung beträgt 30 Tage; Ausnahmen für Zero Data Retention benötigen eine ausdrückliche Freigabe von Anthropic.
Im Standardtarif der Claude API kosten eine Million Eingabetokens 10 USD und eine Million Ausgabetokens 50 USD. Cache-Lesezugriffe kosten 0,25 USD je Million Tokens. Das ist eine eigene Tarifkategorie; ein neuer Prompt ist nicht automatisch ein Cache-Treffer.
Rechenbeispiel mit fiktiver Nutzung: 10.000 normale Eingabetokens und 2.000 Ausgabetokens ergeben 0,20 USD. Werkzeuge, zusätzliche Verarbeitung, andere Plattformtarife und Steuern sind dabei nicht enthalten. Einen langen Agentenlauf beurteilst du anhand aller Anfragen und tatsächlich berechneten Tokenkategorien.
Zugang: Gehosteter Zugang. Eine öffentlich dokumentierte Modell-ID bestätigt keine Freischaltung deines Kontos.
Textkosten im Rechner schätzen →Praxisergänzung geprüft am 21. Oktober 2026 · eigene Aufgabe, kein Modellbenchmark
Ein überzeugender Plan darf Arbeitsschritte nicht beliebig sortieren. In diesem fiktiven Pilotprojekt hängt der Start von zwei Vorarbeiten ab. Du prüfst, ob das Modell diese Abhängigkeiten einhält und eine fehlende Abnahme offenlässt. Die Grafik zeigt die Reihenfolge, keine gemessene Modellleistung.
Die Herstellerunterlagen ordnen claude-fable-5-1 anspruchsvollen mehrstufigen Aufgaben zu. Für die Übung reicht ein freigegebener Textzugang. Du benötigst weder Agentenwerkzeuge noch Dateien oder einen laufenden Projektzugriff. Erfasse Modell-ID, Datum und Effort. Die Aufgabe bewertet keine Eignung für ein echtes Produktionsprojekt.
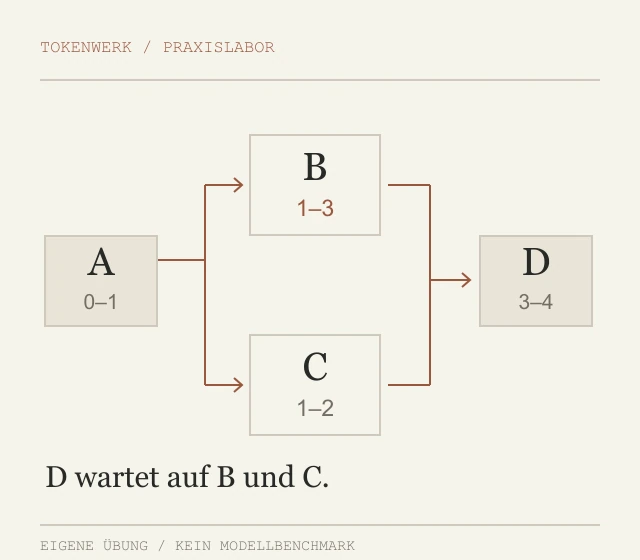
Notiere zunächst selbst: A muss vor B und C liegen; D braucht B und C. Rechne die zwei Zweige getrennt.
Kopiere die Aufgabe. Lass einen Entwurf mit frühestem Start und Ende je Schritt ausgeben.
Prüfe die Zeitrechnung und die offene Abnahme. Ergänze erst nach menschlicher Prüfung weitere echte Projektbedingungen.
Die Angaben sind fiktiv. Speichere den geforderten JSON-Teil der Antwort separat als antwort.json; zusätzliche Erklärungen gehören in eine andere Datei.
Fiktiver Plan, Zeit in ganzen Arbeitstagen ab Tag 0. Unbegrenzte getrennte Teams, B und C dürfen parallel laufen.
A: Daten sichten, Dauer 1, keine Voraussetzung.
B: Testfälle schreiben, Dauer 2, benötigt A.
C: Zugang prüfen, Dauer 1, benötigt A.
D: Pilot ausführen, Dauer 1, benötigt B und C.
Die endgültige fachliche Abnahme ist nicht erteilt.
Gib JSON mit plan als Liste A,B,C,D aus: id, start, ende. Außerdem fruehestes_ende und produktivstart_freigegeben.
Keinen Produktivstart planen und keine Freigabe ergänzen.Vorlage herunterladenLokalen JSON-Prüfer herunterladen
{
  "plan": [
    {
      "id": "A",
      "start": 0,
      "ende": 1
    },
    {
      "id": "B",
      "start": 1,
      "ende": 3
    },
    {
      "id": "C",
      "start": 1,
      "ende": 2
    },
    {
      "id": "D",
      "start": 3,
      "ende": 4
    }
  ],
  "fruehestes_ende": 4,
  "produktivstart_freigegeben": false
}Das Soll ist redaktionell aus der Vorlage abgeleitet, keine aufgezeichnete Modellantwort. Der lokale Prüfer vergleicht die festgelegten Felder und führt keinen generierten Code oder API-Aufruf aus. Er bewertet keine freien Begründungen.
Speichere Prüfer und deine Antwort im selben Ordner. Mit installiertem Python: python pruefen.py antwort.json.
| Beobachtung | Was du prüfst |
|---|---|
| D beginnt bereits an Tag 2 | Prüfe beide Voraussetzungen: D wartet auch auf B, nicht nur auf C. |
| Die vier Dauern werden einfach addiert | B und C laufen laut Vorlage parallel. Die Summe aller Dauern ist hier nicht die Projektdauer. |
| Ein Produktivstart wird als freigegeben markiert | Trenne berechneten Zeitplan von der noch ausstehenden fachlichen Entscheidung. |
Übertrage die Planungslogik auf ein eigenes Vorhaben und lerne, wie du ein KI-Pilotprojekt abgrenzen kannst.
Falls du später Schritte automatisierst, solltest du Agenten mit begrenzten Rechten einsetzen und die Abnahme separat festlegen.
Gezielte Praxisergänzung auf Basis aktueller Herstellerunterlagen. Der Datenstand der bisherigen Modell-Faktentabellen bleibt separat ausgewiesen. Neue Beispiele und Grafiken sind eigene Erklärungen; es wurden keine Modellantworten oder Leistungswerte gemessen.
Herstellerunterlagen zur Ergänzung: Claude Fable 5.1 - Claude Platform Docs (Abruf 2026-10-21) · What's new in Claude Fable 5.1 - Claude Platform Docs (Abruf 2026-10-21).
Die verlinkten Herstellerunterlagen wurden für dieses Profil ausgewertet. Ältere Versionen und Einführungstexte dienen der Einordnung; aktuelle technische Angaben haben Vorrang. Abrufdaten stehen an den Quellen. Die Grafik ist redaktionell, kein Leistungstest.
Ein gehostetes Anthropic-Modell für Textantworten auf Text- und Bildeingaben. Die Claude-API-ID lautet claude-fable-5-1; dokumentiert sind ein Kontextfenster von einer Million Tokens und maximal 128.000 Ausgabetokens.
Adaptive Thinking ist immer aktiv. Die Voreinstellung für Effort ist high. Die technische Dokumentation beschreibt Effort als Steuerung; thinking.type disabled und manuelle Thinking-Budgets werden nicht akzeptiert.
Anthropic dokumentiert dieselben Spezifikationen und Preise. Mythos 5.1 verlangt eine verifizierte Organisation, Fable 5.1 keine entsprechende Programmzulassung. Zugang und erlaubte Nutzung musst du getrennt prüfen.
Claude API, Standardtarif: 10 USD je Million Eingabetokens und 50 USD je Million Ausgabetokens. Cache, Batch, Werkzeuge und besondere Verarbeitung haben eigene Preisregeln. Ein Claude-Abonnement ist keine Angabe zum Preis einer API-Anfrage.
Nein. Die Seite ordnet Herstellerangaben ein und enthält eine noch nicht ausgeführte Übung. Die Ablaufgrafik ist redaktionell erstellt und zeigt keine gemessenen Ergebnisse.
Im dokumentierten Quellenstand: 1.000.000 Tokens. Beachte die Bedingungen der konkreten Modellversion und des verwendeten Endpunkts. Kontext ist keine Wortzahl und kein Nachweis, dass jede enthaltene Information zuverlässig verarbeitet wird.
Lege eine kleine Aufgabe mit bekanntem oder nachprüfbarem Ergebnis fest. Notiere Version, Eingabe und Einstellungen. Vergleiche die Ausgabe mit deinem Prüfkriterium und halte Fehler sowie tatsächliche Kosten getrennt fest. Die Testidee auf dieser Seite ist ein Vorschlag und wurde hier nicht als Modelltest ausgeführt.
Sie prüft vier feste Abhängigkeiten, Parallelität und eine ausdrücklich fehlende Freigabe. Das Soll ist redaktionell berechnet und kein aufgezeichnetes Ergebnis von Claude Fable.
Nein. Vier Tage ergeben sich nur aus den erfundenen Dauern und unbegrenzten getrennten Teams in dieser Vorlage. Eigene Ressourcen, Risiken und Freigaben musst du separat planen.
Nein. Der Auftrag ist eine reine Textaufgabe. Zusätzliche Werkzeugrechte helfen hier nicht beim Prüfen der Abhängigkeiten.
Text & Reasoning
Für umfangreiche Programmieraufgaben und Arbeit mit Dokumenten. Adaptive Thinking ist immer aktiv.
Text & Reasoning
Für Text-, Programmier- und Werkzeugaufgaben mit einstellbarem Thinking.
Text & Reasoning
Für Klassifikation, Extraktion, Routing und häufig wiederholte Aufgaben.