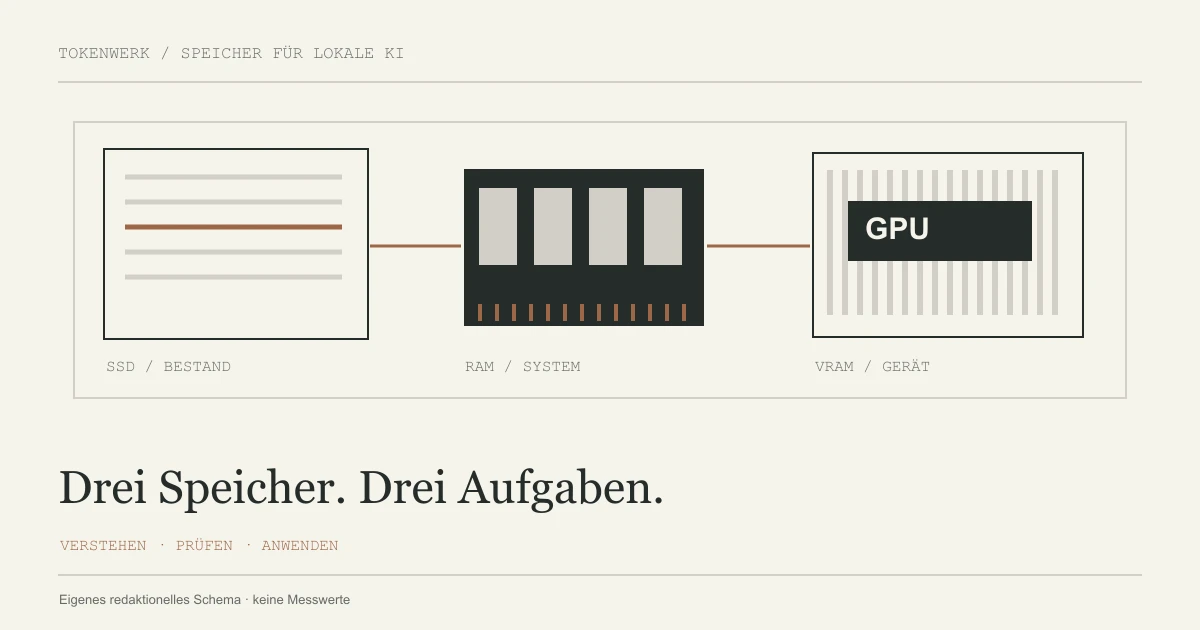
Es gibt keine allgemeine RAM-Zahl für lokale KI. Prüfe die genaue Modelldatei, die Unterstützung deiner Laufzeit und den freien Speicher während deiner Aufgabe. Eine passende Datei auf der SSD beweist noch nicht, dass das Modell mit dem gewünschten Kontext im Arbeitsspeicher oder auf der GPU läuft.
RAM, VRAM und SSD erfüllen verschiedene Aufgaben
Auf der SSD liegen deine gespeicherten Modelldateien. RAM ist der Arbeitsspeicher für Betriebssystem und laufende Programme. Eine diskrete Grafikkarte besitzt zusätzlich eigenen Speicher, den VRAM. Bei gemeinsamem Speicher teilen sich CPU und GPU Ressourcen; diese Architektur sollte nicht wie zwei beliebig addierbare Speicherlisten behandelt werden. Ein konkretes Beispiel ist die Speicherplanung am Mac mini.
Für Ollama zeigt die Hersteller-FAQ, ob ein geladenes Modell ganz auf der GPU, im Systemspeicher oder verteilt liegt. Das beantwortet die Speicherzuordnung, aber noch keine Frage nach Antwortqualität oder Geschwindigkeit. Die drei Bereiche in der Grafik sind deshalb ein Ordnungsschema, keine gemessenen Größenverhältnisse.

Die Modellvariante ist der Ausgangspunkt
Notiere die vollständige Modellbezeichnung, den Dateinamen beziehungsweise Tag und die Quantisierung. Zwei Varianten derselben Modellfamilie können unterschiedliche Dateien und Anforderungen haben. Bei GGUF stehen neben Tensoren auch Metadaten in der Datei; Hugging Face erklärt die Anzeige dieser Informationen.
Zum laufenden Modell kommen Kontext und weitere Anwendungen. Die Ollama-Dokumentation weist ausdrücklich darauf hin, dass ein größeres Kontextfenster mehr Speicher benötigt. Für mehrere gleichzeitig laufende Anfragen nennt die FAQ zusätzlichen Kontextbedarf. Plane also für deine tatsächliche Nutzung: kurze Einzelanfrage, längeres Dokument oder parallele Verarbeitung.
Die Anleitung zum Ollama-Kontextfenster zeigt, wie du den aktiven Wert prüfst. Der maximal beworbene Modellkontext und der in deinem Versuch zugewiesene Wert sind unterschiedliche Angaben.
Eine Bestandsaufnahme vor dem Download
Erstelle eine kleine Inventur. Erfasse nicht nur den eingebauten Speicher, sondern auch, was vor dem Laden frei ist. Browser, Entwicklungsumgebung, andere Modelle und der Desktop können ebenfalls Ressourcen belegen. Halte die verwendete Anzeige fest, damit du später nicht Werte verschiedener Speicherarten oder Einheiten vergleichst.
| Frage | Was du festhältst | Was daraus noch nicht folgt |
|---|---|---|
| Welche Variante? | Vollständiger Modellname, Dateigröße, Quantisierung | Keine Zusage für Laufzeitspeicher |
| Welche Laufzeit? | Version, Betriebssystem, unterstütztes GPU-Backend | Keine Zusage für jede Funktion |
| Wie viel frei? | RAM/VRAM vor und während der Aufgabe, jeweils mit Einheit | Keine automatisch gemessene Modellqualität |
| Welche Nutzung? | Aktiver Kontext und gleichzeitige Anfragen | Keine allgemeine Mehrbenutzer-Kapazität |
Ein kleiner Prüfversuch mit Protokoll
Verwende für den ersten Versuch eine kurze, unkritische Aufgabe mit bekanntem Ergebnis. Du könntest eine selbst geschriebene Liste aus drei Gegenständen alphabetisch ordnen lassen. Ein flüssiger Text allein wäre kein ausreichendes Prüfkriterium: Die Ausgabe muss dieselben Gegenstände enthalten und darf keine hinzufügen.
- Notiere Version und genaue Modellvariante vor dem Start.
- Lade die vorhandene Variante und führe die kleine Aufgabe aus.
- Prüfe bei Ollama mit
ollama psdie geladene Variante, den Kontext und PROCESSOR. - Erfasse Speicher und Wartezeit mit derselben Methode. Wiederhole eine vergleichbare Anfrage, um Start- und Folgebetrieb nicht zu vermischen.
- Teste anschließend die längere Eingabe, die du wirklich verwenden möchtest. Ändere dabei möglichst nur eine Einstellung.
Dieses Protokoll ist ein Vorschlag für deinen eigenen Versuch. Für diesen Artikel wurden keine Modelle auf bestimmter Hardware gestartet und keine Tokens pro Sekunde gemessen.
Welcher Engpass verlangt welche Änderung?
Wähle die nächste Änderung anhand des Befunds. Ein fehlgeschlagener Download ist ein anderes Problem als ein Modell, das nur teilweise auf die GPU passt. Eine falsche Antwort wird nicht allein durch mehr VRAM richtig. Die Auswahl lokaler KI-Modelle verbindet diese Speicherprüfung mit Aufgabe, Format und Lizenz der konkreten Variante.
| Befund | Sinnvoller nächster Schritt |
|---|---|
| Dateien passen nicht auf den Datenträger | Bestand, Speicherort und benötigte Varianten prüfen |
| Treiber oder GPU werden nicht erkannt | Betriebssystem, Backend und Laufzeitunterstützung abgleichen |
| Laufender Bedarf ist zu groß | Kontext, parallele Nutzung und kleinere Variante einzeln testen |
| Ausgabe erfüllt die Aufgabe nicht | Aufgabe und Modellwahl mit bekannten Beispielen prüfen |
Eine kleinere Datei kann durch KI-Quantisierung entstehen. Ob sie deine Aufgabe noch ausreichend löst, musst du mit derselben Prüfung beurteilen. Dokumentiere diesen Befund vor einer Kaufentscheidung.
Was dieser Guide nicht berechnet
Dieser Guide dimensioniert die Nutzung fertiger Sprachmodelle, nicht das Training eines neuen Modells. Er gibt auch keine allgemeine Mindestkonfiguration, keinen Stromkostenvorteil und keine Preisempfehlung für eine Grafikkarte vor. Solche Aussagen brauchen eine konkrete Konfiguration und passende Messungen.
Für deinen nächsten Schritt findest du in der Hardware-Übersicht die Guides zu Quantisierung und GPU-Betrieb. Bewahre die Inventur auf: Bei einem neuen Modell, längeren Kontext oder geänderten Workflow kannst du dieselben Fragen erneut prüfen.
Quellen & Methode
Vorgehen und Grenzen
Dieser Artikel wurde mit KI-Unterstützung aus den verlinkten Originalunterlagen erstellt. Grafiken, Rechen- und Textbeispiele sind eigene, ausdrücklich gekennzeichnete Darstellungen. Es wurden dafür keine Modelle gestartet, Hardwaremessungen oder Angriffstests durchgeführt. Dokumentationen können sich ändern; prüfe die Quelle für deine Version.
Bei Recherche, Texterstellung und Grafiken wird KI eingesetzt. Welche eigenen Versuche vorliegen und was nur als Beispiel dient, beschreibt dieser Beitrag. Unser Redaktionsstandard erklärt die Anforderungen an Belege und Berichtigungen.