Hardware / Guide
LLM-Geschwindigkeit messen: mehr als Rechenleistung
LLM-Geschwindigkeit nachvollziehbar messen: erstes Token, Gesamtdauer, Durchsatz und Speicher getrennt prüfen. Mit Messvorlage und klaren Grenzen.
Technologie verstehen.
Besser entscheiden.
Speicherbedarf einordnen, Modellvarianten prüfen und GPU-Betrieb nachvollziehen.
Speicher planen, Varianten wählen, GPU prüfen.
LLM-Geschwindigkeit nachvollziehbar messen: erstes Token, Gesamtdauer, Durchsatz und Speicher getrennt prüfen. Mit Messvorlage und klaren Grenzen.
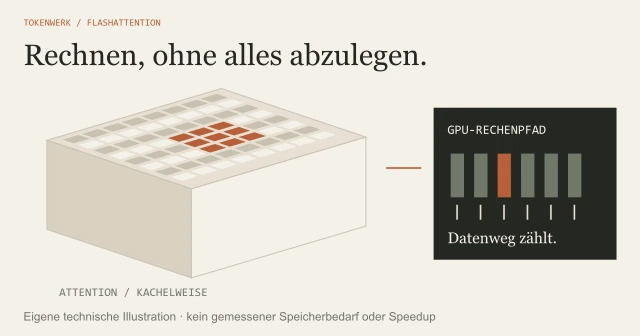
FlashAttention verständlich erklärt: Kacheln, Speicherzugriff, FA2 bis FA4 und PyTorch SDPA. Mit nachrechenbarem Beispiel und klaren Hardwaregrenzen.
Mac mini für lokale KI einordnen: aktuelle Speicheroptionen, Modellgewichte, Kontext, Ollama und MLX. Mit eigener Rechenhilfe und einem Bedarfsblatt.
Welche Grafikkarte passt zu lokaler KI? Prüfe Modell, VRAM, Betriebssystem und Laufzeit. Mit transparenter Speicherrechnung und einem eigenen Bedarfszettel.
Was eine NPU macht, wie sie sich von CPU und GPU unterscheidet und wann Software sie nutzt. Mit TOPS-Einordnung, Kompatibilitätskette und Rechnercheck.
Was sagen KI-Benchmarks aus? Unterscheide Richtigkeit, Präferenz, Tempo und Indizes. Mit Methodenkarte und eigenem Prüffall statt pauschaler Rangliste.
RAM, VRAM und Modelldateien einordnen und Varianten an derselben Aufgabe prüfen.
Die Modellzuordnung prüfen und nativen Betrieb von Container-Zugriff unterscheiden.
Aktiven Kontext beobachten und gespeicherte Modelle gezielt verwalten.
Du kannst lokale Gewichte und Laufzeit unterscheiden, ein Modell passend auswählen und den Betrieb nachvollziehbar prüfen.
Lernpfad ansehen
Du liest Benchmarks nach Methode und Bedingungen und triffst eine begründete Auswahl für deinen Einsatz.
Lernpfad ansehenOllama mit Docker Compose einrichten: Modelle dauerhaft speichern, Portzugriff begrenzen und CPU- oder GPU-Betrieb prüfen. Mit Konfiguration und Fehlersuche.
Ollama-Kontextfenster mit num_ctx oder OLLAMA_CONTEXT_LENGTH einstellen und den tatsächlichen Wert prüfen. Mit API-Beispiel, Grafik und Speicherabwägung.
Ollama-Modelle gezielt mit ollama rm löschen: Namen prüfen, laufende Modelle stoppen und das Ergebnis kontrollieren. Mit Befehlen und Fehlersuche.
Die Beiträge nennen ihre Quellen und unterscheiden Herstellerangaben, eigene Beispiele und tatsächlich durchgeführte Prüfungen.
Unser Redaktionsstandard →Speicher, Chips, Rechenleistung, Energie und die Infrastruktur für lokale KI.
LLM-Geschwindigkeit messen: mehr als Rechenleistung: LLM-Geschwindigkeit nachvollziehbar messen: erstes Token, Gesamtdauer, Durchsatz und Speicher getrennt prüfen. Mit Messvorlage und klaren Grenzen. FlashAttention erklärt: Warum der Speicherzugriff zählt: FlashAttention verständlich erklärt: Kacheln, Speicherzugriff, FA2 bis FA4 und PyTorch SDPA. Mit nachrechenbarem Beispiel und klaren Hardwaregrenzen. Mac mini für lokale KI: Speicher wählen und den eigenen Ablauf prüfen: Mac mini für lokale KI einordnen: aktuelle Speicheroptionen, Modellgewichte, Kontext, Ollama und MLX. Mit eigener Rechenhilfe und einem Bedarfsblatt.
Wähle einen Beitrag nach deiner konkreten Frage. Guides führen durch praktische Schritte; Hintergrundartikel ordnen Zusammenhänge und Grenzen ein.