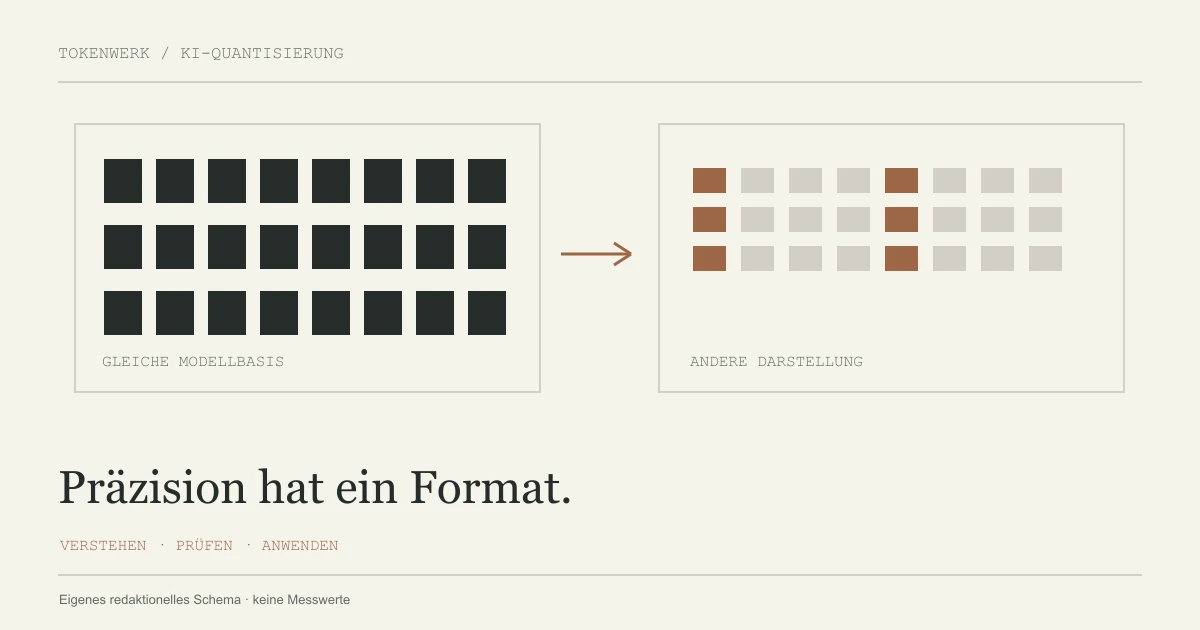
GGUF ist ein Dateiformat; Quantisierung ist eine Veränderung der Präzision. Ein Kürzel wie Q4_K_M beschreibt eine Variante, keinen allgemeinen Qualitätsrang. Vergleiche dieselbe Modellbasis mit derselben Aufgabe und plane Kontext sowie Laufzeit zusätzlich zu den Gewichten ein.
Quantisierung und GGUF sind unterschiedliche Dinge
Quantisierung betrifft die numerische Darstellung der Gewichte; GGUF ist ein Dateiformat für Tensoren und Metadaten. Eine GGUF-Datei legt daher nicht automatisch eine bestimmte Quantisierung fest. Ein Modell enthält viele numerische Gewichte. Quantisierung bildet diese mit weniger beziehungsweise anders verteilten Präzisionsbits ab. Die llama.cpp-Dokumentation beschreibt kleinere Modelldateien und mögliche Genauigkeitsverluste. Eine Beschleunigung ist möglich, aber keine Zusage für jede Hardware und Aufgabe.
GGUF speichert Tensoren und Metadaten in einem binären Modellformat. Laut Hugging Face kann ein ursprünglich in einem anderen Framework entwickeltes Modell dafür konvertiert werden. Ein GGUF-Modell muss nicht dieselbe Präzision wie ein anderes GGUF-Modell besitzen.

Was Q4_K_M und Q8_0 verraten
| Angabe | Was sie einordnet | Was sie nicht beweist |
|---|---|---|
| GGUF | Dateiformat mit Tensoren und Metadaten | Eine feste Quantisierung oder Antwortqualität |
| Q4_K_M | K-Quant-Variante mit gemischter Präzisionsverteilung | Exakt vier Bits für jeden Parameter |
| Q8_0 | Eine andere dokumentierte Quantisierungsvariante | Fehlerfreie Antworten |
| F16 / BF16 | Gleitkommaformate mit anderer Darstellung | Eignung für jede Laufzeit und Aufgabe |
Bei der Auswahl begegnen dir Namen wie Q4_K_M oder Q8_0. Lies sie als konkrete Format- und Variantenangaben. Die Zahl bezeichnet nicht die exakte durchschnittliche Bitzahl jeder gesamten Datei: zusätzliche Informationen und unterschiedliche Tensorarten beeinflussen die Größe.
Die offiziellen Tabellen führen beispielsweise für den Tensor-Typ Q4_K zusätzliche Skalierungsinformationen an. Auch llama-quantize kennt Mischungen und Optionen für einzelne Tensoren. Verwende deshalb die tatsächliche Dateigröße und ihre Metadaten, nicht nur die erste Ziffer im Namen.
Eine Rechnung nur für die Gewichte
Eine eigene Idealrechnung macht den Unterschied sichtbar. Stell dir sechs Milliarden Gewichte vor, die alle gleich gespeichert würden. Dann gilt für den reinen Zahlenbestand: Anzahl × Bits ÷ 8 = Bytes. Die Rechnung benutzt dezimale GB und enthält weder Metadaten noch Kontext, Puffer oder andere Programme.
| Annahme | Reiner Zahlenbestand |
|---|---|
| 16 Bit pro Wert | 12 GB |
| 8 Bit pro Wert | 6 GB |
| 4 Bit pro Wert | 3 GB |
Diese Werte sind keine realen GGUF-Dateigrößen und keine VRAM-Empfehlung. Eine gemischte Quantisierung folgt nicht exakt dieser einfachen Annahme. Zum Einordnen des gesamten Rechners gehört die Speicherplanung für lokale KI.
Zwei Varianten derselben Aufgabe gegenüberstellen
Eine brauchbare Auswahl beginnt mit einer Aufgabe, deren erwartetes Ergebnis feststeht. Du könntest aus eigenen Veranstaltungsnotizen Datum, Ort und offene Fragen extrahieren lassen. Lege vorher fest, welche Angaben wirklich enthalten sind und welche offen bleiben müssen.
- Wähle Varianten derselben Modellbasis; ändere nicht gleichzeitig Modellfamilie und Quantisierung.
- Halte Eingabe, Aufgabenformulierung und Kontexteinstellung konstant.
- Vergleiche richtige Angaben, Ergänzungen, ausgelassene Informationen und gewünschte Ausgabeform.
- Erfasse Speicher und Laufzeit mit derselben Methode; trenne Laden und anschließende Ausführung.
- Entscheide anhand deiner notwendigen Qualität und der verfügbaren Ressourcen.
Eine Variante, die weniger Speicher braucht, kann für eine Aufgabe ausreichend und für eine andere ungeeignet sein. Ein einzelner gelungener Satz ersetzt deshalb keinen kleinen Satz an unterschiedlichen Testeingaben.
Vorhandene Variante laden und prüfen
Prüfe vor dem Download Herkunft, genaue Basis, Lizenz und die Unterstützung durch deine Laufzeit. Vorbereitete GGUF-Dateien müssen nicht mit einem beliebigen Quantisierungswerkzeug erneut bearbeitet werden. Eine fremde Anleitung für ein anderes Dateiformat lässt sich nicht automatisch übertragen.
Bei einer eigenen Ollama-Konfiguration beschreibt die Modelfile-Anleitung, wie du eine Basis und Vorgaben festhältst. Ein neuer Name oder Systemprompt trainiert die Gewichte nicht neu und stellt auch nicht automatisch eine andere Quantisierung her. Notiere die tatsächlich verwendete Modelldatei beziehungsweise den vollständigen Tag.
Weniger Speicher ist keine Qualitätsgarantie
Gewichtsquantisierung und Quantisierung des Kontextcaches betreffen unterschiedliche Daten. Die Ollama-FAQ dokumentiert Cache-Optionen separat. Ein Wechsel an dieser Stelle muss deshalb als eigene Konfigurationsänderung geprüft werden.
Eine allgemeine Aussage wie „Q4 verliert immer weniger als ein Prozent“ ist ohne Modell, Aufgabe und Messmethode nicht belastbar. Die llama.cpp-Unterlagen zeigen beispielhafte Größen- und Laufzeitwerte für eine benannte Modellbasis; daraus folgt kein universeller Qualitätsrang. Die Verfahren und Kürzel können sich ebenfalls verändern.
Behalte bei der Wahl den aktiven Kontext im Blick. Ein quantisiertes Modell lässt nicht automatisch beliebig lange Eingaben zu. Weitere Praxis-Guides findest du im Ressort Hardware.
Quellen & Methode
Vorgehen und Grenzen
Dieser Artikel wurde mit KI-Unterstützung aus den verlinkten Originalunterlagen erstellt. Grafiken, Rechen- und Textbeispiele sind eigene, ausdrücklich gekennzeichnete Darstellungen. Es wurden dafür keine Modelle gestartet, Hardwaremessungen oder Angriffstests durchgeführt. Dokumentationen können sich ändern; prüfe die Quelle für deine Version.
Bei Recherche, Texterstellung und Grafiken wird KI eingesetzt. Welche eigenen Versuche vorliegen und was nur als Beispiel dient, beschreibt dieser Beitrag. Unser Redaktionsstandard erklärt die Anforderungen an Belege und Berichtigungen.