Text & Reasoning
Claude Fable 5.1
Für aufwendige Analyse, Recherche und lange Agentenabläufe. Adaptive Thinking bleibt immer aktiv.
Technologie verstehen.
Besser entscheiden.
 Text & Reasoning
Claude Opus 5.5 ist Anthropic zufolge für umfangreiche Programmier- und Dokumentenaufgaben vorgesehen. Es verarbeitet Text und Bilder und gibt Text aus. Dieses Profil erklärt den Standardtarif, die aktuelle API-ID und die Änderungen, die bestehende Anwendungen betreffen.
Nutze den in den Quellen genannten Anbieterzugang für genau diese Version. Ein Produktabo enthält nicht automatisch API-Guthaben.
Aktiv · aktuelle FamilieQuellenstand 2026-10-24
Anthropic im Verzeichnis
Nachprüfung am 24. Oktober 2026; Herstellerdokumentation, kein eigener Modelltest.
Anthropic hat die API-Version 2026-10-21 und neue SDK-Hauptversionen veröffentlicht. Das ist keine zusätzliche Modellgeneration. Am 22. Oktober kam ein Anthropic-managed-Zugang über Google Cloud hinzu. Prüfe Plattform, API-Vertrag, Modell-ID und Clientversion gemeinsam; vorhandene Praxisaufgaben bleiben darunter erhalten.
Claude-API-Update vom Oktober 2026: Aktuelle SDK-/API-Änderungen von der Modellversion unterscheiden.
Herstellerquelle zum Update · geprüft am 24. Oktober 2026
Identität, Funktionen und Betrieb getrennt lesen. Die Angaben beziehen sich auf diese konkrete Version.
„Nicht bestätigt“ kennzeichnet eine offene Angabe. Es bedeutet weder „nicht vorhanden“ noch „unbegrenzt“.
| Hersteller | Anthropic |
|---|---|
| Modellfamilie | Claude |
| Modell-/API-ID | claude-opus-5-5 |
| Status | Aktiv · aktuelle Familie |
| Modellart | Text & Reasoning |
|---|---|
| Eingabe | Text, Bild |
| Ausgabe | Text |
| Kontext | 1.000.000 Tokens |
|---|---|
| Maximaler Output / Horizont | 128.000 Tokens |
| Bereitstellung | Gehosteter Zugang |
|---|---|
| Gewichte | Gehosteter oder integrierter Zugang |
| Lizenz | Anbieterbedingungen |
Input und Output sind getrennte Texttarife je einer Million Tokens. Preisstufen, Cache, Werkzeuge und weitere Bedingungen stehen im Kostenabschnitt. Kein Preis für eine konkrete Aufgabe.
Datenbasis: Herstellerangaben im Quellenstand 2026-10-24. Quellen zu diesem Profil ↓

Bei einer größeren Codeänderung reicht eine plausible Erklärung nicht. Ein sinnvoller Einsatz verbindet Opus 5.5 mit einem klaren Auftrag, einem abgegrenzten Arbeitsbereich und Tests, deren erwartete Ergebnisse vorher feststehen. Anthropic nennt auch komplexe Dokumente und Agentenaufgaben als Einsatzgebiete. Wie zuverlässig das für dein Projekt funktioniert, muss dein eigener Test zeigen. Das Vergleichsblatt für KI-Tools hilft dir, Ergebnis, Datenweg und erforderliche Nacharbeit für dieselbe Aufgabe festzuhalten.
Die konkrete Claude-API-ID ist claude-opus-5-5. Gegenüber Opus 5 sinken die Standardpreise pro Token von 5/25 auf 4/20 USD je Million Eingabe-/Ausgabetokens. Daraus folgt nicht automatisch dieselbe Ersparnis pro Aufgabe: Wiederholungen, Thinking, Werkzeuge und die Länge der Antworten beeinflussen die Gesamtkosten.
Adaptive Thinking bleibt bei Opus 5.5 immer aktiv; die voreingestellte Effort-Stufe ist medium. Alte Anfragen mit deaktiviertem Thinking oder erzwungener Werkzeugwahl müssen angepasst werden. Auf Claude API und Google Cloud wird außerdem der ältere Computer-Use-Werkzeugtyp computer_20251124 nicht mehr akzeptiert. Die Bedrock-Regeln unterscheiden sich an dieser Stelle.
Auch eine technisch erfolgreiche Antwort kann in der Oberfläche anders aussehen. Zwischenmeldungen bei Werkzeugaufrufen können als Thinking-Blöcke zurückkommen und in der Standardanzeige leer bleiben. Wer sie im eigenen Produkt zeigt, sollte die Anzeigeeinstellung und die Verarbeitung der Inhaltstypen prüfen.
Stand 24. Oktober 2026
Claude API Standard: 4 USD Input/20 USD Output je Million Tokens. Fast Mode hat eigene Tarife; Standardpreis nicht auf Fast-Mode-Anfragen übertragen.
Bereitstellung: Gehosteter Zugang. Prüfe vor Nutzung die tatsächliche Freischaltung, Region und Sondertarife. Die Quelldokumentation steht unter „Quellen“.
Praxisergänzung geprüft am 21. Oktober 2026 · eigene Aufgabe, kein Modellbenchmark
Bei Coding-Aufgaben ist ein vollständiger Neubau häufig schwerer zu prüfen als eine begrenzte Korrektur. Diese Übung beginnt deshalb mit einer kurzen Funktion und drei klaren Randfällen. Lass Opus zuerst erklären, welches Verhalten falsch ist. Der vorgeschlagene Patch bleibt ein Vorschlag, bis du ihn gelesen und in deinem eigenen Übungsprojekt geprüft hast.
Die Claude-API-ID lautet claude-opus-5-5. Anthropic beschreibt bei dieser Version dauerhaft aktives Adaptive Thinking und Änderungen an älteren Werkzeugaufrufen. Für die Textaufgabe hier brauchst du keine Werkzeugrechte. Wenn du einen Coding-Agenten verwendest, begrenze ihn auf einen Übungsordner und prüfe sowohl die Änderungen als auch die tatsächlichen Testausgaben.
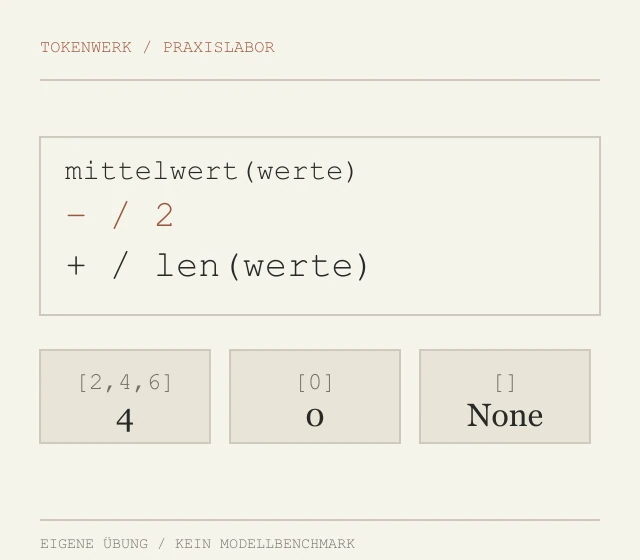
Kopiere Funktion und Vertrag gemeinsam. Fordere eine kleine Änderung statt eines neuen Programms.
Prüfe den Patch zunächst als Text. Die zusätzlich gelieferte JSON-Tabelle kann der lokale Prüfer kontrollieren, ohne Modellcode auszuführen.
Übertrage einen akzeptierten Patch bewusst in dein Übungsprojekt und führe die drei Fälle dort aus.
Die Angaben sind fiktiv. Speichere den geforderten JSON-Teil der Antwort separat als antwort.json; zusätzliche Erklärungen gehören in eine andere Datei.
Fiktive Python-Funktion:
def mittelwert(werte):
    return sum(werte) / 2

Vertrag: arithmetischer Mittelwert; leere Liste ergibt None. Keine weiteren Funktionen oder Abhängigkeiten.
Erkläre den Fehler und schlage einen minimalen Patch als Text vor. Führe nichts aus.
Gib zusätzlich eine getrennte JSON-Prüftabelle aus:
{"ergebnisse": [{"eingabe": [2, 4, 6], "soll": ...}, {"eingabe": [0], "soll": ...}, {"eingabe": [], "soll": ...}]}.
Die Werte in der Prüftabelle müssen aus dem Vertrag folgen, nicht aus dem fehlerhaften Code.Vorlage herunterladenLokalen JSON-Prüfer herunterladen
{
  "ergebnisse": [
    {
      "eingabe": [
        2,
        4,
        6
      ],
      "soll": 4
    },
    {
      "eingabe": [
        0
      ],
      "soll": 0
    },
    {
      "eingabe": [],
      "soll": null
    }
  ]
}Das Soll ist redaktionell aus der Vorlage abgeleitet, keine aufgezeichnete Modellantwort. Der lokale Prüfer vergleicht die festgelegten Felder und führt keinen generierten Code oder API-Aufruf aus. Er bewertet keine freien Begründungen.
Speichere Prüfer und deine Antwort im selben Ordner. Mit installiertem Python: python pruefen.py antwort.json.
| Beobachtung | Was du prüfst |
|---|---|
| Nur der Beispielwert passt | Eine fest eingebaute Zahl löst den allgemeinen Vertrag nicht. |
| Leere Liste löst Division durch null aus | Der Randfall wurde nicht vor der Rechnung behandelt. |
| Der Agent behauptet bestandene Tests | Verlange das echte Testprotokoll; eine Behauptung ist keine Ausführung. |
Den Ablauf von Auftrag, Diff und Test vertieft der Lernpfad mit KI programmieren und Änderungen prüfen an kleinen kontrollierbaren Aufgaben.
Wenn du die Aufgabe in einem Agenten ausführst, solltest du Claude-Code-Kosten getrennt einordnen und Abo, API sowie tatsächliche Nutzung auseinanderhalten.
Gezielte Praxisergänzung auf Basis aktueller Herstellerunterlagen. Der Datenstand der bisherigen Modell-Faktentabellen bleibt separat ausgewiesen. Neue Beispiele und Grafiken sind eigene Erklärungen; es wurden keine Modellantworten oder Leistungswerte gemessen.
Herstellerunterlagen zur Ergänzung: Claude Opus 5.5 - Claude Platform Docs (Abruf 2026-10-21) · Structured outputs - Claude Platform Docs (Abruf 2026-10-21).
Die verlinkten Herstellerunterlagen wurden für dieses Profil ausgewertet. Ältere Versionen und Einführungstexte dienen der Einordnung; aktuelle technische Angaben haben Vorrang. Abrufdaten stehen an den Quellen. Die Grafik ist redaktionell, kein Leistungstest.
Auf der Claude API lautet sie claude-opus-5-5. Die ID ist von Plattformnamen und älteren Opus-Versionen zu unterscheiden; eine Anwendung sollte Endpunkt und Version dokumentieren.
In der hier geprüften Modellbeschreibung sind Text und Bilder als Eingabe sowie Text als Ausgabe dokumentiert. Daraus folgt keine native Bildausgabe. Eine Anwendung kann zusätzlich Werkzeuge verwenden; deren Ergebnis ist getrennt zu betrachten.
Unter anderem bleiben Thinking aktiv, erzwungene Werkzeugaufrufe werden abgelehnt und gespeicherte Thinking-Blöcke sind an Modell und Unterhaltung gebunden. Die aktuelle Dokumentation beschreibt außerdem Plattformunterschiede bei Computer Use und Änderungen bei Zwischenmeldungen.
Claude API, Standardtarif: 4 USD je Million Eingabetokens und 20 USD je Million Ausgabetokens. Fast Mode kostet 8/40 USD und ist ein separater Tarif. Weitere Kategorien wie Cache und Werkzeuge beeinflussen die tatsächliche Rechnung.
Nein. Die drei Fälle sind vorab definierte Sollwerte einer redaktionellen Übung. Eine allgemeine Trefferquote, Laufzeit oder Qualitätswertung für Opus 5.5 wurde daraus nicht ermittelt.
Im dokumentierten Quellenstand: 1.000.000 Tokens. Beachte die Bedingungen der konkreten Modellversion und des verwendeten Endpunkts. Kontext ist keine Wortzahl und kein Nachweis, dass jede enthaltene Information zuverlässig verarbeitet wird.
Lege eine kleine Aufgabe mit bekanntem oder nachprüfbarem Ergebnis fest. Notiere Version, Eingabe und Einstellungen. Vergleiche die Ausgabe mit deinem Prüfkriterium und halte Fehler sowie tatsächliche Kosten getrennt fest. Die Testidee auf dieser Seite ist ein Vorschlag und wurde hier nicht als Modelltest ausgeführt.
Nein. Er liest nur deine getrennt gespeicherte JSON-Prüftabelle. Einen Patch musst du selbst lesen und anschließend bewusst in einem Übungsprojekt testen.
Für diese ausdrücklich festgelegte Übung lautet das Ergebnis None, im JSON null. Andere Anwendungen können einen anderen Vertrag brauchen.
Die drei kleinen Fälle reichen dafür nicht aus. Prüfe Eingabetypen, weitere Randfälle und die Auswirkungen im tatsächlichen Projekt.
Text & Reasoning
Für aufwendige Analyse, Recherche und lange Agentenabläufe. Adaptive Thinking bleibt immer aktiv.
Text & Reasoning
Für Text-, Programmier- und Werkzeugaufgaben mit einstellbarem Thinking.
Text & Reasoning
Für Klassifikation, Extraktion, Routing und häufig wiederholte Aufgaben.