KI & Modelle / Guide
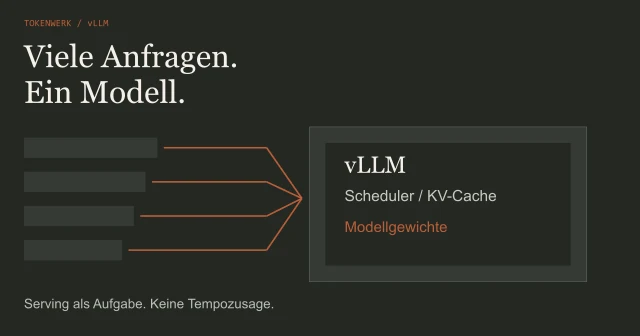
vLLM einrichten: Vom lokalen Modell zum geprüften API-Dienst
vLLM verständlich einrichten: Hardware prüfen, ein kleines Modell lokal bereitstellen und API sowie Antworten kontrollieren. Mit Befehlen und Ollama-Vergleich.
Technologie verstehen.
Besser entscheiden.
Ollama verstehen und ein eigenes Setup Schritt für Schritt konfigurieren.
Grundlagen, Einrichtung und Konfiguration.
vLLM verständlich einrichten: Hardware prüfen, ein kleines Modell lokal bereitstellen und API sowie Antworten kontrollieren. Mit Befehlen und Ollama-Vergleich.
Einen RAG-Chatbot mit n8n nachvollziehbar aufbauen: eigene Übungsdaten laden, Textstellen abrufen und Antworten prüfen. Mit Testdatei, Prompt und klaren Grenzen.
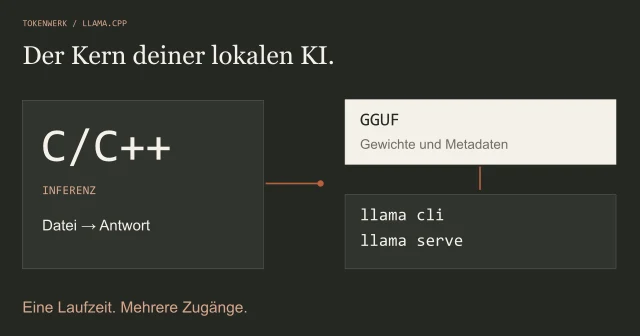
llama.cpp verständlich einrichten: offizielle App oder CLI wählen, GGUF laden, erste Antwort prüfen und eine lokale API starten. Mit Befehlen und Fehlerhilfe.
Welche Ollama-Oberfläche passt? Vergleiche App, Page Assist, Open WebUI und AnythingLLM nach Aufgabe und Datenweg. Mit Verbindungscheck und Dokumentenprobe.
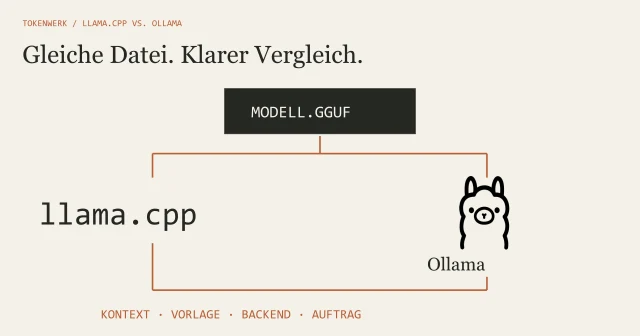
llama.cpp oder Ollama? Vergleiche Modellverwaltung, GGUF-Import, Laufzeitparameter und APIs. Mit gleichem Prüffall und ohne erfundenen Geschwindigkeitssieger.
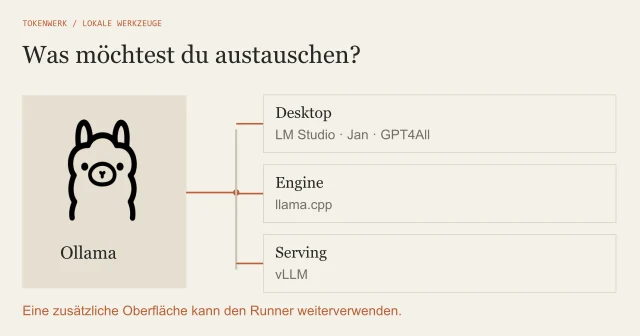
LM Studio, Jan, GPT4All, llama.cpp, vLLM oder Open WebUI? Finde eine passende Ollama-Alternative nach Aufgabe, Datenweg und Betriebsaufwand.
Was lokal läuft und welche Rolle die Anwendung übernimmt.
Container und Verbindungen getrennt aufbauen und prüfen.
Kontext, eigene Vorgaben und Ausgabeform an der Aufgabe prüfen.
Die Beiträge nennen ihre Quellen und unterscheiden Herstellerangaben, eigene Beispiele und tatsächlich durchgeführte Prüfungen.
Unser Redaktionsstandard →vLLM einrichten: Vom lokalen Modell zum geprüften API-Dienst: vLLM verständlich einrichten: Hardware prüfen, ein kleines Modell lokal bereitstellen und API sowie Antworten kontrollieren. Mit Befehlen und Ollama-Vergleich. RAG-Chatbot bauen: Mit eigener Wissensdatei und Quellenprüfung: Einen RAG-Chatbot mit n8n nachvollziehbar aufbauen: eigene Übungsdaten laden, Textstellen abrufen und Antworten prüfen. Mit Testdatei, Prompt und klaren Grenzen. llama.cpp nutzen: Vom ersten Modell zur lokalen API: llama.cpp verständlich einrichten: offizielle App oder CLI wählen, GGUF laden, erste Antwort prüfen und eine lokale API starten. Mit Befehlen und Fehlerhilfe.
Wähle einen Titel nach deiner Frage und öffne den Beitrag. Dort stehen die ausführliche Erklärung, Quellen und gegebenenfalls Prüfschritte.
Die Themenübersicht bündelt Ressorts; über die Magazinsuche kannst du einen konkreten Begriff eingeben.