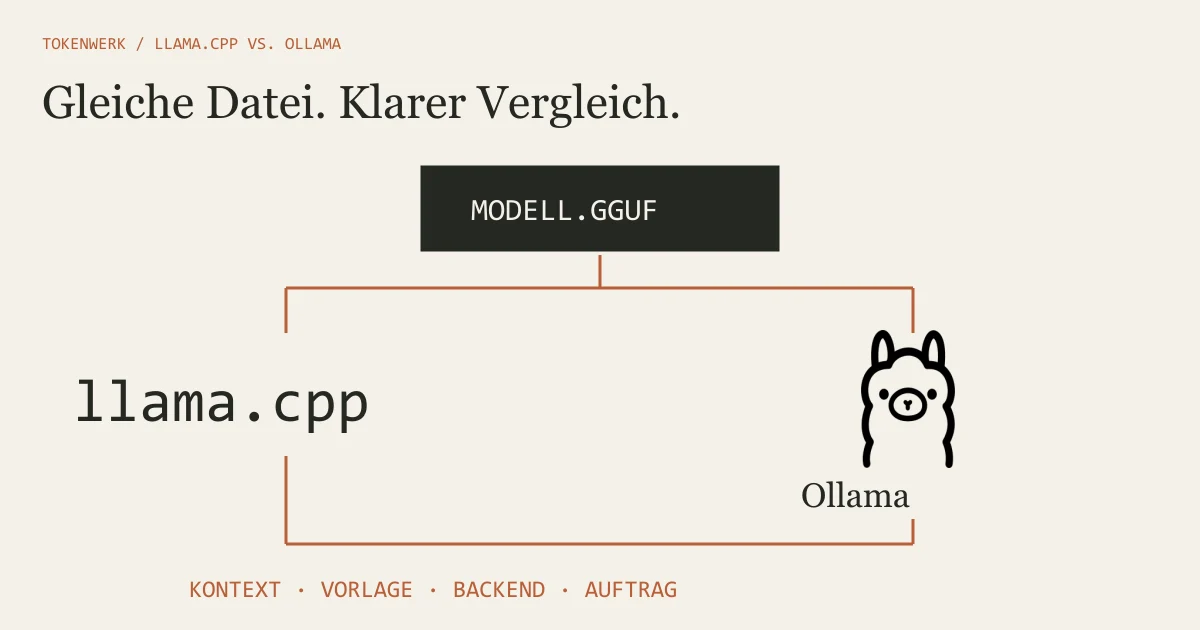
Wähle nach deinem Ablauf. Vergleiche bei einer Probe möglichst dieselbe Gewichtsdatei und dokumentiere Kontext, Vorlage, Backend und Last. Aus einem anderen Werkzeugnamen folgt kein automatischer Qualitäts- oder Geschwindigkeitsvorsprung.
llama.cpp oder Ollama: die kurze Entscheidung
| Frage | llama.cpp | Ollama |
|---|---|---|
| Wie wähle ich Gewichte? | Konkrete Datei oder Hubrepository direkt angeben; weitere App-/Routerwege möglich | Modelle über Tags verwalten oder unterstützte eigene Gewichte importieren |
| Wie konfiguriere ich den Lauf? | Direkte CLI-/Serveroptionen und passende Backends | Modelfile, Anfrageoptionen und Einstellungen des konkreten Zugangs |
| Gibt es eine Oberfläche? | App und eingebaute Server-WebUI dokumentiert | Eigene App und zusätzliche Oberflächen möglich |
| Wie binde ich Anwendungen an? | Lokaler Server mit nativen und kompatiblen API-Endpunkten | Lokaler Dienst und dokumentierte API-Kompatibilitätswege |
| Was entscheidet über die Eignung? | Gewünschte Kontrolle, Modellunterstützung und eigener Betriebsaufwand | Gewünschte Verwaltung, Modellunterstützung und eigener Betriebsaufwand |
Wenn du eine bestimmte GGUF-Datei mit ausdrücklich gesetzten Startparametern untersuchen möchtest, ist llama.cpp ein naheliegender Kandidat. Wenn du Modelle unter benannten Konfigurationen verwalten und über einen Dienst verwenden möchtest, prüfe Ollama. Diese Einordnung ist keine Aussage, dass nur eines der Werkzeuge die jeweilige Aufgabe beherrscht.
Alte Beschreibungen können die aktuelle App- und Serverlage verfehlen. Weder „llama.cpp hat keine Oberfläche“ noch „Ollama ist immer nur ein fester Wrapper mit identischem Backend“ sollte ohne Versions- und Modellbezug zur Entscheidungsgrundlage werden.
Modellverwaltung und eigene GGUF-Datei
Ein Modelltag und ein Dateiname belegen nicht automatisch identische Gewichte. Halte Quelle, konkrete Variante, Quantisierung und gegebenenfalls Prüfsumme fest. Wenn du die gleiche unterstützte GGUF-Datei verwenden kannst, entfällt zumindest ein Teil dieser Unsicherheit. Die Auswahl lokaler KI-Modelle zeigt, welche Angaben du zu Checkpoint, Quantisierung und zulässiger Nutzung festhalten solltest.
llama.cpp kann eine vorhandene Datei direkt über -m laden. Die Anleitung llama.cpp Schritt für Schritt einrichten zeigt Installation, Dateipfad und lokalen Server. Für Ollama beschreibt die aktuelle Importreferenz eine Modelfile mit einem passenden FROM-Pfad.
Ollama · Datei namens Modelfile anlegen
FROM ./mein-modell.gguf
PARAMETER num_ctx 4096Aus dem Ordner mit Modelfile und Modell starten
ollama create tokenwerk-vergleich
ollama run tokenwerk-vergleichErsetze den Dateinamen durch eine tatsächlich unterstützte Variante. Laut Ollama-Importdokumentation wird eine GGUF-Datei beim Import nicht erneut quantisiert. Das bedeutet jedoch nicht, dass Promptvorlage, Standardparameter und Laufzeitverhalten zwischen beiden Zugängen automatisch gleich sind.
Kontext, Backend und Vorlagen kontrollieren
Vergleiche nicht nur eine sichtbare Zahl im Einstellungsdialog. Kontrolliere die tatsächlich aktive Kontextkonfiguration, Modellvorlage, Systemvorgaben, Ausgabelimit und Samplingparameter. Ein Zugang kann zusätzliche Vorgaben einfügen oder einen anderen Standard verwenden.
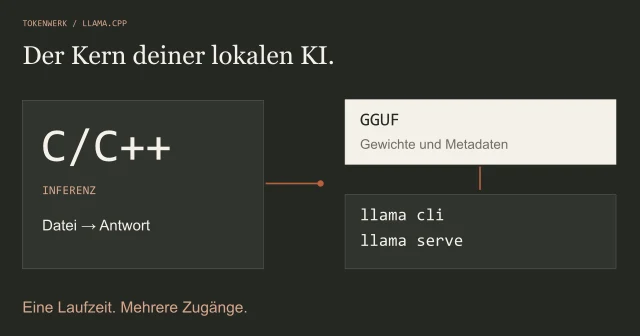
Bei llama.cpp nennt die Serverdokumentation beispielsweise Kontext, GPU-Offloading, parallele Slots und Modellalias als konkrete Optionen. Ollama dokumentiert Modelfile und Laufzeitkonfiguration. Die Anleitung Ollama-Modelfile konfigurieren erklärt, wie Modellbasis und Vorgaben zusammengehören.
Vergleichsblatt vor der Probe
Rechner / freie Ressourcen / Hintergrundlast:
Werkzeug und genaue Version:
Modellquelle / Datei / Tag / Quantisierung / Prüfsumme:
Aktive Kontextgröße:
Chatvorlage und Systemvorgaben:
Ausgabelimit und Sampling:
Backend / tatsächliche CPU- oder GPU-Nutzung:
Parallele Anfragen und Cachezustand:
Welche Unterschiede bleiben offen?Eine nicht verifizierte Einstellung bleibt im Vergleich offen. Versuche nicht, einen fehlenden Qualitätsunterschied durch beliebige Parameteränderungen herzustellen. Halte die Aufgabe stabil und begründe jede notwendige Änderung.

APIs und Oberfläche sind eigene Vergleichspunkte
Prüfe, welche Schnittstelle die aufrufende Anwendung wirklich braucht. Der aktuelle llama.cpp-Server dokumentiert standardmäßig 127.0.0.1:9931; Ollamas lokaler Standard ist 127.0.0.1:11434. Beide Adressen können geändert werden. Notiere die tatsächliche Basisadresse und die verwendete Modell-ID.
Ein erfolgreiches GET /v1/models zeigt eine erreichbare kompatible Modellliste, aber noch keine Unterstützung jedes benötigten Parameters. Ollama beschreibt seine OpenAI- und Anthropic-Kompatibilität ausdrücklich als Teilmenge. Auch bei llama.cpp musst du konkreten Endpunkt, Modell und Funktion zusammen prüfen.
Für die Bedienung solltest du die vorhandenen App- beziehungsweise Webzugänge ansehen, bevor du zusätzliche Komponenten einrichtest. Eine neue Chatoberfläche kann denselben Modellserver weiterverwenden. Oberfläche, API und Inferenz bleiben deshalb getrennte Prüfpunkte.
Ein fairer Versuch ohne erfundenen Sieger
Das folgende Material ist selbst erstellt. Es wurde für diesen Artikel nicht mit den Werkzeugen ausgeführt. Verwende in beiden Zugängen dieselbe Quelle und denselben Auftrag:
Fiktive Quelle und feste Abnahme
QUELLE
Die Übungsablage enthält sieben Dokumente. Fünf sind geprüft. Für zwei fehlt die Quellenkontrolle. Ein Veröffentlichungstermin wurde nicht festgelegt.

AUFTRAG
Erstelle eine Tabelle mit Gesamtzahl, geprüfter Zahl, offenem Rest und Veröffentlichungstermin. Nutze nur die Quelle. Markiere fehlende Angaben als „nicht angegeben“. Nenne zu jeder Zeile die zugehörige Quellstelle.Die fachliche Prüfung lautet: sieben insgesamt, fünf geprüft, zwei offen und kein erfundenes Datum. Halte falsche Zahlen, fehlende Zeilen und zusätzliche Behauptungen einzeln fest. Miss gegebenenfalls Ladezeit und Antwortzeit getrennt und dokumentiere, ob ein Modell bereits im Speicher war.
Richtigkeit, Präferenz und Tempo sind unterschiedliche Messfragen. Der Guide KI-Benchmark und Testbedingungen unterscheiden hilft beim Einordnen. Ein kleiner eigener Versuch erlaubt ein begrenztes Fazit zu diesen Fällen, keinen allgemeinen Sieger über alle Modelle und Rechner.
Welcher Betriebsaufwand passt zu dir?
Ein eigener Desktopversuch: Wähle den Zugang, den du nachvollziehbar installieren, aktualisieren und bedienen kannst. Prüfe kleine Aufgaben und behalte die tatsächlich verwendeten Gewichte im Blick.
Eine gezielte technische Konfiguration: Prüfe, ob benötigte Backend- und Startoptionen dokumentiert sind und sich für deine Version nachvollziehbar festhalten lassen. Mehr Möglichkeiten bedeuten auch mehr Einstellungen, die du korrekt betreiben musst.
Ein Dienst für weitere Anwendungen: Plane Erreichbarkeit, Zugriff, Ressourcen, Updates und den Wiederanlauf. Eine lokal funktionierende Anfrage ist noch kein fertiger Teamdienst. Halte die API für den Einstieg auf dem eigenen Rechner und erweitere sie nur mit einem begründeten Zugriffskonzept.
Deine Entscheidung kann sich später ändern. Bewahre dafür Modellquelle, Konfiguration und Prüffälle auf. Damit lässt sich ein Wechsel begründen, ohne Produktnamen mit Modellqualität zu verwechseln oder ungemessene Vorteile zu versprechen.
Quellen & Methode
Vorgehen und Grenzen
Aktuelle Originaldokumentation und ausdrücklich genannte Quellcode-/Releasebereiche am 20. Oktober 2026 geprüft. Historische Vergleichstexte dienen der Intentanalyse. Vorlagen, Probeangaben und Illustrationen sind eigene Beispiele. Keine Softwareinstallation, Laufzeitmessung oder reale Hausgeräteaktion für diese Artikel durchgeführt.
Bei Recherche, Texterstellung und Grafiken wird KI eingesetzt. Welche eigenen Versuche vorliegen und was nur als Beispiel dient, beschreibt dieser Beitrag. Unser Redaktionsstandard erklärt die Anforderungen an Belege und Berichtigungen.