Prüfe zuerst den unterstützten Hardwarepfad. Starte ein kleines Modell mit begrenztem Kontext und expliziter Loopbackadresse. Kontrolliere Modell-ID und eine feste Antwortaufgabe. Mehr Durchsatz ist eine zu messende Eigenschaft deiner Konfiguration, kein automatischer Vorteil des Produktnamens.
Was vLLM übernimmt
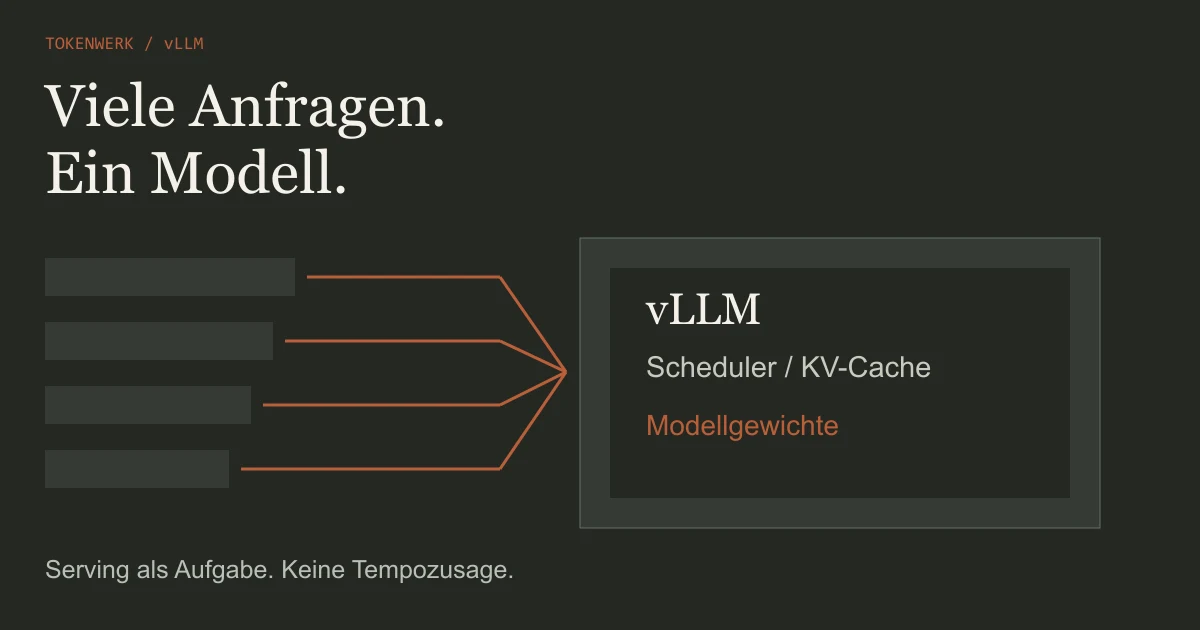
Das Modell enthält die trainierten Gewichte; vLLM ist die Software, die sie ausführt. Das offizielle Projekt beschreibt eine Bibliothek für Inferenz und Serving. Serving bedeutet, dass andere Anwendungen ihre Anfragen an einen laufenden Dienst schicken können. Es ist weder ein ChatGPT-Konto noch ein einzelnes Modell.
Für mehrere laufende Anfragen werden zwei Konzepte wichtig: Continuous Batching führt ankommende Arbeiten fortlaufend zusammen. PagedAttention organisiert den Speicher für Attention-Schlüssel und -Werte, den KV-Cache. Damit ist nicht gesagt, dass jede Anfrage schneller beantwortet wird. Modellgewichte, Kontext, Backend und die gleichzeitig anfallende Last bleiben entscheidend.
Für einen gelegentlichen Desktopchat kann eine andere Oberfläche bequemer sein. vLLM wird interessant, wenn du einen klar definierten API-Dienst oder eine Stapelverarbeitung betreiben möchtest. Starte mit dieser Aufgabe, nicht mit einer möglichst großen Serverkonfiguration.

Prüfe zuerst Hardware und Software
Der folgende Einstieg gilt für einen passenden Linux-Rechner mit NVIDIA-GPU. Die geprüfte Installationsübersicht nennt für diesen GPU-Pfad Linux, Python 3.11 bis 3.14 und NVIDIA Compute Capability ab 7.5. Treiber, verfügbare Speichermenge und konkretes Modell müssen zusätzlich zusammenpassen. Eine unterstützte Chipfamilie garantiert noch nicht genügend freien VRAM.
AMD, Intel, CPU und Apple Silicon haben eigene Installations- beziehungsweise Pluginwege. Windows wird auf dieser Originalseite nicht als nativer GPU-Installationspfad unterstützt; WSL ist ein gesonderter Aufbau. Verwende die NVIDIA-Befehle deshalb nicht unverändert für jedes Gerät.
Notiere Betriebssystem, Karte, Treiber, freien Speicher und die tatsächliche Laufzeitversion. Der Guide Hardware für lokale Modelle prüfen hilft bei dieser Bestandsaufnahme. Für diesen Beitrag wurden keine Pakete auf einem Testrechner installiert und keine Hardwarewerte gemessen.
Ein kleines Modell lokal bereitstellen
Wenn uv bereits nach dessen offizieller Anleitung installiert ist, zeigt der vLLM-Quickstart diesen Umgebungsweg. Die letzte Zeile lädt vorkompilierte Kernel; das ersetzt nicht die Prüfung des GPU-Pfads. Modell- und Paketdownloads benötigen Netzwerkzugriff und Speicherplatz. Der Guide zur Auswahl lokaler KI-Modelle hilft dir, einen passenden Checkpoint und seine Voraussetzungen vor dem Start festzuhalten.
Linux · passender NVIDIA-Pfad
uv venv --python 3.12 --seed
source .venv/bin/activate
uv pip install vllm --torch-backend=auto
vllm download-kernels
vllm --helpAls kleine Entwicklungsprobe verwenden wir die genaue Hersteller-ID Qwen/Qwen3.5-0.8B. Die Modellkarte ordnet das Modell Prototyping und Entwicklung zu. Sie enthält noch eine main-/Nightly-Empfehlung; die aktuellere vLLM-Qwen-Rezeptur zeigt eine Paketinstallation. Prüfe deshalb die konkrete Kombination und deren Fehlermeldung. Installiere nicht allein wegen eines älteren Hinweises ungeprüft einen Entwicklungsstand.
Eigene begrenzte Textprobe
vllm serve Qwen/Qwen3.5-0.8B --host 127.0.0.1 --port 8000 --max-model-len 4096 --language-model-onlyDer Prozess bleibt geöffnet. 127.0.0.1 bindet die API hier bewusst an denselben Rechner. 4096 ist unser gewähltes Kontextlimit für die kleine Probe, kein optimaler Wert für jede Aufgabe. --language-model-only lässt den Bildpfad weg. Erkennt deine Version die Architektur oder Option nicht, gleiche Paketversion und aktuelle Rezeptur ab, statt weitere Flags auf Verdacht hinzuzufügen.
Erst Erreichbarkeit, dann Antwort und Last prüfen
Öffne ein zweites Linux-Terminal und frage die geladene Modell-ID ab. Danach folgt eine kurze eigene Extraktionsaufgabe. Die Quelle ist fiktiv; erwartet werden zwei Aufgaben, eine Freigabe und kein erfundener Termin.
API und eigene Quellenprobe
curl http://127.0.0.1:8000/v1/models

curl http://127.0.0.1:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
-d '{"model":"Qwen/Qwen3.5-0.8B","messages":[{"role":"user","content":"Quelle: Zwei Aufgaben sind offen, eine ist freigegeben. Ein Termin fehlt. Nenne nur Anzahl, Freigaben und Termin aus der Quelle."}],"max_tokens":120}'Eine abgelehnte Verbindung ist zunächst ein Prozess-/Adressproblem. Ein unbekannter Modellname verlangt den Abgleich mit /v1/models. Ein Speicherfehler gehört zu Modell, Kontext und freiem Speicher. Eine falsche Zahl in einer flüssigen Antwort ist dagegen ein Inhaltsfehler. Diese Prüfungen nicht vermischen.
Erst anschließend misst du unter festgehaltenen Bedingungen Zeit bis zum ersten Token, weitere Ausgaberate und Gesamtdurchsatz. Dafür sind gleiche Eingabe-/Ausgabelängen und tatsächliche Parallelität nötig. Latenz und Durchsatz sinnvoll bewerten erklärt die Grenzen solcher Zahlen. Die hier gezeigten Befehle wurden nicht ausgeführt; es gibt deshalb keine eigenen Ergebniswerte.
vLLM oder Ollama?
Für einen selbst betriebenen Modell-API-Dienst ist vLLM ein Kandidat; für den Einstieg mit Download, Modellwahl und lokalem Chat kannst du zunächst Ollama prüfen. Beide Wege müssen zu Modell, Schnittstelle und Hardware passen. Das ist eine Vorauswahl nach Arbeitsweg, kein gemessener Geschwindigkeitsvergleich und keine feste Nutzerzahl-Schwelle. Wenn du bereits mit Ollama arbeitest, benenne vor einem Wechsel den konkreten Engpass: Modellverwaltung, API-Funktion, Last oder Wartung.
| Prüffrage | Worauf du achten solltest |
|---|---|
| Modelle bequem verwalten? | Prüfe die benötigten Download-, Datei- und Updateabläufe im vorhandenen Werkzeug. |
| Eine Anwendung anbinden? | Vergleiche die tatsächlich benötigten Endpunkte, Parameter und Modell-IDs. Ein kompatibles API-Format deckt nicht automatisch alle Funktionen ab. |
| Viele gleichzeitige Anfragen? | Teste reale Eingaben, Kontext, Warteschlange und Speicher auf deiner Hardware. |
| Betrieb selbst übernehmen? | Plane Versionspflege, Logs, Zugriffsschutz und Fehlerverantwortung ein. |
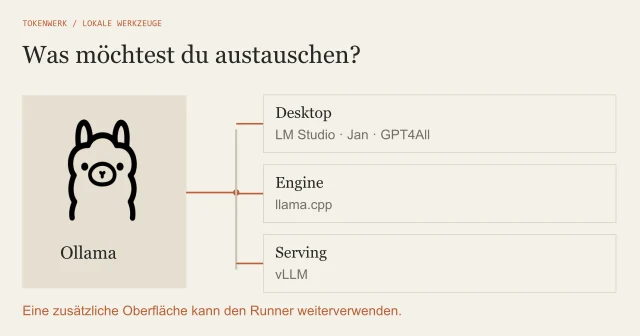
Die Übersicht Ollama-Alternativen nach Betriebsaufgabe wählen trennt Desktopoberfläche, Engine und Server. Ein Wechsel allein verbessert weder ein ungeeignetes Modell noch eine unklare Aufgabe. Auch ein API-Dienst braucht ein nachvollziehbares Abnahmekriterium.
Vom Versuch zum betriebenen Dienst
Der lokale Start ist keine öffentliche Produktionsfreigabe. Ein entfernter Zugriff braucht einen bewusst konfigurierten Zugangsweg, Authentifizierung, verschlüsselte Übertragung und begrenzte Ressourcen. Ein API-Key allein schützt nicht automatisch jede beteiligte Komponente.
Bei verteilten Aufbauten wird das besonders wichtig: Die vLLM-Sicherheitsdokumentation beschreibt interne Kommunikationswege als standardmäßig unsicher und fordert Netzwerkisolation. Einen lokalen Demonstrationsport einfach im Internet freizugeben ist deshalb kein vollständiger Betriebsplan.
Bewahre Version, Modell-ID, Startparameter, Datenwege und Prüffälle gemeinsam auf. Nach einem Update wiederholst du den passenden kleinen Abnahmetest. Bleibt eine Voraussetzung ungeklärt, bleibt auch die Einsatzentscheidung offen.
Quellen & Methode
Vorgehen und Grenzen
Aktuelle Originaldokumentation am 20. Oktober 2026 innerhalb der angegebenen Lesebereiche geprüft. Historische Haupttexte dienen der symmetrischen Intentanalyse. Übungsdaten, Code, Prompts und Grafiken sind eigene Beispiele. Keine tatsächliche Node-RED-/RAG-Ausführung, Softwareinstallation, Hardwaremessung oder Lastmessung behauptet.
Bei Recherche, Texterstellung und Grafiken wird KI eingesetzt. Welche eigenen Versuche vorliegen und was nur als Beispiel dient, beschreibt dieser Beitrag. Unser Redaktionsstandard erklärt die Anforderungen an Belege und Berichtigungen.