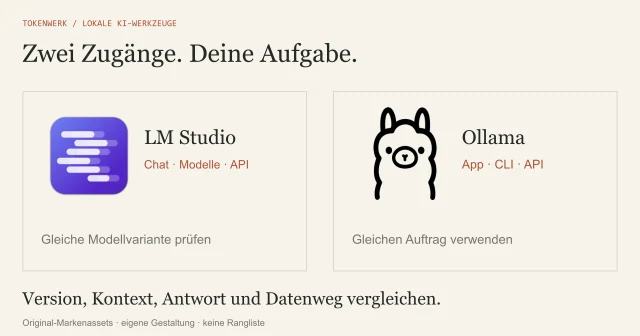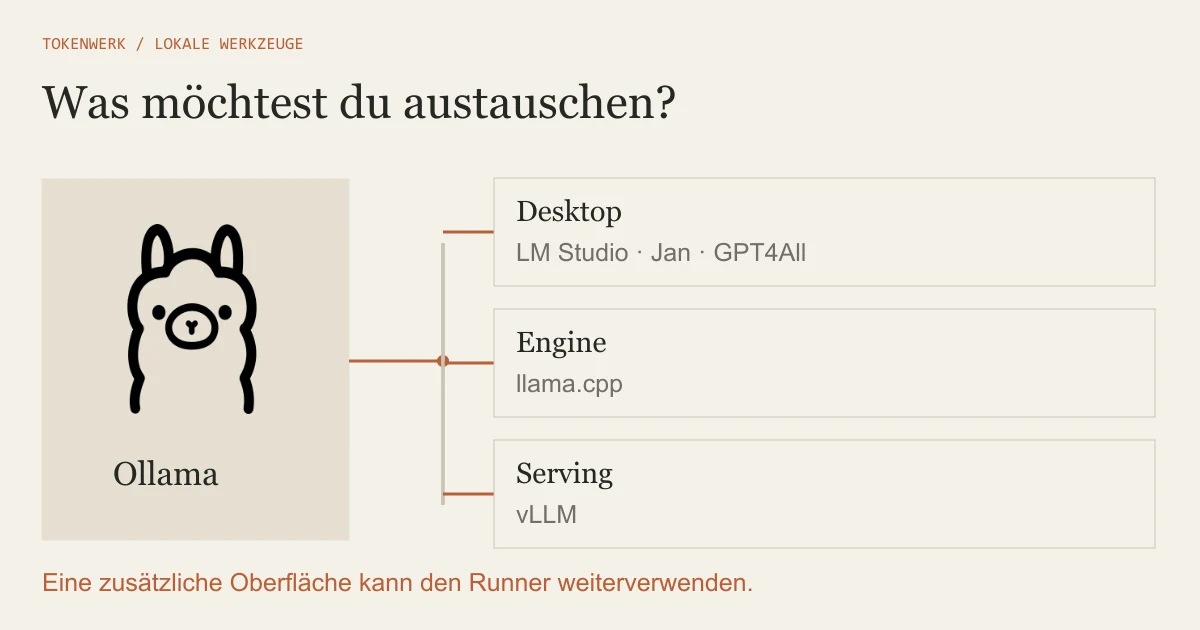
Wähle zuerst die benötigte Funktion. Für den Desktop kommen etwa LM Studio, Jan und GPT4All infrage; für eigene technische Abläufe llama.cpp oder vLLM. Open WebUI kann eine zusätzliche Oberfläche sein und Ollama im Hintergrund weiterverwenden.
Welche Ollama-Alternative passt zu deinem Vorhaben?
| Dein Vorhaben | Kandidat | Vorher prüfen |
|---|---|---|
| Modelle mit Desktopoberfläche verwalten und ausprobieren | LM Studio | Unterstütztes System, Modellformat und gewünschte lokale oder API-Nutzung |
| Lokalen Chat mit optionalen Werkzeugen einrichten | Jan | Modellpassung und Datenwege von Websuche, MCP oder Cloudanbietern |
| Mit lokalen Modellen und Dokumenten arbeiten | GPT4All | Modellunterstützung, LocalDocs und tatsächlich aktivierte externe Funktionen |
| Inferenz technisch selbst einbinden | llama.cpp | Backend, Modellformat, Build beziehungsweise Paket und Serverkonfiguration |
| Modelle als Dienst für passende Arbeitslasten betreiben | vLLM | Unterstützte Hardware, Modellimplementierung und Betriebskonzept |
| Eine andere Chatoberfläche vor den Modellserver setzen | Open WebUI | Getrenntes Backend, Benutzerzugriff und zusätzliche Funktionen |
Die Auswahl ist bewusst begrenzt. Sie soll unterschiedliche Aufgaben abdecken, nicht jedes verfügbare Produkt auflisten. Aktuelle Herstellerdokumentation ist die Grundlage; für diesen Artikel wurden keine Kandidaten installiert oder im Tempo gegeneinander getestet. Wenn dir die Trennung zwischen Laufzeit, Modell und Oberfläche noch unklar ist, beginne mit der Erklärung, was Ollama übernimmt.
Auch Ollama bietet inzwischen mehr als ein Terminal. Die Dokumentation beschreibt Mac-/Windows-Apps und optionale Cloudzugänge. „Ollama hat keine Oberfläche“ und „alles läuft immer offline“ wären deshalb ungeeignete Ausgangspunkte.
LM Studio, Jan und GPT4All für den Desktop
LM Studio verbindet Modellbrowser, Chat und Konfiguration mit lokalen Schnittstellen. Die aktuelle Übersicht nennt llama.cpp sowie MLX auf Apple Silicon, MCP-Unterstützung und einen Betrieb ohne Desktopoberfläche. Es ist somit weder auf ein einziges Modell noch auf reines Klicken begrenzt. Der Guide LM Studio und Ollama im direkten Vergleich geht auf Modellvariante, API und Offlinebetrieb ein.
Jan führt beim ersten Start zum Download eines lokalen Modells. Danach kannst du weitere Modelle auswählen oder externe Anbieter verbinden. Die dokumentierten Agentenfunktionen enthalten auch Werkzeuge wie Websuche und Webabruf. Prüfe diese gesondert: Lokal laufende Gewichte sagen noch nicht, dass kein Werkzeug Daten nach außen überträgt.
GPT4All bietet Desktopchat und LocalDocs für ausgewählte Dokumente. Ob eine konkrete Datei, Modellvariante oder Dokumentensammlung passt, ist eine eigene Prüfung. Unser Artikel GPT4All und LocalDocs einrichten zeigt den Einstieg mit einer selbst erstellten Testdatei und die relevanten Datenwege.
Wähle bei allen drei Werkzeugen zuerst eine kleine unterstützte Variante. Derselbe Familienname kann unterschiedliche Dateien, Quantisierungen und Vorlagen bezeichnen. Vergleiche diese Angaben, bevor du einen Qualitätsunterschied der Oberfläche zuschreibst.
llama.cpp und vLLM für eigene Anwendungen
llama.cpp ist eine technische Inferenzimplementierung für unterstützte Sprach- und multimodale Modelle. Das Projekt dokumentiert unterschiedliche Hardwarewege, lokale Ausführung und einen API-Server. Es kann die passende Grundlage sein, wenn du Modellformat, Backend und Einbindung gezielt kontrollieren möchtest. Diese Freiheit bedeutet auch, dass du Konfiguration und Pflege übernimmst.
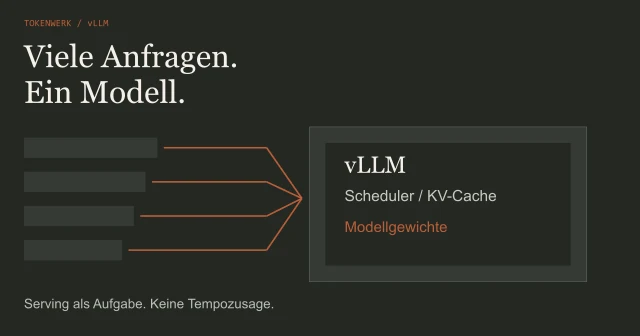
vLLM richtet sich an Inferenz und Serving, also das Bereitstellen eines Modells als Dienst. Prüfe zuerst die Unterstützung der konkreten Modellimplementierung und deiner Hardware. Eine Serving-Bibliothek ist kein automatisch einfacherer Desktopchat. Der mögliche Vorteil für eine bestimmte gleichzeitige Last muss unter deinen Bedingungen gemessen werden.
Eine Anfrage durchläuft mehrere Schichten: Anwendung oder Oberfläche, Schnittstelle, Laufzeit, Modell. Der Austausch einer Schicht kann andere Konfigurationen unverändert lassen. Halte deshalb fest, was du tatsächlich ersetzt. Die frühere pauschale Beschreibung „vLLM läuft nur unter Linux“ reicht für die aktuelle, breiter dokumentierte Hardwareunterstützung ebenfalls nicht aus.

Open WebUI ersetzt nicht automatisch die Laufzeit
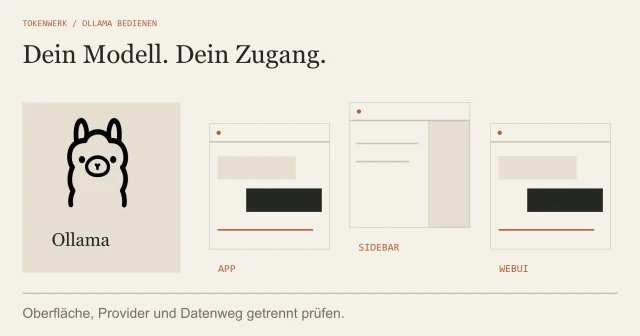
Wenn dir nur die Bedienoberfläche fehlt, brauchst du möglicherweise keinen anderen Modellrunner. Die Open-WebUI-Dokumentation beschreibt unter anderem eine getrennte Ollama-Instanz und andere API-Anbindungen. Einige Paketvarianten bündeln Ollama; andere erwarten ein separat erreichbares Backend.
Zeichne vor der Einrichtung zwei Kästen: „Oberfläche“ und „Modellserver“. Trage Adresse, Verantwortlichkeit und Zugriff dazwischen ein. So erkennst du, ob die Oberfläche nur lokal erreichbar ist, wer den Server ansprechen darf und welche Komponente bei einem Fehler untersucht werden muss.
Eine neu installierte Oberfläche behebt keinen fehlenden GPU-Zugriff im Backend und schafft keinen zusätzlichen VRAM. Umgekehrt ist ein funktionierender Modellserver noch keine vollständige Benutzerverwaltung für ein Team. Richte zuerst einen begrenzten eigenen Zugang ein, bevor du Dienste im Netzwerk veröffentlichst.
Lokal heißt nicht: jede Funktion bleibt offline
Trenne Modelldownload, lokale Antwortberechnung und zusätzliche Funktionen. Für den ersten Download wird eine Quelle im Netz benötigt. Später kann die Inferenz ohne externes Modell stattfinden, während Websuche, externe MCP-Server oder ein angeschlossener Cloudanbieter dennoch Daten übertragen.
Kontrolliere in der gewählten Anwendung das aktive Modell, die aktivierten Werkzeuge, Dokumentquellen und Diagnose- oder Weitergabeeinstellungen. Ein lokaler Produktname ersetzt diesen Blick nicht. Beginne mit selbst geschriebenen Übungsdaten und erweitere den Zugriff nur für einen konkreten Zweck.
Datenweg vor dem Wechsel
Oberfläche und Version:
Aktiver Modellanbieter / lokale Datei:
Ort der Antwortberechnung:
Dokumentordner und erlaubte Dateien:
Aktivierte Web-, MCP- oder andere Werkzeuge:
Externe Empfänger und Zweck:
Welche Funktionen für die Probe ausgeschaltet bleiben:
Offene Daten-/Zugriffsfragen:So prüfst du einen Wechsel ohne falschen Vergleich
Halte Modellversion, Quantisierung, Kontext und erwartetes Ausgabeformat möglichst vergleichbar. Wenn das nicht möglich ist, notiere die Unterschiede. Ein schnellerer Lauf mit einem viel kleineren Modell beantwortet eine andere Frage als der Vergleich zweier Oberflächen unter gleicher Last.
Eigener neutraler Prüfauftrag
QUELLE
Die Testdatei nennt zwei offene Aufgaben: Modellversion dokumentieren und lokalen API-Zugriff prüfen. Für beide Aufgaben ist noch keine Person zugeteilt.

AUFTRAG
Gib genau zwei Tabellenzeilen mit Aufgabe und zuständiger Person aus. Verwende nur die Quelle. Schreibe bei fehlender Person „nicht angegeben“. Füge keine weiteren Aufgaben hinzu.Prüfe Zeilen, fehlende Angaben und Nacharbeit. Beobachte anschließend Start, Speicherbelegung und Stabilität bei derselben begrenzten Aufgabe. Es gibt hier keine ausgefüllte Ergebnistabelle, weil Tokenwerk diesen Vergleich nicht ausgeführt hat.
Die Lektion KI-Tools anhand einer Aufgabe auswählen hilft dir, Kriterien vor dem ersten Versuch festzulegen. Bleib beim vorhandenen Setup, wenn es die Aufgabe erfüllt. Wechsle gezielt, wenn dir eine belegte Funktion fehlt oder du den Betrieb bewusst anders organisieren möchtest.
Quellen & Methode
Vorgehen und Grenzen
Aktuelle Hersteller- und Methodikdokumentation am 20. Oktober 2026 in den jeweils genannten Lesebereichen geprüft. Historische Vergleichstexte dienen der Intentanalyse. Vorlagen, Rechnungen und Illustrationen sind eigene Beispiele. Keine eigenen Hardwarebenchmarks, Modellvergleiche oder Audio-Erkennungsversuche.
Bei Recherche, Texterstellung und Grafiken wird KI eingesetzt. Welche eigenen Versuche vorliegen und was nur als Beispiel dient, beschreibt dieser Beitrag. Unser Redaktionsstandard erklärt die Anforderungen an Belege und Berichtigungen.