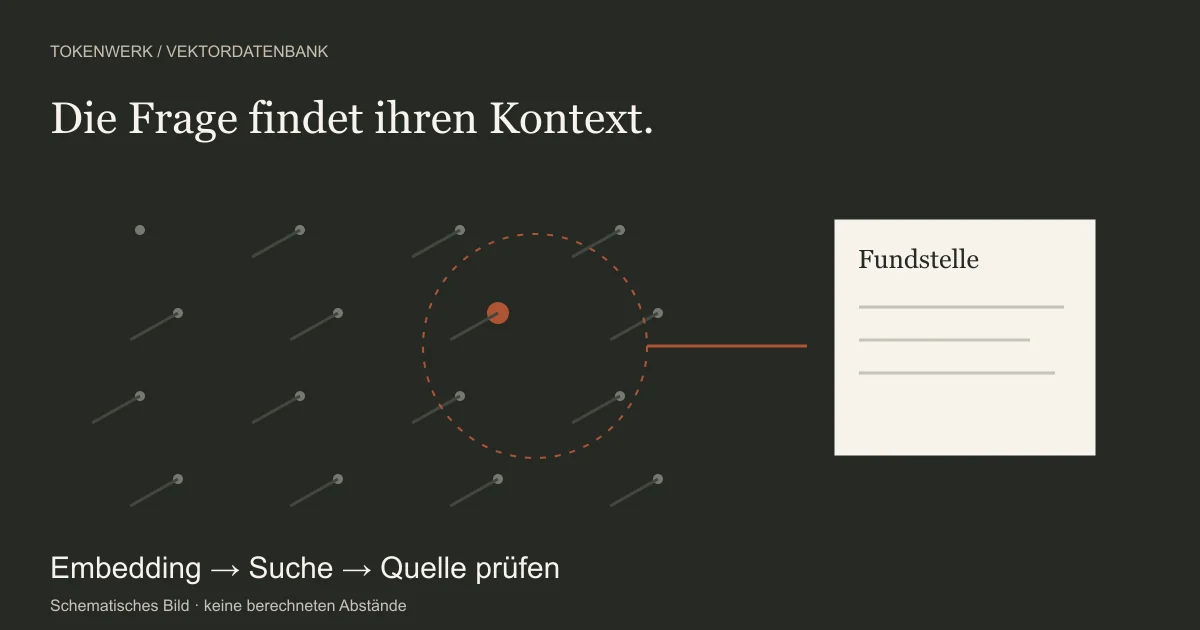
Ein Embedding-Modell verwandelt Inhalte in Vektoren. Ein Suchsystem speichert und vergleicht sie. Ob die gefundenen Stellen passen, darf nicht allein ihr Ähnlichkeitswert entscheiden: Quelle, Zugriffsrecht und Inhalt müssen stimmen.
Was eine Vektordatenbank tatsächlich speichert
Eine Vektordatenbank speichert Vektoren zusammen mit einer Kennung und gegebenenfalls dem Originaltext sowie Metadaten, etwa Quelle, Sprache und Bearbeitungsdatum. Ein Vektor ist hier eine geordnete Folge von Zahlen. Ein Embedding-Modell erzeugt diese Folge aus einem Text oder einem anderen unterstützten Inhalt. Für einen konkreten Suchaufbau kannst du Qdrant lokal nachvollziehen; die Lernprobe trennt Vektor, Kennung und Payload.
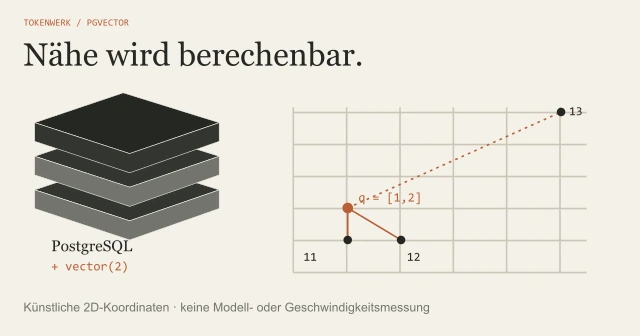
Die Microsoft-Dokumentation zu Vektorspeichern beschreibt sowohl spezialisierte Systeme als auch Vektorfunktionen in bestehenden Datenbanken. Deshalb ist die Gegenüberstellung „SQL oder Vektoren“ zu grob. Ein vorhandenes Datenbanksystem kann strukturierte Felder und Vektorsuche verbinden.
Wie Text zu Vektoren wird
Für die Textsuche werden Dokumente zunächst in brauchbare Abschnitte zerlegt. Das Embedding-Modell berechnet für jeden Abschnitt einen Vektor. Auch die spätere Suchfrage wird eingebettet. Nur zueinander passende Repräsentationen lassen sich sinnvoll vergleichen; dokumentiere deshalb Modell, Version und Verarbeitungsschritte.
Die Anzahl der Zahlen ist vom gewählten Modell abhängig. Eine höhere Zahl allein beweist keine bessere Suche. Auch zu große oder falsch getrennte Textabschnitte können unpassende Treffer erzeugen. Bewahre die Zuordnung zum Original auf, damit ein Ergebnis später zu einer konkreten Passage führt.
„LLM-Embeddings“ bezeichnet in diesem Umfeld Zahlenrepräsentationen für die Suche. Ein Modell, das Vektoren erzeugt, und ein Sprachmodell, das daraus eine Antwort formuliert, erfüllen unterschiedliche Aufgaben. Du musst sie nicht mit demselben Produkt erledigen.
Vom Suchsatz zum passenden Textstück
- Du bereitest freigegebene Quellen vor und hältst ihre Herkunft fest.
- Ein Embedding-Modell verarbeitet die Abschnitte.
- Das Suchsystem legt Vektoren und die zugehörigen Angaben ab.
- Eine Frage wird mit einem passenden Embedding-Modell verarbeitet.
- Die Suche liefert ähnliche Abschnitte, die die Anwendung anschließend prüft.
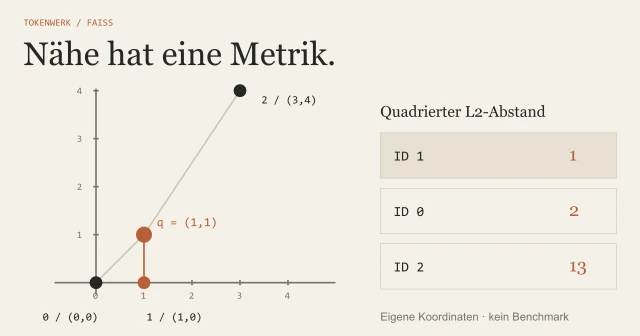
Die Ähnlichkeit kann über verschiedene mathematische Maße bestimmt werden. Ein Suchindex kann Kandidaten gezielt eingrenzen, statt jeden Eintrag vollständig zu vergleichen. Wähle Verfahren und Einstellungen anhand deiner Daten und Anforderungen; eine allgemein garantierte Suchgeschwindigkeit lässt sich daraus nicht ableiten.

Ein kleines Beispiel ohne zusätzliche Software
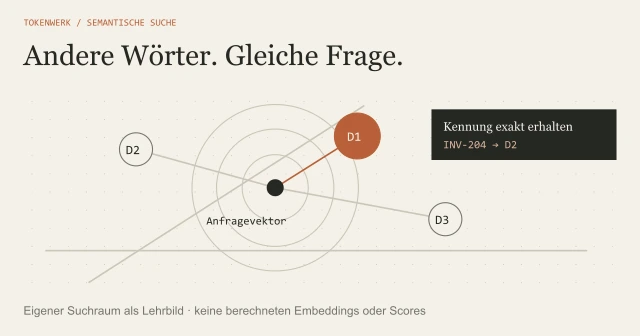
Eigene fiktive Übung: Drei kurze Notizen handeln von einem Leihgerät. Die Suchfrage verwendet bewusst andere Wörter als die passende Fundstelle. Du kannst zunächst von Hand prüfen, was eine gute Suche zurückgeben müsste. Die Übung berechnet keine echten Embeddings und enthält keine gemessenen Scores.
Künstlicher Mini-Datenbestand zum Kopieren
A · Leihgerät
Das Test-Notebook kann für maximal drei Tage ausgeliehen werden. Rückgabe bei der Geräteausgabe.

B · Besprechungsraum
Der Raum kann für zwei Stunden gebucht werden. Die Buchung erfolgt im Kalender.

C · Reparatur
Defekte Geräte werden mit einer kurzen Fehlerbeschreibung an das Technikteam gemeldet.

Suchfrage 1: Wie lange darf ich den mobilen Rechner behalten?
Suchfrage 2: Welche Versicherung deckt das Leihgerät ab?Für Frage 1 ist Notiz A die erwartete Fundstelle. Für Frage 2 gibt es keine ausreichende Angabe. Eine Suche kann trotzdem A als ähnlichsten Treffer liefern. Das macht A noch nicht zum Beleg für einen Versicherungsschutz. Die Anwendung braucht einen Umgang mit nicht beantwortbaren Fragen. Für den nächsten praktischen Schritt zeigt das Chroma-DB-Beispiel, wie du drei explizite Vektoren speicherst, abfragst und ihre Abstände nachrechnest.
Eigene Vektordatenbank oder vorhandenes System?
| Ausgangslage | Sinnvolle Prüfung |
|---|---|
| Es gibt bereits eine Datenbank mit Vektorfunktion | Prüfe, ob sie deinen Datenumfang, Filter und Betriebsanforderungen erfüllt. |
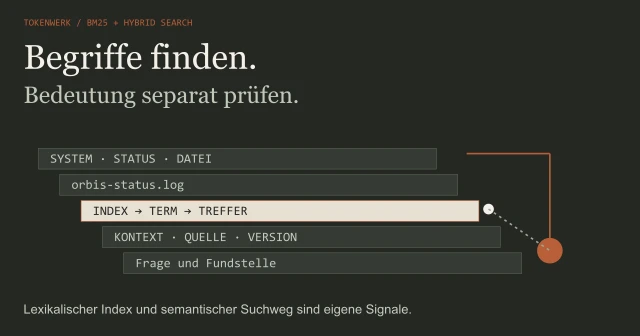
| Eine Suchplattform ist bereits vorhanden | Untersuche, ob Volltext- und Vektorsuche gemeinsam die erwarteten Fundstellen liefern. |
| Ein eigener Vektordienst wird erwogen | Prüfe Sicherung, Wiederherstellung, Aktualisierung und Zuständigkeiten zusätzlich zur Suchfunktion. |
| Du baust erst einen kleinen Prototyp | Beginne mit einem überschaubaren freigegebenen Datensatz und erwarteten Ergebnissen. |
Vergleiche keine Anbieter allein anhand der Zahl unterstützter Vektoren. Für deinen Fall können Zugriffskontrolle, Löschbarkeit, verfügbare Schnittstellen oder die Einbindung in den bestehenden Betrieb entscheidender sein. Dokumentiere offene Punkte vor dem Produktwechsel.
Ähnliche Treffer sind noch keine richtige Antwort
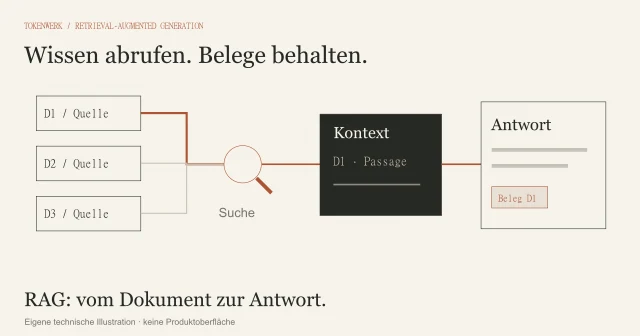
Bei Retrieval-Augmented Generation werden gefundene Inhalte einem Sprachmodell als Kontext bereitgestellt. Die Suche und das Formulieren der Antwort bleiben getrennte Schritte. Die Lektion Dokumentensuche mit RAG vorbereiten führt durch diese Planung. Die RAG-Grundlagen zeigen, wo der Suchspeicher im Weg von der Quelle zur Antwort steht und warum ein Treffer noch keine richtige Antwort belegt.
Prüfe mit einem eigenen kleinen Fragensatz mindestens passende Fundstellen, veraltete Angaben, fehlende Antworten und unzulässige Zugriffe. Ein Nutzer darf keine fremden Dokumente erhalten, nur weil sie gut zur Frage passen. Eine gelöschte oder geänderte Quelle muss auch im Suchbestand nachvollziehbar behandelt werden.
Öffne die Originalpassage, bevor du eine wichtige Aussage weiterverwendest. Die Übung Quellen beim Recherchieren prüfen zeigt den Belegschritt. Der Beitrag KI-Halluzinationen einordnen erklärt, warum zusätzliches Suchwissen falsche Antworten nicht automatisch ausschließt.
Quellen & Methode
Vorgehen und Grenzen
Quellenprüfung am 19. Oktober 2026. Vier vollständig gelesene Recherchequellen dienen der Intent- und Abdeckungsanalyse; materielle Produktangaben stammen aus den genannten Primärquellen. Eigene Übungen und Illustrationen sind als solche gekennzeichnet. Keine eigenen Produkt-, Leistungs- oder Hardwaremessungen.
Bei Recherche, Texterstellung und Grafiken wird KI eingesetzt. Welche eigenen Versuche vorliegen und was nur als Beispiel dient, beschreibt dieser Beitrag. Unser Redaktionsstandard erklärt die Anforderungen an Belege und Berichtigungen.