Trenne das Serverpaket von der Aktivierung in einer Datenbank. Verwende passende Rechte und einheitliche Vektordimensionen. Prüfe zuerst die exakte Rangfolge; ein näherungsweiser Index ist danach eine eigene Entscheidung mit messbaren Grenzen.
Was pgvector ergänzt und was es nicht erzeugt
Ein Embedding-Modell übersetzt Inhalte in Zahlenvektoren. pgvector speichert solche Vektoren in PostgreSQL und stellt Operatoren für ihren Vergleich bereit. Die Erweiterung erzeugt dadurch noch keine Text-Embeddings und schreibt keine belegte Antwort auf eine Frage.
Der praktische Vorteil ist die gemeinsame Datenbasis: Eine Zeile kann Kennung, Quelle, Zugriffsmerkmale und Vektor enthalten. Du arbeitest weiter mit PostgreSQL und kannst relationale Bedingungen mit der Suche verbinden. Ob ein Treffer fachlich passt, bleibt eine zusätzliche Prüfung.
Wenn dir der Unterschied zwischen Embedding, Speicher und Antwort noch unklar ist, hilft der Guide Vektordatenbanken und ihren Suchjob einordnen. Für einen ersten Einstieg reichen künstliche Zahlen. Du brauchst dafür weder eine Modell-API noch echte Dokumente.
Serverpaket, Datenbank und Rechte prüfen
Die Einrichtung hat zwei Stufen. Zuerst müssen passende pgvector-Dateien auf dem PostgreSQL-Server verfügbar sein. Anschließend wird die Erweiterung in jeder benötigten Datenbank mit CREATE EXTENSION vector; aktiviert. Ein SQL-Client installiert das Betriebssystempaket nicht automatisch.
Zuerst nur vorhandene Installation und Datenbank ansehen
SELECT version();
SELECT current_database(), current_user;
SELECT name, default_version, installed_version
FROM pg_available_extensions
WHERE name = 'vector';
SELECT extversion FROM pg_extension WHERE extname = 'vector';Fehlt die erste Erweiterungszeile, kläre mit dem Betreiber, welcher Installationsweg zu Serverversion und Plattform passt. Die README nennt unter anderem Pakete, Container und Kompilierung. Übernimm keine fremde PostgreSQL-Hauptversion ungeprüft in einen Installationsbefehl.
Die Aktivierung benötigt passende Rechte; auf verwalteten Diensten gelten zusätzlich deren Freigaben. IF NOT EXISTS unterdrückt lediglich den Fehler bei einer bereits vorhandenen Erweiterung. Es bestätigt weder die erwartete Version noch die richtige Konfiguration.
Für die folgende Probe brauchst du eine eigene Testdatenbank mit aktivierter Erweiterung, einen erreichbaren vector-Typ und das Recht für temporäre Tabellen. CONNECT, TEMPORARY, Schema- und Objektrechte sind unterschiedliche Dinge. Eine Anwendungsrolle sollte nicht allein für eine Lernprobe pauschale Administratorrechte erhalten.
Mit drei Punkten die erste Suche nachvollziehen
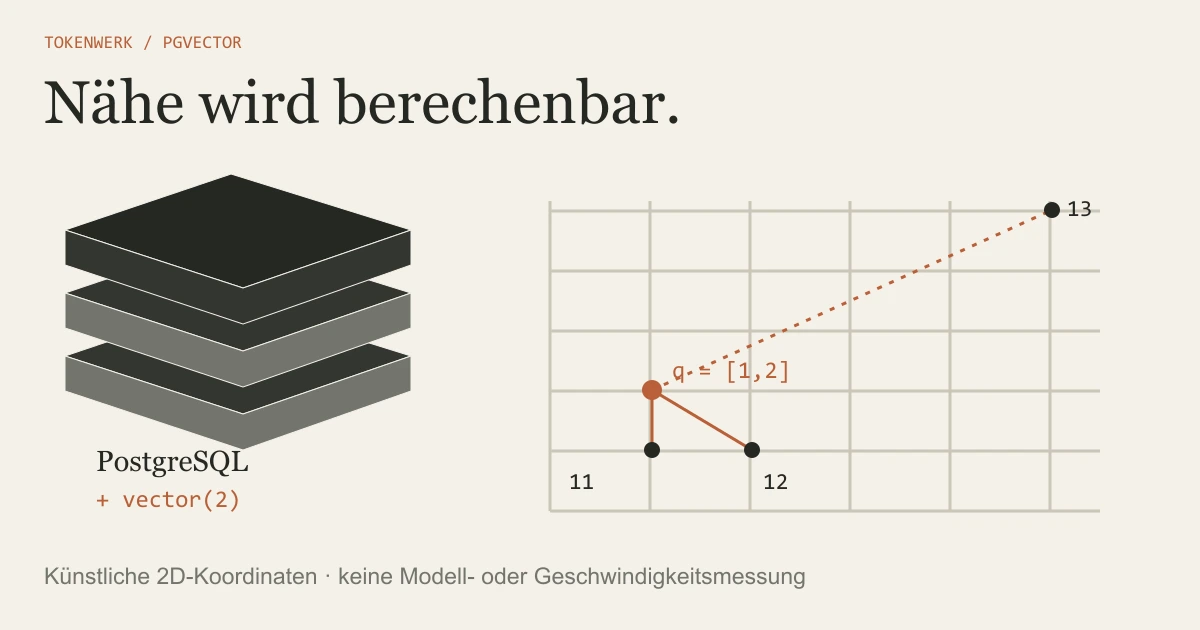
Unsere eigene Probe verwendet zwei Dimensionen. Die Anfrage ist [1,2]; gespeichert werden [1,1], [2,1] und [5,5]. Das sind künstliche Koordinaten, keine erzeugten Text-Embeddings. Du kannst ihre euklidischen Abstände selbst rechnen.
Eigene SQL-Lernprobe für eine vorbereitete Testdatenbank
-- TOKENWERK: eigene Lernprobe mit künstlichen 2D-Werten.
-- Voraussetzung: PostgreSQL mit bereits aktivierter Erweiterung vector.
-- Die Erweiterung muss im search_path erreichbar sein; Rolle braucht TEMPORARY.
-- Kein Datenbanklauf durch Tokenwerk behauptet. In eigener Testdatenbank ausführen.
BEGIN;
CREATE TEMP TABLE tw_vector_probe (
  id integer PRIMARY KEY,
  embedding vector(2) NOT NULL
) ON COMMIT DROP;
INSERT INTO tw_vector_probe (id, embedding) VALUES
  (11, '[1,1]'),
  (12, '[2,1]'),
  (13, '[5,5]');
SELECT id, embedding <-> '[1,2]'::vector AS distance
FROM tw_vector_probe
ORDER BY embedding <-> '[1,2]'::vector
LIMIT 3;
-- Mathematisch erwartete Reihenfolge: 11, 12, 13.
-- Distanzen: 1, sqrt(2), 5. Keine echten Text-Embeddings.
ROLLBACK;
| ID | Punkt | L2-Abstand zu [1,2] |
|---|---|---|
| 11 | [1,1] | 1 |
| 12 | [2,1] | √2 ≈ 1,4142 |
| 13 | [5,5] | 5 |
Die temporäre Tabelle bleibt auf die Sitzung beschränkt. Die Transaktion endet mit ROLLBACK; das Beispiel verändert keine vorhandene Fachtabelle. Lade die SQL-Lernprobe als Textdatei herunter, prüfe sie und führe sie nur in deiner vorbereiteten Testumgebung aus.
Hier wurden die Zahlen unabhängig nachgerechnet und der Download mit dem sichtbaren Beispiel abgeglichen. Ein PostgreSQL-Lauf wurde nicht durchgeführt. Für echte Dokumente musst du ein geeignetes Embedding-Modell, dessen Dimensionen und deine Zugriffsregeln festlegen. Die Lektion zeigt, wie du eine Dokumentensuche mit nachvollziehbaren Belegen planen kannst.

L2, Kosinus und inneres Produkt unterscheiden
| Operator | Bedeutung | Für die Auswertung wichtig |
|---|---|---|
| <-> | L2-Distanz | Kleiner bedeutet näher. |
| <=> | Kosinusdistanz | Nicht mit Kosinusähnlichkeit verwechseln. |
| <#> | Negatives inneres Produkt | Negatives Vorzeichen ist Teil der Operatorsemantik. |
Wähle die Metrik nach dem verwendeten Embedding-Modell und seiner dokumentierten Nutzung. Vergleiche Anfrage und gespeicherte Inhalte im selben passenden Vektorraum. Eine gleich lange Zahlenfolge aus einem anderen Modell ist nicht allein deshalb kompatibel.
Wenn du aus Kosinusdistanz eine Ähnlichkeit darstellen möchtest, verwendet die README 1 - Distanz. Für indexgestützte Nachbarsuche ist die genaue Form des ORDER BY relevant: Distanzoperator aufsteigend und ein LIMIT. Eine umgeformte Anzeigegröße ist nicht automatisch gleich gut indexierbar. Bei drei Lernpunkten ist Geschwindigkeit ohnehin kein sinnvolles Auswahlkriterium.
Erst exakte Suche, dann HNSW oder IVFFlat
Ohne näherungsweisen Index führt pgvector eine exakte Nachbarsuche aus. HNSW und IVFFlat beschleunigen geeignete größere Suchaufgaben durch eine Näherung. Dabei kann sich die Trefferliste verändern. Vergleiche deshalb nicht nur Laufzeit, sondern auch Recall: Wie viele relevante Nachbarn aus deiner exakten Referenz werden wiedergefunden?
| Weg | Eigenschaft | Was du selbst prüfen musst |
|---|---|---|
| Exakte Suche | Vollständige Referenz für die gewählte Distanz und Datenbasis. | Laufzeit bei deiner Größe und Filterung. |
| HNSW | Mehrschichtiger Graph; Aufbau und Speicherbedarf sind Teil der Abwägung. | Recall, Suchparameter, Speicher und Aufbauzeit. |
| IVFFlat | Teilt Vektoren in Listen; Aufbau braucht eine passende Datengrundlage. | Listen, Probes, Datenverteilung und Recall. |
Ein Filter wie Mandant, Sprache oder Freigabestatus verändert die Aufgabe. Bei näherungsweisen Indizes kann die Filterung nach dem Indexscan zu weniger Treffern führen. Iterative Scans können weiter suchen, bleiben aber an ihre Grenzen und Einstellungen gebunden. Ein Suchfilter ersetzt keine sauber durchgesetzte Zugriffsberechtigung.
Es gibt in diesem Artikel keinen eigenen Geschwindigkeitsvergleich und keinen pauschalen Indexsieger. Wenn du darauf einen RAG-Chatbot mit Quellenprüfung aufbauen möchtest, prüfe zuerst die gefundenen Passagen und erst danach die formulierte Antwort.
Fehlende Erweiterung und unerwartete Treffer prüfen
| Beobachtung | Nächste Prüfung |
|---|---|
| extension vector is not available | Serverdateien, richtige PostgreSQL-Installation und Freigabe des Betreibers. |
| type vector does not exist | Aktuelle Datenbank, Aktivierung, Schema und search_path. |
| permission denied | Erforderliches Datenbank-, Schema- oder Objektrecht gezielt klären. |
| Unterschiedliche Dimensionen | Vektorspalte, Anfrage und Embedding-Konfiguration vergleichen. |
| Nach dem Index fehlen Treffer | Exakte Referenz, Filter, Suchparameter und iterative Scan-Grenzen prüfen. |
| Kleine Tabelle verwendet keinen Index | Ein Tabellenscan kann günstiger sein; Plan prüfen statt pauschal erzwingen. |
Notiere PostgreSQL-Version, pgvector-Version, Metrik, Modell und Filter zusammen. Bei einem Modellwechsel brauchst du eine bewusst geplante Datenmigration oder getrennte Vektorräume. Ein erfolgreicher SQL-Aufruf beweist noch keine brauchbare Dokumentensuche.
Originaldokumentation geprüft am 20. Oktober 2026. Die README unterstützt aktuell PostgreSQL 13 und neuer; das ist keine Aussage, dass jede ältere PostgreSQL-Version noch regulären Support erhält. Für Installation und Betrieb ist der unterstützte Stand deiner Umgebung maßgeblich.
Quellen & Methode
Vorgehen und Grenzen
Originaldokumentation am 20. Oktober 2026 im dokumentierten Umfang geprüft; vier ausgewählte vollständige Haupttexte pro Thema verglichen. Eigene Beispiele und Grafiken sind Lernhilfen. Keine tatsächlichen n8n-, MCP-, ChatGPT- oder PostgreSQL-Läufe und keine pauschale Rechtsfreigabe behauptet.
Bei Recherche, Texterstellung und Grafiken wird KI eingesetzt. Welche eigenen Versuche vorliegen und was nur als Beispiel dient, beschreibt dieser Beitrag. Unser Redaktionsstandard erklärt die Anforderungen an Belege und Berichtigungen.