Trenne Point-ID, Vektor und Payload. Dimension und Metrik müssen zur Abfrage passen. Begrenze eine lokale Testinstanz auf den eigenen Rechner; die ungeschützte Standardkonfiguration ist kein öffentlicher Produktionsbetrieb. Ein Payloadfilter ersetzt keine Zugriffsprüfung.
Was Qdrant in einer KI-Anwendung übernimmt
Qdrant speichert Vektoren und sucht dazu passende Kandidaten. In einer Dokumenten-KI bildet zuvor ein Embeddingmodell die Inhalte als Zahlen ab; ein Antwortmodell formuliert danach einen Entwurf aus ausgewählten Textstellen. Die Datenbank allein schreibt dadurch keine sachlich verlässliche Antwort.
Qdrant bietet unter anderem Metadatenfilter und verschiedene Betriebswege. Seine Produktseite ist eine Funktionsübersicht, kein unabhängiger Vergleichstest. Auch ein kommerzielles Jahresangebot im AWS Marketplace ist nicht der allgemeine Mindestpreis für jede Qdrant-Nutzung.
Der Grundlagenartikel „Die Rolle einer Vektordatenbank verstehen“ erklärt diesen Zusammenhang. Hier geht es um den konkreten Einstieg mit Collection, Punkten und einer nachvollziehbaren Abfrage.

Eine lokale Lernumgebung begrenzen
Die folgende Probe setzt funktionierendes Docker und eine separate lokale Testumgebung voraus. Qdrants Selfhost-Standard ist ohne Authentisierung und Verschlüsselung offen für erreichbare Clients. Veröffentliche deshalb nicht einfach die Standardports auf einem öffentlichen Server.
Eigener begrenzter Docker-Einstieg
docker run --name tokenwerk-qdrant-lernen \
  -p 127.0.0.1:6333:6333 \
  -v tokenwerk-qdrant-lernen:/qdrant/storage \
qdrant/qdrantDas mehrzeilige Beispiel ist für eine Shell mit Backslash-Zeilenfortsetzung; unter PowerShell kannst du dieselben Argumente in eine Zeile schreiben. Der REST-Port wird nur an die lokale Adresse gebunden. Das benannte Volume erhält die Daten unabhängig vom Container. Der Befehl startet nicht automatisch einen vollständigen sicheren Teamdienst.
Die Dokumentation nennt die Weboberfläche unter http://127.0.0.1:6333/dashboard. Für diese REST-/Python-Probe wird der zusätzliche gRPC-Port nicht veröffentlicht. Notiere vor dem Versuch die tatsächlich verwendete Imageversion beziehungsweise den Digest; das unversionierte Beispiel ist kein unveränderlicher Versionsstand.
Hier wurde kein Container gestartet. Prüfe auf deinem System außerdem vorhandene Portbelegung und einen bereits verwendeten Containernamen, statt bestehende Dienste dafür zu löschen.
Collection, Point und Payload unterscheiden
| Teil | Aufgabe |
|---|---|
| Collection | Ein benannter Bestand mit festgelegter Vektorkonfiguration. |
| Point-ID | Die Kennung eines gespeicherten Punkts. |
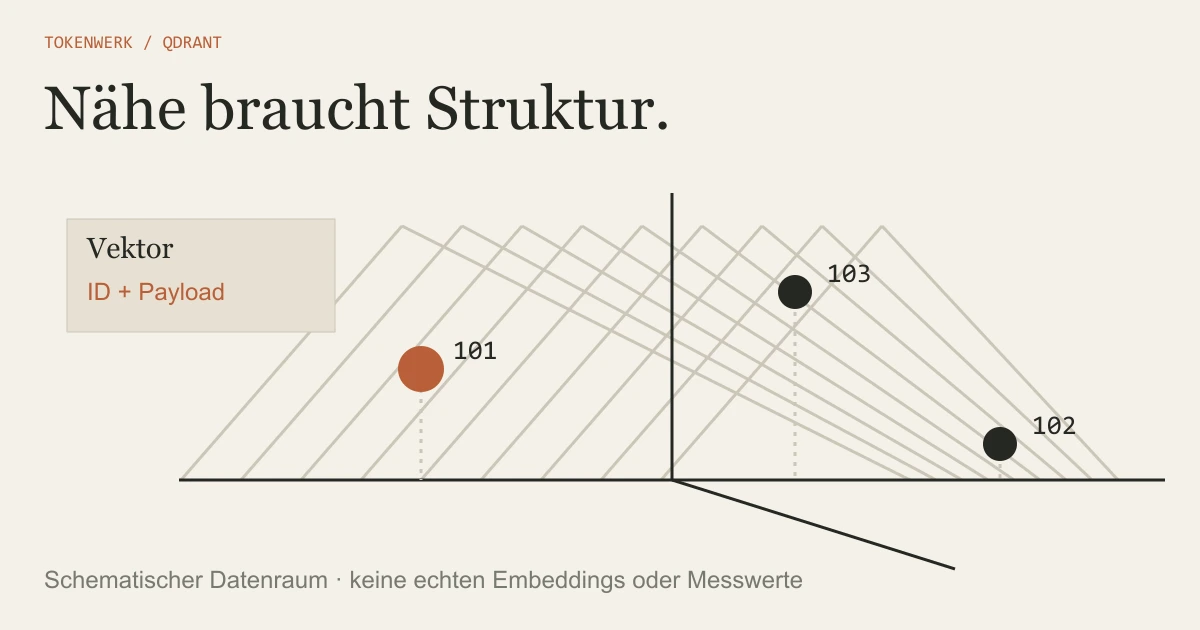
| Vektor | Eine geordnete Zahlenfolge mit passender Dimension. |
| Payload | Zusätzliche Daten wie Quelle oder Bereich; nicht automatisch ein Zugriffsrecht. |
| Metrik | Die gewählte Vergleichsregel, hier Dot Product. |
Unsere eigenen Punkte sind ausdrücklich keine Embeddings:
Eigene künstliche Testpunkte
101: [1.0, 0.0, 0.0] · Quelle TW-A · Bereich public
102: [0.0, 1.0, 0.0] · Quelle TW-B · Bereich public
103: [0.8, 0.2, 0.0] · Quelle TW-C · Bereich intern
Abfrage: [1.0, 0.0, 0.0] · Dimension 3 · Dot ProductDie Zahlen sind so gewählt, dass man ihre Produkte von Hand nachvollziehen kann. Sie belegen keine semantische Nähe von echten Texten und kein Ranking einer produktiven Dokumentensammlung.
Eine kleine Suchprobe nachvollziehen
Das eigene Python-Beispiel verwendet den offiziellen Client mit den im Quickstart dokumentierten Schritten create_collection, upsert und query_points. Es benötigt das Paket qdrant-client in deiner gewählten Python-Umgebung und eine bereits laufende getrennte lokale Testinstanz.
Abhängigkeit und bewusster Start nach dem Speichern
python -m pip install qdrant-client
python qdrant-lernprobe.pyLade die eigene Qdrant-Lernprobe als Textdatei herunter und speichere sie für den bewussten Lauf als qdrant-lernprobe.py. Lies sie vorher. Sie erstellt einen neuen, fest benannten Lernbestand und löscht oder ersetzt keine bestehende Collection. Existiert der Name schon, stoppt die Anlage; verwende für einen weiteren Versuch einen neuen eigenen Namen.
Der Aufbau prüft drei endliche Zahlen pro Vektor und eindeutige IDs. Die Abfrage fordert den Payload ausdrücklich mit an. Die erwarteten Dot-Produkte des selbst gewählten Datensatzes sind rechnerisch 1,0, 0,8 und 0,0. Das sind keine von uns beobachteten Datenbankergebnisse.
Wir prüfen Syntax und den Aufrufvertrag mit einer simulierten Clientantwort; ein echter Qdrant-Lauf ist nicht behauptet. Wenn der Zahlenweg klar ist, kannst du Echte Embeddings in einer lokalen RAG-Probe kennenlernen. Deren Dimension und Bedeutung darfst du nicht durch unsere Kunstvektoren ersetzen.
Die Suche mit Metadaten begrenzen
Die zweite Abfrage der Lernprobe verlangt im Payload bereich = public. Damit bleiben unter unseren eigenen Annahmen die IDs 101 und 102 als Kandidaten. ID 103 fällt heraus, obwohl ihr künstlicher Vektor näher am Abfragevektor liegt als der von 102.
Das verdeutlicht eine separate Bedingung: Ähnlichkeit und fachliche Zulässigkeit sind verschiedene Fragen. Der Payloadwert ist hier aber nur ein Spielwert. Wenn ein Client ihn selbst wählen oder ändern darf, ist das kein belastbarer Nachweis einer Berechtigung.
Für echte Daten muss die Anwendung die Zugriffsgrenze aus einer vertrauenswürdigen Identität ableiten und in allen relevanten Lesewegen durchsetzen. Die Datenbankdokumentation behandelt API-Rechte und Netzschutz getrennt von der Suchbedingung. Für große gefilterte Bestände sind zusätzlich passende Payloadindizes und eine eigene Leistungsprüfung relevant.
Vor echten Dokumenten den Betrieb klären
Plane Datenhaltung, Sicherung, Wiederherstellung, Updates und Zuständigkeit. Prüfe vor einem Upload, ob die Inhalte überhaupt in diesen Bestand gehören. Die Lektion Private Daten vor dem Speichern oder Hochladen prüfen hilft bei dieser ersten Entscheidung.
Beim echten Embeddingweg gehören Modellkennung, Dimension und Metrik zur Datenversion. Gleiche Vektorlänge allein beweist nicht, dass zwei unterschiedliche Embeddingmodelle denselben Suchraum verwenden. Ein Wechsel braucht einen passenden Plan für Neuaufbau und Prüfung.
Qdrant dokumentiert unter anderem Admin-, Read-only- und collectionspezifische Rechte. Dazu kommen Netzbindung und TLS. Ein eigenes öffentliches System muss diese Punkte gezielt konfigurieren; ein verwaltetes Angebot hat eine andere Verantwortungsverteilung. Unser lokaler Lerncontainer und die drei Zahlenvektoren sind keine Freigabe für produktive Kundendaten.
Quellen & Methode
Vorgehen und Grenzen
Originalquellen am 20. Oktober 2026 im dokumentierten Umfang geprüft. Vier ausgewählte vollständige Haupttexte pro Thema symmetrisch verglichen. Beispiele und Grafiken sind eigene Lernhilfen. Rechenwerte und simulierte Clientaufrufe sind von echten Produktläufen getrennt; keine Botnachricht, Datenbankinstallation, Anbieterübertragung oder Modellmessung behauptet. Das Smartphone-Cover ist ein erzeugtes Konzept, kein echtes Produktfoto.
Bei Recherche, Texterstellung und Grafiken wird KI eingesetzt. Welche eigenen Versuche vorliegen und was nur als Beispiel dient, beschreibt dieser Beitrag. Unser Redaktionsstandard erklärt die Anforderungen an Belege und Berichtigungen.