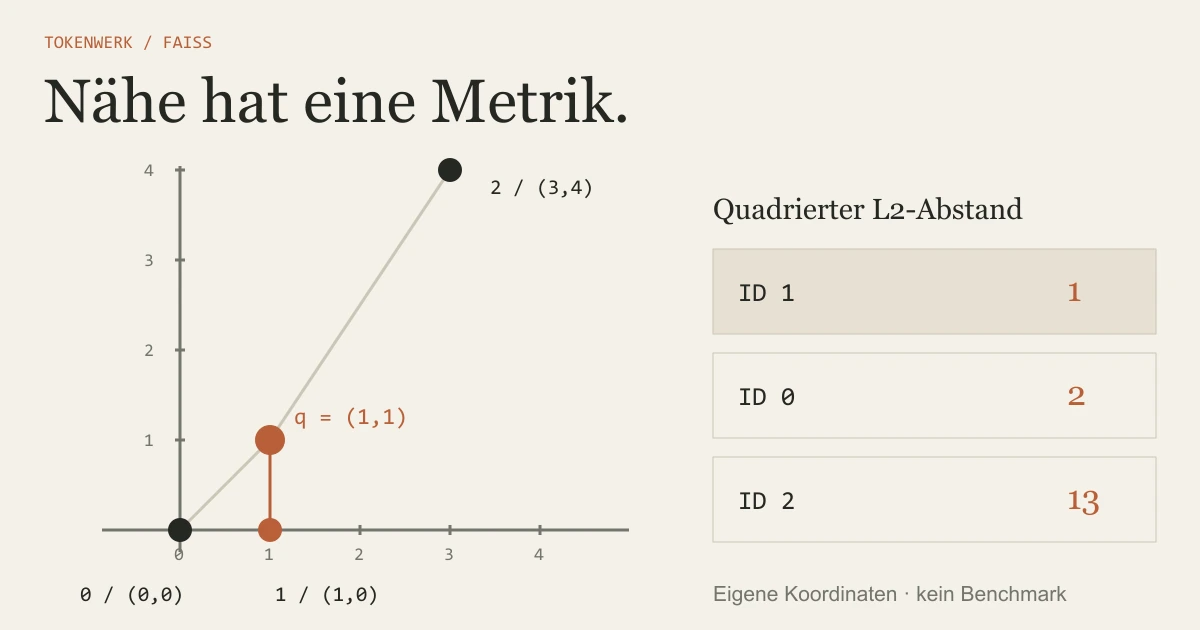
Beginne mit einer kleinen exakten Suche und rechne deren Ergebnis nach. Achte auf gleiche Dimensionen und die gewählte Metrik. Bei FAISS-L2 sind die ausgegebenen Werte quadrierte Abstände; ein größerer oder kleinerer Score bedeutet nicht bei jeder Metrik dasselbe.
Was FAISS macht und was du zusätzlich brauchst
FAISS stammt aus dem Meta-Umfeld und bietet Algorithmen für Ähnlichkeitssuche und Clusterbildung. Das Projekt ist vorwiegend in C++ umgesetzt und stellt unter anderem Python-Schnittstellen bereit. Einige Verfahren können auf unterstützten GPUs laufen.
Der zentrale Baustein ist ein Index. Er enthält Vektoren und ermöglicht die Suche nach Nachbarn anhand eines festgelegten Vergleichsmaßes. Ein Index erzeugt dadurch noch keine Text-Embeddings, verwaltet nicht automatisch sämtliche Anwendungsrechte und formuliert keine belegte Antwort.
Für eine Anwendung bleiben Dokumente, Kennungen, Herkunft und Zugriffsregeln zusätzlich zu organisieren. Wenn du eine vollständige Datenplattform suchst, solltest du die Aufgaben einer Vektordatenbank einordnen. Eine Suchbibliothek und ein kompletter Dienst sind unterschiedliche Bausteine. Wie sich Records mit Dokumenten und Metadaten ablegen und abfragen lassen, zeigt der Einstieg in Chroma DB.
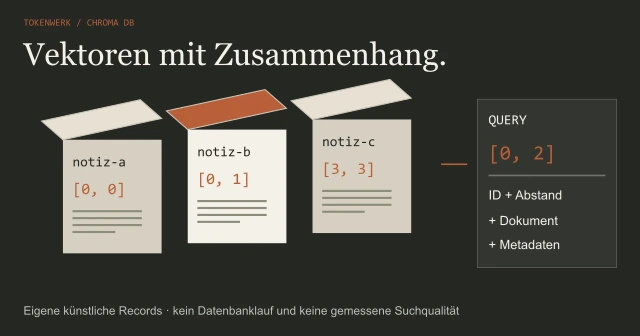
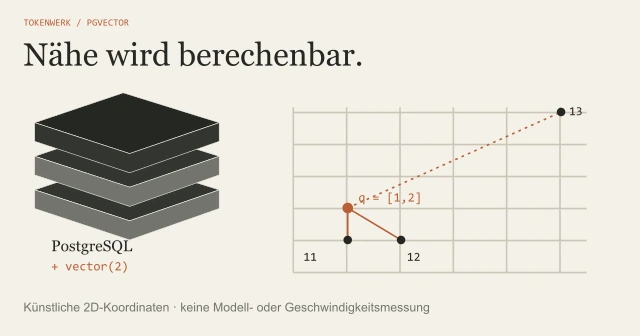
Unsere Lernprobe verwendet absichtlich nur drei zweidimensionale Koordinaten. Sie sind frei erfunden und haben keine behauptete semantische Bedeutung.
Drei Vektoren und eine Suchfrage nachrechnen
| ID | Vektor | Rechnung | Ergebnis |
|---|---|---|---|
| 0 | (0, 0) | (1 − 0)² + (1 − 0)² | 2 |
| 1 | (1, 0) | (1 − 1)² + (1 − 0)² | 1 |
| 2 | (3, 4) | (1 − 3)² + (1 − 4)² | 13 |
Die aufsteigende Reihenfolge ist damit ID 1, ID 0, ID 2. Die zugehörigen Werte lauten 1, 2, 13. Es gibt in dieser Probe keine Gleichstände.
FAISS berichtet für L2 den quadrierten euklidischen Abstand, damit die Wurzelberechnung entfallen kann. Die Reihenfolge bleibt gegenüber dem gewöhnlichen euklidischen Abstand gleich. Der Wert 13 ist also kein Abstand von 13 Längeneinheiten; dafür wäre die Quadratwurzel nötig.
Der eigene Vektordatensatz samt Sollwerten lässt sich unabhängig nachrechnen. Die Zahlen sind keine gemessenen Suchergebnisse, Text-Embeddings oder Leistungsscores eines Modells.

Das Beispiel mit IndexFlatL2 ausdrücken
Die offizielle Einführung verwendet IndexFlatL2 als einfache exakte Baseline. Bei diesem Index entfällt ein gesondertes Training des Suchindex. Das ist etwas anderes als das Training eines Embedding-Modells.
Voraussetzung des folgenden Beispiels sind eine dafür geeignete Python-Umgebung mit NumPy und FAISS gemäß den offiziellen Installationsunterlagen. Die Vektoren haben dieselbe Dimension und werden hier als float32-Matrizen übergeben. Dieser Artikel installiert die Bibliotheken nicht.
Dokumentationsgestütztes eigenes Python-Beispiel
import numpy as np
import faiss

# Eigene fiktive Koordinaten, keine Text-Embeddings.
xb = np.array([[0, 0], [1, 0], [3, 4]], dtype="float32")
xq = np.array([[1, 1]], dtype="float32")

index = faiss.IndexFlatL2(2)
index.add(xb)
distances, ids = index.search(xq, 3)
print(ids)
print(distances)
# Rechnerische Sollwerte: IDs [[1, 0, 2]], Abstände [[1, 2, 13]].
# Dokumentationsgestütztes Beispiel, hier nicht mit FAISS ausgeführt.add fügt die drei Zeilen hinzu. Im einfachen Flat-Beispiel entsprechen die Kennungen ihrer Einfügereihenfolge ab null. search erhält die Querymatrix und die gewünschte Anzahl der Nachbarn.
Die Kommentare nennen unsere rechnerischen Sollwerte. Der Code wurde hier nicht mit FAISS ausgeführt. Wenn du ihn selbst laufen lässt, vergleiche die tatsächlich ausgegebenen IDs und Werte mit der Tabelle, bevor du echte Dokumente einbindest.
L2, Inner Product und Kosinus unterscheiden
Bei L2 werden kleinere Abstände zuerst gesucht. Bei Inner Product stehen größere Skalarprodukte für das jeweilige Suchziel. Solche Zahlen dürfen nicht ohne Metrikangabe in eine gemeinsame Rangliste geraten.
Kosinusähnlichkeit entspricht dem Skalarprodukt, wenn Daten- und Anfragevektoren passend auf Länge eins normalisiert sind. Die offizielle Metrikreferenz beschreibt diesen Weg. Ein Nullvektor wie unsere ID 0 kann nicht durch seine Länge normalisiert werden; er braucht dafür einen bewusst definierten Umgang oder muss aus dieser Kosinusprobe ausgeschlossen werden.
Eine andere Metrik kann eine andere Nachbarschaft ergeben. Das ist nicht automatisch ein Fehler, sondern eine andere mathematische Frage. Prüfe, welche Metrik zum verwendeten Embedding-Modell und zur Aufgabe passt.
Bei Texten solltest du außerdem semantische Suchtreffer unabhängig vom Score prüfen. Ein naher Vektor beweist weder Richtigkeit noch Vollständigkeit oder die Berechtigung, die zugehörige Passage zu zeigen.
Indexwahl an Daten und Aufgabe prüfen
Die Projektunterlagen beschreiben Zielkonflikte zwischen Suchzeit, Suchqualität, Speicher, Indexaufbau und zusätzlichem Trainingsbedarf. Es gibt deshalb keinen allgemeinen besten Index unabhängig von Datenmenge und Aufgabe.
Eine kleine exakte Basis erleichtert den Abgleich. Für größere Bestände können andere Strukturen oder komprimierte Repräsentationen sinnvoll sein. Prüfe dabei die tatsächlich verpassten Nachbarn und fachlichen Treffer; ein schnelleres Verfahren ist nicht automatisch die bessere Anwendung.
Die I/O- und Tuning-Hilfe unterscheidet Aufbauparameter und zur Suchzeit veränderliche Parameter. Eine Parameterkombination aus einem fremden Benchmark ist kein bewiesenes Optimum für deinen Bestand. Laufzeiten hängen auch von Hardware, Daten, Parallelität und Messaufbau ab.
Wenn Vektoren eng mit vorhandenen relationalen Daten zusammengehören, kannst du Vektorsuche innerhalb von PostgreSQL vergleichen. Vergleiche dieselbe Aufgabe und die nötige Betriebsfunktion, nicht nur zwei Produktnamen.
Indexdateien und Dokumentzuordnung verlässlich halten
FAISS kann geeignete Indizes speichern und wieder einlesen. Die offizielle I/O-Hilfe warnt ausdrücklich vor fehlerhaften oder manipulierten Indexdateien: Beim Laden können Speicherprobleme und unter Umständen Codeausführung entstehen. Lade daher keine ungeprüfte fremde Indexdatei als harmlose Datensammlung.
Halte die Herkunft und Integrität eigener gespeicherter Dateien nachvollziehbar. Dokumentiere FAISS-Version, Indextyp, Dimension, Metrik, Normalisierung und den zugehörigen Dokumentstand. Eine Kennung muss weiterhin auf die richtige Quelle zeigen.
Bei einer Änderung von Embedding-Modell, Datenbestand oder Vorverarbeitung ist die vorhandene Zuordnung erneut zu prüfen. Ein erfolgreich geladener Index beweist nicht, dass er zur aktuellen Anwendung passt.
Stand: 20. Oktober 2026. Vier aktuelle Projektoriginale wurden vollständig gelesen. Es wurde keine FAISS-Software installiert, kein fremder Index geladen und kein FAISS-Benchmark ausgeführt. Die kleine Abstandstabelle ist eine eigene unabhängig kontrollierte Rechenprobe.
Quellen & Methode
Vorgehen und Grenzen
Vier offizielle Projekttexte geprüft. Eigene fiktive Koordinaten und Abstände unabhängig nachgerechnet. Der dokumentationsgestützte Python-Code wurde hier nicht mit FAISS ausgeführt.
Bei Recherche, Texterstellung und Grafiken wird KI eingesetzt. Welche eigenen Versuche vorliegen und was nur als Beispiel dient, beschreibt dieser Beitrag. Unser Redaktionsstandard erklärt die Anforderungen an Belege und Berichtigungen.