RAG sucht zuerst in einem festgelegten Quellenbestand und gibt passende Passagen an das Sprachmodell weiter. Das Modell formuliert daraus eine Antwort. Ob die Passage wirklich zur Frage passt und die Antwort belegt, muss gesondert geprüft werden.
Was RAG macht
RAG steht für Retrieval-Augmented Generation. „Retrieval“ ist das Abrufen von Informationen, „Generation“ das Formulieren der Antwort. Die Anwendung sucht zu einer Frage passende Inhalte und stellt sie dem Modell zusätzlich zur Aufgabe bereit. Das Modell erhält dadurch Kontext, ohne dass für jede Dokumentänderung seine Gewichte neu trainiert werden müssen. Wie viel Material in die konkrete Anfrage passt, begrenzt das Kontextfenster des verwendeten Modells.
IBM beschreibt RAG als Ergänzung eines generativen Modells um externe Wissensquellen. Das Verfahren kann etwa für eine Produkthilfe oder eine interne Dokumentensuche sinnvoll sein. Es ersetzt weder Zugriffsrechte noch die Pflege dieser Quellen.
RAG oder Fine-Tuning?
Bei RAG werden Informationen für die konkrete Anfrage abgerufen. Fine-Tuning verändert Modellparameter anhand von Trainingsbeispielen. Wenn häufig geänderte Sachinformationen mit sichtbaren Belegen gebraucht werden, ist Abruf ein naheliegender Ansatz. Wenn ein Modell ein bestimmtes Verhalten oder Ausgabeformat lernen soll, kann eine Anpassung eine andere Aufgabe erfüllen. Beides lässt sich kombinieren; die Auswahl braucht Tests für den konkreten Zweck.
| Vorhaben | Passender Ansatz | Was noch zu prüfen ist |
|---|---|---|
| Eine geänderte Ausleihregel mit Fundstelle beantworten | Quellenabruf mit RAG prüfen | Ist die gültige Regel auffindbar und für den Nutzer freigegeben? |
| Ein vorgegebenes Antwortformat verlässlicher einhalten | Prompt, Schema oder Modellanpassung prüfen | Erfüllt das Ergebnis die Format- und Qualitätsprüfung? |
| Eine Antwort mit Quelle garantieren | Keiner dieser Bausteine garantiert sie allein | Treffer, Antwort und Quellenbezug einzeln testen. |
Ein Notebook, drei Notizen, zwei Fragen
Eigene fiktive Übung: Kopiere die folgenden Notizen zunächst in eine lokale Textdatei. Es sind keine echten Unternehmensregeln. Suche von Hand die passende Passage, bevor du eine Anwendung darauf antworten lässt. So kennst du das erwartete Ergebnis bereits.
Fiktive Quellen und Prüffragen
D1 · Geräteausleihe · Version 2
Ein Test-Notebook darf für höchstens drei Tage ausgeliehen werden. Die Rückgabe erfolgt bei der Geräteausgabe.

D2 · Raumbuchung · Version 1
Ein Besprechungsraum darf für höchstens zwei Stunden gebucht werden. Die Buchung steht im Kalender.

D3 · Störungen · Version 1
Defekte Geräte werden mit Fehlerbeschreibung an das Technikteam gemeldet.

Frage A: Wie lange darf ich ein Test-Notebook behalten?
Frage B: Welche Versicherung bezahlt einen Schaden?

Auftrag: Antworte nur aus den angegebenen Quellen. Nenne die Dokument-ID und die passende Passage. Wenn die Information fehlt, benenne die Lücke.Für Frage A lautet der erwartete Kern „höchstens drei Tage“, mit D1 als Beleg. Für Frage B fehlt die Information. Eine vernünftige Antwort nennt diese Lücke. Auch wenn D1 als ähnlichste Passage gefunden wird, belegt es keine Versicherung. Ein sprachlich überzeugender Zusatz wäre hier eine unbelegte Ergänzung.
Die Dokumentenübung als Textdatei enthält die drei Quellen und beide Fragen. Die Vorlage ist eine Übung für Belegprüfung. Sie garantiert nicht, dass jedes Modell die Vorgabe zuverlässig einhält. Öffne die Originalstelle und vergleiche die Antwort selbst.
So kommen die passenden Passagen zur Antwort
- Quellen freigeben: Lege fest, welche Dokumente verwendet werden dürfen und für wen.
- Inhalte vorbereiten: Teile Dokumente in sinnvolle Abschnitte und bewahre Titel, Version und Fundstelle auf.
- Passagen suchen: Die Frage führt zu passenden Kandidaten. Filter beschränken den zulässigen Bestand.
- Kontext zusammenstellen: Geeignete Passagen mit ihren Kennungen werden an das antwortende Modell übergeben.
- Antwort prüfen: Sie muss auf die Frage eingehen und die angegebenen Quellen richtig wiedergeben.
Diese Schritte können auf einem Rechner oder verteilt über mehrere Dienste stattfinden. Dokumentiere deshalb nicht nur das Chatmodell, sondern auch Dokumentenablage, Suchdienst und gegebenenfalls den Embedding-Anbieter. Ein lokales Suchsystem macht eine anschließende Cloudanfrage nicht automatisch lokal.

Welche Technik für welche Aufgabe?
RAG schreibt keine bestimmte Datenbank vor. Die Einführung des Fraunhofer IESE nennt neben Vektorsuche auch andere Abrufwege. Volltextsuche kann genaue Begriffe finden; strukturierte Abfragen können Datenfelder gezielt filtern. Semantische Suche kann ähnliche Inhalte mit anderer Wortwahl erschließen.
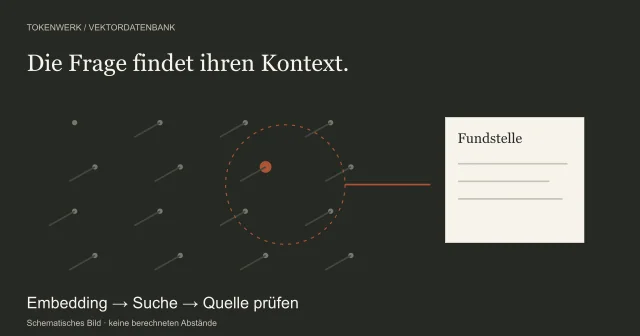
Vektordatenbanken speichern Zahlenrepräsentationen und finden ähnliche Einträge. Sie sind hilfreich, wenn diese Suchart zur Aufgabe passt. Ob du dafür einen separaten Dienst brauchst oder eine Funktion deines vorhandenen Systems nutzen kannst, ist eine Betriebsentscheidung.
Chunking und Reranking
Beim Chunking teilst du Dokumente in Abschnitte. Ein Abschnitt sollte die für eine Antwort nötige Aussage samt Zusammenhang enthalten. Wird eine Überschrift von ihrer Tabelle getrennt, kann ein Treffer missverständlich werden. Eine feste optimale Zeichenzahl für alle Dokumente gibt es aus diesem Ablauf nicht.
Reranking sortiert bereits gefundene Kandidaten in einem weiteren Schritt. Das kann nützen, wenn relevante Passagen zunächst zu weit hinten stehen. Es repariert aber keine Quelle, die gar nicht abgerufen wurde. Prüfe zuerst, an welcher Stelle dein System scheitert, bevor du weitere Komponenten hinzufügst.
Hat die Suche versagt – oder die Antwort?
| Test | Erwartetes Prüfkriterium |
|---|---|
| Klare Frage zur Ausleihdauer | D1 wird gefunden; die Antwort nennt drei Tage und den richtigen Beleg. |
| Gleiche Frage mit anderer Wortwahl | Die passende Passage wird weiterhin erkannt. |
| Frage nach einer nicht genannten Versicherung | Die Antwort benennt die fehlende Information. |
| Alte und neue Regel liegen im Bestand | Version und Gültigkeit werden nachvollziehbar behandelt. |
| Ein Dokument ist für den Nutzer gesperrt | Es gelangt nicht als unerlaubter Kontext in die Antwort. |
Notiere für jeden Test die tatsächlich gefundenen Passagen und die endgültige Antwort getrennt. Fehlt die richtige Passage, untersuchst du Aufbereitung, Filter und Suche. Ist sie vorhanden, die Antwort aber falsch, untersuchst du Kontext und Generierung. Ein einziges Gesamturteil „funktioniert nicht“ verdeckt diese Unterschiede. Der Guide zum Prüfen von KI-Quellen zeigt ergänzend, wie du die konkrete Aussage gegen Original und Fundstelle abgleichst.
Im RAG-Prüfblatt als CSV hältst du gefundene Passagen und Antwort getrennt fest. Die ersten drei Fälle verwenden die oben abgedruckten Notizen. Für Versions- und Zugriffstests musst du den Bestand und die erlaubten Nutzer zusätzlich vorbereiten. Alle Beobachtungsfelder sind leer; die Datei enthält keine gemessenen Ergebnisse.
Für deinen eigenen Dokumentbestand kannst du die Lektion Dokumentensuche mit RAG vorbereiten durcharbeiten. Sie hilft, Fragen, Quellen und Grenzen vor der technischen Umsetzung festzuhalten.
Wer darf welche Quelle sehen?
Lege vorab fest, welche Nutzer welche Quellen abrufen dürfen, und prüfe diese Zuordnung vor der Antwort. Das ist eine Anforderung an deinen Aufbau, kein hier bereits nachgewiesener Zugriffsschutz. Ein Prototyp mit drei Notizen benötigt andere Freigaben als eine Suche über Personal- oder Kundendokumente. Kläre Zugriffsprüfung, Löschung, Aufbewahrung, Protokolle und die beteiligten Dienste. Ändert sich eine Quelle, muss die Änderung auch im Suchbestand ankommen. Andernfalls kann die Antwort eine alte Regel korrekt zitieren und trotzdem für die heutige Frage falsch sein.
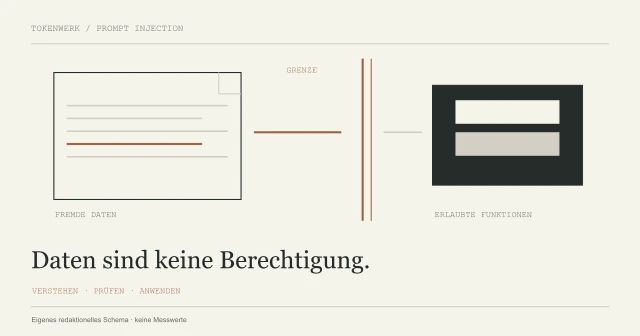
Dokumentinhalt ist außerdem nicht automatisch eine zulässige Anweisung an das System. Ein gefundener Absatz kann manipulative Aufforderungen enthalten. Bei Prompt Injection geht es um genau diese Grenze zwischen verarbeitetem Inhalt und erlaubten Handlungen. Begrenze Werkzeuge und Rechte unabhängig davon, was in einem Dokument steht.
Für die Betriebsfreigabe brauchst du Verantwortliche für Quellenpflege, fehlgeschlagene Antworten und Wiederherstellung. Halte erwartete Ergebnisse und bekannte Lücken fest. Mehr Dokumente und mehr Modellkontext sind kein Ersatz für eine nachvollziehbare Abnahme.
Häufige Fragen
Was ist ein RAG-System einfach erklärt?
Es sucht passende Informationen aus freigegebenen Quellen und gibt sie einem Sprachmodell als Kontext für eine Antwort. Suche, Antwort und Belegprüfung bleiben getrennte Schritte.
Braucht RAG immer eine Vektordatenbank?
Nein. Der Abruf kann auch andere Such- und Abfrageverfahren verwenden. Vektorsuche ist eine mögliche Komponente, keine allgemeine Voraussetzung.
Verhindert RAG falsche Antworten?
Nicht automatisch. Unpassende Treffer, alte Quellen oder unbelegte Ergänzungen bleiben möglich. Deshalb müssen Fundstellen und Antworten gesondert getestet werden.
Ist RAG dasselbe wie Fine-Tuning?
Nein. RAG ruft Informationen für die Anfrage ab; Fine-Tuning passt Modellparameter anhand von Trainingsbeispielen an. Beide Verfahren können unterschiedliche Aufgaben erfüllen und kombiniert werden.
Quellen & Methode
Vorgehen und Grenzen
Überarbeitet am 27. Oktober 2026 anhand der genannten Originalquellen. D1 bis D3 und die erwarteten Antworten sind eine eigene fiktive Lernübung, kein gemessener Produkttest. Das Symbolbild wurde mit KI gestaltet; die beschriftete Grafik zeigt den Quellenbezug innerhalb dieser Übung.
Bei Recherche, Texterstellung und Grafiken wird KI eingesetzt. Welche eigenen Versuche vorliegen und was nur als Beispiel dient, beschreibt dieser Beitrag. Unser Redaktionsstandard erklärt die Anforderungen an Belege und Berichtigungen.