Was ist semantische Suche?
Semantische Suche berücksichtigt die Bedeutung einer Anfrage und den Zusammenhang von Inhalten. Frage und Dokument müssen also nicht dieselben Wörter verwenden. Der englische Begriff lautet semantic search.
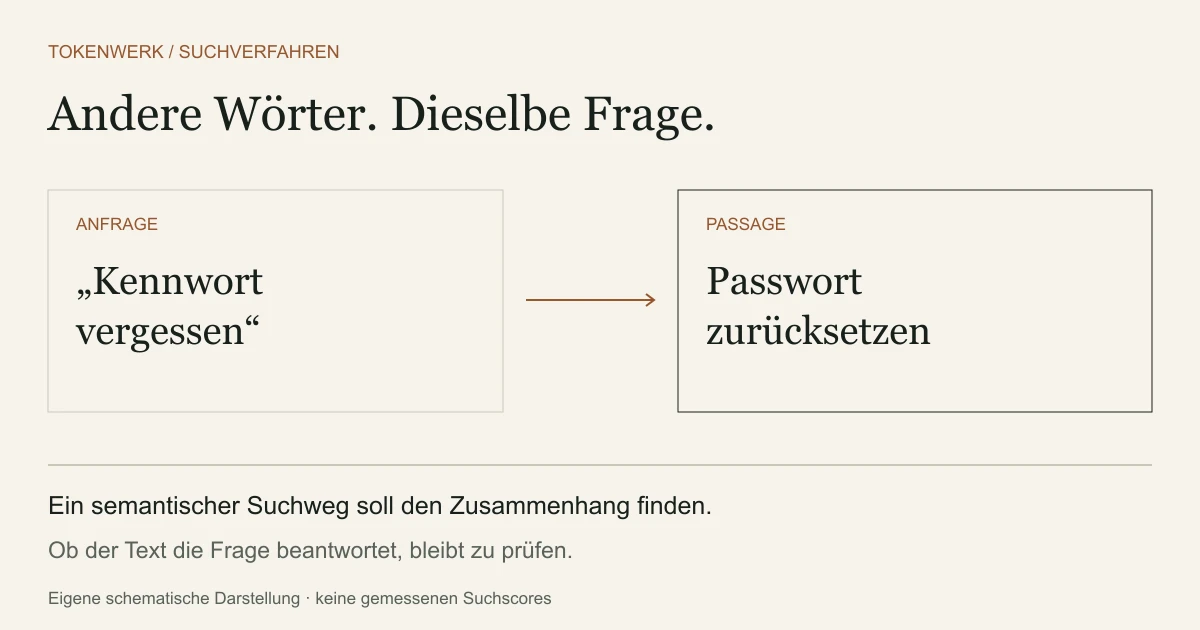
In unserem Beispiel ist das Ziel einfach: Wer sein Kennwort vergessen hat, soll die Anleitung zum Zurücksetzen des Passworts finden. Ein Text über die Kontolöschung wäre trotz ähnlicher Begriffe keine passende erste Hilfe.
Oft verwendet die Suche dafür Embeddings: Zahlenfolgen, die ein Modell aus Texten berechnet. Damit lassen sich Inhalte auf Ähnlichkeit vergleichen. Semantische Suche ist allerdings breiter als diese Vektorsuche; auch Beziehungen zwischen Begriffen oder strukturierte Wissensbestände können einfließen. Eine persönliche Suchhistorie ist dafür nicht erforderlich.
Semantische Suche oder Wortsuche: Was passt wann?
Wie findet die Suche nun unsere Passwort-Anleitung? Sie kann Wörter vergleichen, Bedeutungsnähe nutzen oder beides verbinden. Welche Variante passt, hängt von der Frage ab:
| Suchweg | Nützlich für | Worauf du achten musst |
|---|---|---|
| Wortsuche, etwa mit BM25 | Fehlercodes, Namen, eindeutige Begriffe | Andere Formulierungen können übersehen werden. Gute Wortsuche kann aber auch Synonyme, Wortformen und Schreibfehler behandeln. |
| Vektorsuche mit Embeddings | Inhaltlich ähnliche Fragen und Passagen mit unterschiedlichen Wörtern | Ein naher Treffer kann eine andere Kennung betreffen oder die gesuchte Angabe gar nicht enthalten. |
| Hybridsuche | Bestände mit frei formulierten Fragen und präzisen Begriffen | Wort- und Vektorergebnisse werden zusammengeführt. Gewichtung, Filter und Ergebnisqualität müssen am eigenen Bestand geprüft werden. |
Für „Kennwort vergessen“ lohnt sich der Blick auf Bedeutungsnähe. Bei einer Kennung wie INV-204 muss dagegen die genaue Zeichenfolge stimmen. Du musst eine funktionierende Wortsuche deshalb nicht sofort ersetzen. Schauen wir zunächst an, wie der Embedding-Weg aufgebaut ist.
Wie wird aus der Frage eine Trefferliste?
Ein Embedding-Suchweg bereitet zuerst die Dokumente vor. Erst bei einer Anfrage kommt die Suchfrage hinzu. Beide Wege treffen in der Kandidatenliste zusammen.
- Texte vorbereiten: Die Passwort-Anleitung und die anderen Dokumente werden in passende Passagen geteilt. Quelle und Dokument-ID bleiben dabei erhalten.
- Passagen abbilden: Das Modell berechnet für jede Passage einen Vektor, also eine Zahlenfolge. Für einen kleinen Versuch genügt eine Liste im Arbeitsspeicher.
- Frage abbilden: Auch „Kennwort vergessen“ wird mit der passenden Methode desselben Modells verarbeitet.
- Treffer suchen: Das System vergleicht die Vektoren und gibt die nächsten Kandidaten zurück. Einer davon kann die Passwort-Anleitung sein.
- Fundstelle lesen: Jetzt prüfst du, ob sie die Frage beantwortet und für die suchende Person zugänglich sein darf.

Bei größeren Beständen helfen besondere Indizes und Datenbanken beim Speichern und Abrufen. Mehr dazu im Guide Vektordatenbanken und Ähnlichkeitssuche verstehen.
Für die Umsetzung: das passende Embedding-Modell wählen
Eine kurze Frage gegen längere Passagen ist eine asymmetrische Suchaufgabe. Sentence Transformers unterscheidet dafür zwischen Anfrage- und Dokument-Encoding. Das gewählte Modell muss zur Aufgabe passen.
Zwei Vektoren gleicher Länge sind nicht automatisch sinnvoll vergleichbar. Auch bei einem Modellwechsel musst du prüfen, ob die vorhandenen Dokumentvektoren noch passen oder neu berechnet werden müssen.
Ein konkreter Modellkandidat für Text und weitere Medien ist EmbeddingGemma 2 für lokale Suche. Der eigene Guide erklärt Encoder, Eingabepräfixe und Vektorlängen. Unser oben beschriebener Suchweg bleibt derselbe; der nachfolgende Praxistest verwendet weiterhin das ausdrücklich genannte E5-Modell.
Damit der Ablauf greifbar wird, wenden wir ihn jetzt auf einen kleinen erfundenen Dokumentbestand an.
Das Beispiel: Welche Passage soll die Suche finden?
Bleiben wir beim Hilfecenter. Es enthält zunächst drei kurze Texte. Jeder bekommt eine ID, damit wir später eindeutig sagen können, welche Passage gefunden wurde.
| ID | Kernaussage |
|---|---|
| D1 | Ein vergessenes Passwort wird über einen Link auf der Anmeldeseite zurückgesetzt. |
| D2 | Rechnungen stehen unter Abrechnung. INV-204 bezeichnet hier eine fehlende zugeordnete Rechnungsnummer. |
| D3 | Kontolöschung, Passwortänderung und die Prüfung betroffener Daten vor einer Löschung. |
Für die Frage nach dem vergessenen Kennwort legen wir D1 als Sollpassage fest. Das bedeutet: D1 soll später in der Trefferliste stehen. Diese Erwartung halten wir vor dem Suchlauf fest.
Eine zweite Frage zeigt die Grenze: „Wie lange gilt der Rücksetzlink?“ D1 beschreibt den Link, nennt aber keine Gültigkeitsdauer. Die Suche kann also einen thematisch passenden Text liefern, der für die Antwort nicht ausreicht.
Der eigene Lernkorpus als JSON enthält die vollständigen ursprünglichen Texte und vier Sollfälle. Für den folgenden Versuch haben wir die drei Texte unverändert übernommen und um fünf weitere Hilfetexte ergänzt.
Was hat unser eigener Suchversuch ergeben?
In diesem kleinen Versuch lag die Sollpassage bei E5-small in neun von zehn beantwortbaren Fragen auf Platz eins, bei der BM25-Baseline in sieben von zehn. Der Embedding-Weg lag aber nicht immer richtig. Das Ergebnis gilt für diesen Datensatz und ist kein allgemeiner Qualitätsrang.
Am 26. Oktober 2026 haben wir dafür zwei Suchwege lokal ausgeführt.
Die Grundlage: acht erfundene Hilfetexte und zwölf vorab festgelegte Fragen. Zehn Fragen sind anhand der Texte beantwortbar. Bei zwei weiteren fehlt die gesuchte Angabe – so wie die Gültigkeitsdauer des Rücksetzlinks.
Verglichen wurden eine eigene einfache BM25-Baseline ohne Stemming und Synonyme sowie eine quantisierte ONNX-Version von multilingual-e5-small. In der Tabelle siehst du, wie oft die Sollpassage auf Platz eins oder unter den ersten drei Treffern lag:
| Suchweg | Sollpassage auf Platz 1 | Sollpassage unter den ersten 3 |
|---|---|---|
| Eigene BM25-Baseline | 7 von 10 | 7 von 10 |
| E5-small, quantisierte ONNX-Version | 9 von 10 | 10 von 10 |

Drei Treffer, an denen du den Unterschied erkennst
| Frage | Soll | BM25 | Embedding |
|---|---|---|---|
| „Wie lange darf ich den geliehenen Laptop behalten?“ | D6: Test-Notebook, höchstens drei Tage | Kein Treffer | D6 auf Platz 1 |
| „Ich möchte keine Rundmails mehr bekommen.“ | D8: Newsletter abbestellen | Kein Treffer | D1 auf Platz 1; D8 erst auf Platz 2 |
| „Was kostet es, das Test-Notebook auszuleihen?“ | Kein Preis angegeben | D6 auf Platz 1 | D6 auf Platz 1 |
Beim geliehenen Laptop fand nur der Embedding-Weg die Sollpassage. Bei „Rundmails“ lag er dagegen zunächst falsch: Der passende Newsletter-Text D8 kam erst auf Platz zwei.
Die Preisfrage macht einen anderen Fehler sichtbar. Beide Wege fanden den Notebook-Text D6, aber darin steht kein Preis. Aus diesem Treffer lässt sich keine Preisantwort ableiten.
Die zwei Fragen ohne belegte Antwort zählen deshalb nicht zu den zehn Trefferprüfungen. Der Embedding-Weg hat hier keinen Schwellenwert für „keine Antwort“ und liefert immer die nächsten Kandidaten. Die BM25-Baseline kann ohne Wortüberschneidung eine leere Liste liefern.
Alle zwölf Fragen und Rangfolgen ansehen
| Frage | Soll | BM25 | Embedding |
|---|---|---|---|
| Q1: Ich komme nicht mehr rein, weil ich mein Kennwort vergessen habe. | D1 | D1 | D1, D3, D2 |
| Q2: Wie setze ich mein Passwort zurück? | D1 | D1, D6 | D1, D3, D8 |
| Q3: INV-204 | D2 | D2 | D2, D5, D1 |
| Q4: Wo finde ich meine Rechnung? | D2 | D2, D5 | D2, D1, D5 |
| Q5: Löscht eine Passwortänderung mein Konto? | D3 | D3, D8 | D3, D1, D8 |
| Q6: Mein Handy ist weg. Wie kann ich mich trotzdem mit dem zweiten Faktor einloggen? | D4 | D4 | D4, D1, D3 |
| Q7: INV-205 | D5 | D5 | D5, D2, D1 |
| Q8: Wie lange darf ich den geliehenen Laptop behalten? | D6 | Kein Treffer | D6, D1, D3 |
| Q9: Wie reserviere ich ein Zimmer für ein Meeting? | D7 | Kein Treffer | D7, D1, D6 |
| Q10: Ich möchte keine Rundmails mehr bekommen. | D8 | Kein Treffer | D1, D8, D3 |
| Q11: Wie lange gilt der Rücksetzlink? | Nicht angegeben | D7 | D1, D7, D6 |
| Q12: Was kostet es, das Test-Notebook auszuleihen? | Nicht angegeben | D6 | D6, D1, D3 |
Was die Zahlen aussagen: Sie beschreiben diesen kleinen Lernversuch. Eine produktive Wortsuche mit Synonymen oder ein anderer Dokumentbestand kann anders abschneiden. Getestet wurde der Abruf von Texten, nicht die Richtigkeit generierter Antworten.
Messmethode, Modell und Wiederholung im Detail
Pro Dokument wurden Titel und Text gemeinsam verarbeitet. E5 erhielt die Präfixe query: und passage: , maskiertes Mean-Pooling und L2-Normalisierung. Verglichen wurden 384-dimensionale Vektoren per Kosinusähnlichkeit, mit einer Begrenzung auf 512 Tokens.
BM25 verwendete k1 = 1,5 und b = 0,75, Kleinschreibung und eine eingefrorene Stoppwortliste. Die Konvertierung stammt von Xenova; verwendet wurde die quantisierte ONNX-Datei, nicht das unquantisierte Basismodell.
Der erste Lauf wurde unverändert wiederholt. Rangfolgen und Rohscores waren auf dieser Umgebung exakt gleich: Windows, Python 3.12.10 und ONNX Runtime 1.26.0 auf CPU. Es wurden keine Antworten generiert und keine kostenpflichtigen Modell-APIs aufgerufen.
Modellrevision, Dateiprüfsummen, vollständige Einstellungen und beide Ergebnisdateien stehen im Versuchsdownload.
Versuch zum Nachbauen · ZIPErgebnisse · CSVRohscores · JSON
Die Ergebnisse geben uns nun zwei Fragen für die Fehlersuche: Fehlt die richtige Passage ganz – oder steht sie nur zu weit unten?
Was tun, wenn der Treffer nicht passt?
Prüfe zuerst, ob die Suche deine Frage ausreichend genau behandelt. Bei einer umformulierten Frage hilft Bedeutungsnähe. Bei einem Fehlercode muss dagegen die Kennung erhalten bleiben.
Unsere Texte zu INV-204 und INV-205 betreffen unterschiedliche Probleme. Im Versuch fanden beide Wege jeweils die korrekte Passage auf Platz eins. Diese zwei Fälle sind geprüft; daraus folgt keine Garantie für alle Kennungen.
Eine mögliche Kombination ist die Hybridsuche: Sie führt Wort- und Vektorergebnisse zusammen. Azure AI Search beschreibt dafür eine parallele Suche. Ob die Kombination für deinen Bestand hilft, musst du mit deinen Fragen prüfen.
Danach prüfst du den Inhalt selbst: Sind Sprache und Dokumentversion passend? Darf die Person den Text sehen? Bleibt eine Verneinung wie „nicht“ erhalten? Ein ähnlicher Treffer überspringt keine dieser Prüfungen.
Ist die richtige Passage schon vorhanden, steht aber zu weit unten, kommt als nächster Schritt eine Neusortierung infrage.
Wie lässt sich die Trefferreihenfolge verbessern?
Ein Reranker bewertet die bereits gefundenen Kandidaten erneut. Du kannst ihn dir als zweite Durchsicht der Trefferliste vorstellen. Was die erste Suche nicht geliefert hat, kann eine reine Neusortierung nicht nachholen.
Für die Fehlersuche ergibt sich diese Reihenfolge:
- Sollpassage fehlt: Prüfe den ursprünglichen Abruf.
- Sollpassage steht zu weit unten: Prüfe die Sortierung.
- Passage ist falsch oder veraltet: Korrigiere die Quelle; eine bessere Platzierung löst das Inhaltsproblem nicht.
Beim dokumentierten Azure Semantic Ranker werden bis zu 50 Kandidaten einer vorherigen BM25- oder RRF-Sortierung bewertet. Diese Grenze gilt für die beschriebene Azure-Funktion. Eine zusätzliche Anfrageumformulierung kann neue Suchläufe anstoßen; sie ist ein anderer Schritt als das Neusortieren.
Erst nach der Suche kann ein Sprachmodell aus den Passagen einen Antwortentwurf formulieren. Deshalb solltest du Retrieval von der Antwort eines RAG-Chatbots trennen: zuerst die Fundstellen prüfen, anschließend ihre Wiedergabe.
Wo lässt sich das außerhalb unseres Beispiels nutzen?
- Hilfecenter
- „Mein Handy ist weg“ soll die Anleitung zum verlorenen zweiten Anmeldefaktor finden. Der Nutzer muss den Fachbegriff nicht kennen.
- Technische Dokumentation
- „Datei zu groß“ kann zur Beschreibung einer Größenbegrenzung passen. Für eine konkrete Fehlermeldung wie
INV-204muss zusätzlich die exakte Kennung stimmen. - Produktsuche
- „Leichte Jacke für Regen“ beschreibt eine Aufgabe. Größe, Verfügbarkeit und Preis bleiben separate strukturierte Filter; ein ähnlicher Produkttext erfüllt sie nicht automatisch.
Das Hilfecenter ist nur ein möglicher Einsatz. Dieselbe Trennung zwischen passendem Treffer und ausreichender Information hilft auch bei anderen Aufgaben:
Diese drei Szenarien sind Beispiele, keine gemessenen Kundenergebnisse. Für deinen eigenen Bestand gehst du genauso vor wie im kleinen Versuch: erst Fragen und Sollpassagen festlegen, dann suchen und auswerten.
So prüfst du deine eigene Suche
Du musst nicht sofort ein großes Suchsystem bauen. Beginne mit wenigen Dokumenten und Fragen, deren Antworten du selbst kontrollieren kannst.
- Material wählen: Verwende Dokumente, die du prüfen und lokal verarbeiten darfst.
- Fragen festlegen: Nimm normale Formulierungen, Umschreibungen, genaue Kennungen und mindestens eine Frage ohne belegte Antwort auf.
- Sollpassagen zuordnen: Halte die richtigen Dokument-IDs vor dem Lauf fest. Nicht erst nach Sichtung der Ergebnisse passend machen.
- Rangfolgen vergleichen: Notiere, ob der Solltext auf Platz eins oder in den ersten drei Kandidaten steht. Bewerte fehlende Angaben getrennt.
- Fehler einordnen: Fehlende Passage, falsche Reihenfolge, veralteter Text und erfundene Antwort sind unterschiedliche Probleme.
Zum Nachbauen unseres Versuchs brauchst du eine passende Python-Umgebung. Entpacke die ZIP-Datei in einen eigenen Ordner, lies die enthaltene Anleitung und installiere dort die drei festgelegten Pakete. Der separate Modellabruf lädt rund 136 MB herunter. Auf dieser Webseite selbst wird kein Modell geladen.
Im entpackten Versuchsordner · Python 3.12
python -m venv .venv
# Windows PowerShell:
.venv\Scripts\python -m pip install -r requirements.txt
.venv\Scripts\python download_model.py --model-dir model
.venv\Scripts\python run_search.py --model-dir model --output mein-lauf.jsonDie Anleitung enthält auch die Aufrufe für macOS und Linux. Eine neue Datei pro Lauf bewahrt frühere Ergebnisse. Bei einem anderen Betriebssystem oder anderer Rechenhardware können sich kleine Zahlenabweichungen ergeben.
Zum Abschluss solltest du gefundene Aussagen an der Originalquelle prüfen. Ein hoher Ähnlichkeitswert ist keine Wahrscheinlichkeit dafür, dass eine Aussage stimmt. Bei großen Beständen prüfst du zusätzlich, ob approximative Indizes beim schnelleren Abruf relevante Kandidaten verlieren.
Häufige Fragen zur semantischen Suche
Was bedeutet semantische Suche einfach erklärt?
Sie sucht nach dem inhaltlichen Zusammenhang. Eine Frage nach einem vergessenen Kennwort kann so zur Anleitung „Passwort zurücksetzen“ passen, obwohl die Wörter unterschiedlich sind. Ob die Passage die Frage wirklich beantwortet, bleibt zu prüfen.
Ist semantische Suche besser als eine Wortsuche?
Das hängt von der Aufgabe ab. Bedeutungsnähe hilft bei Umschreibungen; genaue Kennungen und Begriffe brauchen präzise Treffer. Eine gute Wortsuche kann Synonyme und Wortformen behandeln. Vergleiche die Verfahren an deinen eigenen Sollfällen.
Brauche ich dafür eine Vektordatenbank?
Für einen kleinen Versuch nicht. Unsere acht Dokumentvektoren werden direkt im Arbeitsspeicher verglichen. Bei größeren Beständen können ein Suchindex oder eine Vektordatenbank für Speicherung, Filter und effizienten Abruf sinnvoll sein.
Ist semantische Suche dasselbe wie RAG oder ChatGPT?
Nein. Die Suche liefert Fundstellen. RAG kombiniert den Abruf mit einem generierenden Modell, das daraus eine Antwort formulieren kann. Ein Chatprodukt kann solche Funktionen einsetzen, ist aber kein Synonym für das Suchverfahren.
Kann ein Reranker fehlende Dokumente wiederfinden?
Eine reine Neusortierung bewertet nur die übergebenen Kandidaten. Fehlt die richtige Passage, muss die ursprüngliche Suche geprüft werden. Die im Artikel genannten 50 Kandidaten sind eine dokumentierte Grenze der beschriebenen Azure-Funktion.
Sind die Zahlen im Praxistest echte Messergebnisse?
Ja. Am 26. Oktober 2026 wurden eine eigene einfache BM25-Baseline und eine quantisierte E5-ONNX-Version lokal ausgeführt und wiederholt. Auf Platz eins lagen 7 beziehungsweise 9 von 10 beantwortbaren Sollfällen richtig. Zwei Fragen ohne belegte Antwort wurden getrennt geprüft. Der kleine erfundene Korpus ist kein allgemeiner Produktbenchmark.
Quellen & Methode
Vorgehen und Grenzen
Recherche und Überarbeitung am 26. Oktober 2026. Vier vollständige Haupttexte wurden im Recherchepaket verglichen; zusätzliche Herstellerunterlagen und Modellkarten tragen die technischen Angaben. Der eigene lokale Versuch wurde vorab protokolliert und unverändert wiederholt. Korpus, Fragen, einfache BM25-Baseline, Modellrevision, Dateiprüfsummen und Rohscores sind im Download. Kein repräsentativer Benchmark, kein Kundentest und keine Messung generierter Antworten.
Bei Recherche, Texterstellung und Grafiken wird KI eingesetzt. Welche eigenen Versuche vorliegen und was nur als Beispiel dient, beschreibt dieser Beitrag. Unser Redaktionsstandard erklärt die Anforderungen an Belege und Berichtigungen.