Du brauchst für das Zahlenbeispiel Python und das Paket chromadb, aber keinen Cloudzugang und keinen API-Schlüssel. Richte zuerst die Lernumgebung ein, speichere dann drei Vektoren und vergleiche die Abfrage mit den Sollwerten. Der verwendete In-Memory-Client behält die Daten nicht über das Programmende hinaus.
Was Chroma DB für eine KI-Suche übernimmt
Chroma kann eine Collection nach ähnlichen Vektoren durchsuchen. Es schreibt dadurch keine verlässliche Antwort und bestätigt nicht, dass ein Dokument aktuell oder für eine bestimmte Person zugänglich ist. Diese Aufgaben bleiben in der Anwendung.
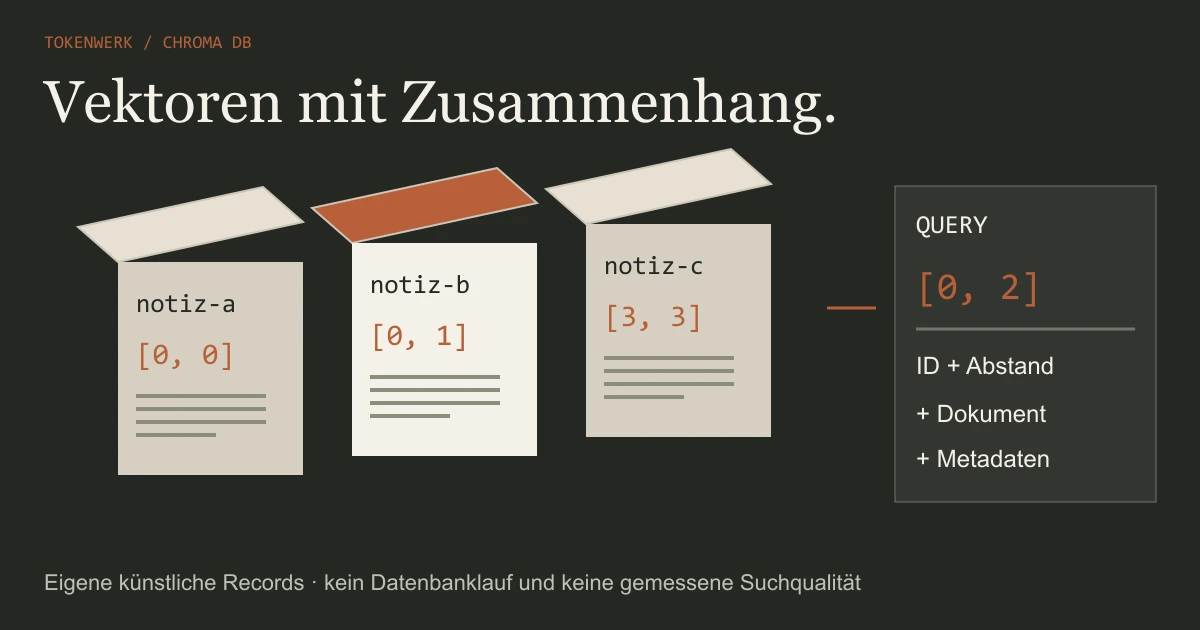
Eine Collection enthält Records. Jeder Record braucht eine eindeutige Zeichenketten-ID. Dazu kommen Embeddings sowie gegebenenfalls der zugehörige Text und Metadaten wie Herkunft oder Bereich. Die ID verbindet ein Suchergebnis mit dem richtigen Inhalt.
Wenn du die Bausteine noch sortierst, hilft der Einstieg: die Rolle einer Vektordatenbank verstehen. Die Datenbank, das Embedding-Modell und ein späteres Antwortmodell haben unterschiedliche Jobs.
Die folgende technische Illustration zeigt eigene Record-Bausteine und eine Abfrage. Sie verwendet kein erfundenes Produktlogo und bildet keine echte Chroma-Oberfläche ab.

Im Speicher beginnen und Persistenz bewusst wählen
Für den Einstieg zeigt die Python-Dokumentation chromadb.Client(). Das eignet sich für ein kleines Lernbeispiel im Speicher. Nach Ende des Programms darfst du nicht mit einer dauerhaft erhaltenen Datenbasis rechnen.
| Weg | Was du berücksichtigen musst |
|---|---|
| In-Memory-Client | Flüchtiger Lernlauf im laufenden Prozess. |
| Persistenter lokaler Client | Bewusst gewählter Speicherpfad; Sicherung und Zugriff selbst organisieren. |
| Client mit Server oder Cloud | Endpunkt, Zugang, Datenweg und Dienstkonfiguration separat prüfen. |
Auch die Indexkonfiguration hängt vom Betrieb ab. Die gelesene Dokumentation beschreibt HNSW für Single-Node-Collections und SPANN für die verteilte beziehungsweise Cloud-Variante. Übertrage einzelne HNSW-Parameter nicht ungeprüft auf die andere Betriebsform.
Für unser Beispiel brauchst du keine Cloud und keinen API-Schlüssel. In einer eigenen geeigneten Python-Lernumgebung benötigst du das Paket chromadb. Prüfe dessen aktuelle Installation und Version nach der verlinkten Herstelleranleitung; dieser Guide führt keine Installation aus.
Chroma DB installieren und das Beispiel starten
Arbeite in einem eigenen leeren Übungsordner. Du brauchst eine installierte, vom aktuellen Chroma-Paket unterstützte Python-Version und zunächst Internet für die Paketinstallation. Die virtuelle Umgebung hält die Pakete dieses Beispiels von anderen Python-Projekten getrennt.
Windows: PowerShell
Im Übungsordner ausführen
py -m venv .venv
.\.venv\Scripts\python.exe -m pip install chromadb
.\.venv\Scripts\python.exe -m pip show chromadbmacOS oder Linux: Terminal
Im Übungsordner ausführen
python3 -m venv .venv
.venv/bin/python -m pip install chromadb
.venv/bin/python -m pip show chromadbEine Aktivierung der Umgebung ist bei diesen Befehlen nicht nötig: Jeder Aufruf verwendet ausdrücklich deren Python. Fehlt schon py beziehungsweise python3, prüfe zuerst deine Python-Installation. Notiere die von pip show chromadb ausgegebene Paketversion.
Speichere anschließend den vollständigen Python-Code im nächsten Abschnitt als chroma_lernraum.py im Übungsordner. Starte ihn unter Windows mit .\.venv\Scripts\python.exe chroma_lernraum.py, unter macOS oder Linux mit .venv/bin/python chroma_lernraum.py.
Die Installation lädt Softwarepakete. Das anschließende Beispiel verwendet ausdrücklich eigene Zahlenvektoren und keine externe Embedding-API. Die Befehle und der Python-Code sind dokumentationsgestützte Anleitungen; wir haben damit hier keinen Chroma-Lauf ausgeführt. Die erwarteten Ausgaben weiter unten sind unabhängig berechnete Sollwerte.
Drei eigene Vektoren mit Dokumenten ablegen
Wir verwenden bewusst künstliche Koordinaten. Sie wurden nicht aus den Texten berechnet. Die Notizen sind nur Etiketten, damit du Records und Ergebnisfelder unterscheiden kannst. Eine Aussage über semantische Textqualität lässt sich daraus nicht ableiten.
Dokumentationsgestütztes Python-Lernbeispiel
import chromadb

# Eigenes Lernbeispiel: flüchtiger Client, explizite Zahlenvektoren.
client = chromadb.Client()
collection = client.create_collection(
    name="tokenwerk-lernraum",
    embedding_function=None,
    configuration={"hnsw": {"space": "l2"}},
)
collection.add(
    ids=["notiz-a", "notiz-b", "notiz-c"],
    embeddings=[[0.0, 0.0], [0.0, 1.0], [3.0, 3.0]],
    documents=["Erste fiktive Notiz.", "Zweite fiktive Notiz.",
               "Dritte fiktive Notiz."],
    metadatas=[{"bereich": "lernen"}, {"bereich": "lernen"},
               {"bereich": "archiv"}],
)
result = collection.query(
    query_embeddings=[[0.0, 2.0]],
    n_results=3,
    include=["documents", "metadatas", "distances"],
)
print(result["ids"][0])
print(result["distances"][0])Die expliziten Embeddings werden mit den Dokumenten abgelegt, ohne sie erneut einzubetten. embedding_function=None und query_embeddings machen den beabsichtigten Zahlenweg sichtbar. Das Beispiel benötigt keinen Aufruf eines externen Embedding-Anbieters.
Alle Vektoren haben dieselbe Dimension zwei. Die drei Listen für IDs, Vektoren und Dokumente gehören positionsweise zusammen. Die eigenen Lerndaten mit Sollwerten kannst du als JSON nachlesen.
Hier wurde Chroma nicht ausgeführt. Der Code wurde mit den Herstellertexten abgeglichen und auf Python-Syntax geprüft; die Sollwerte im nächsten Abschnitt stammen aus unabhängiger Mathematik.
Query, Get und Ergebnisfelder unterscheiden
query führt eine Ähnlichkeitssuche aus. Eine Anfrage kann mehrere Suchvektoren enthalten. Deshalb sind die Ergebnislisten pro Eingabe gruppiert: Bei einer einzigen Query findest du deren Treffer unter result["ids"][0] und die zugehörigen Abstände unter result["distances"][0].
get ruft Records nach Kennung oder Filter ab, ohne ein Ähnlichkeitsranking zu berechnen. Dafür wäre etwa collection.get(ids=["notiz-b"]) ein passender Zugriff. Die Get-Ergebnislisten sind nicht auf dieselbe Weise pro Suchvektor verschachtelt.
Mit include wählst du die benötigten zusätzlichen Felder; IDs werden immer geliefert. Im kleinen Datensatz begrenzen wir n_results ausdrücklich auf drei. Die dokumentierte Voreinstellung von zehn Treffern passt nicht zu jedem winzigen Lernbestand.
Metadatenfilter wie where={"bereich": "lernen"} begrenzen einen Suchbestand. Sie sind nicht von selbst ein vollständiges Berechtigungssystem. Die Anwendung muss erlaubte Datenquellen und Filter technisch durchsetzen.
L2-Abstände unabhängig nachrechnen
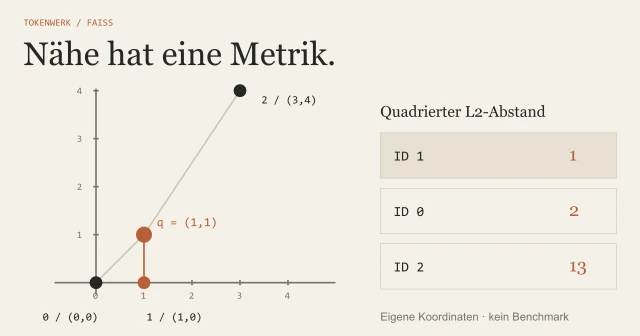
Die gewählte Konfiguration l2 verwendet den quadrierten L2-Abstand. Für unsere Query (0,2) rechnest du die quadrierten Koordinatendifferenzen zusammen.
| Record | Koordinaten | Quadrierter Abstand zu (0,2) |
|---|---|---|
| notiz-a | (0,0) | (0−0)² + (0−2)² = 4 |
| notiz-b | (0,1) | (0−0)² + (1−2)² = 1 |
| notiz-c | (3,3) | (3−0)² + (3−2)² = 10 |
Die rechnerische Sollreihenfolge lautet notiz-b, notiz-a, notiz-c. Das ist ein geometrischer Kontrollfall, kein tatsächlich gemessenes Chroma-Ergebnis. HNSW ist ein approximativer Suchindex; bei echten Daten muss die Trefferqualität geprüft werden.
Andere Metriken haben andere Bedeutungen und Voraussetzungen. Vergleiche Zahlen nicht einfach über verschiedene Metriken oder Embedding-Modelle hinweg. Für echte Texte musst du die Qualität semantischer Suchtreffer prüfen, beispielsweise mit passenden und bewusst unpassenden Fragen.
Wenn Installation oder Abfrage nicht funktioniert
Prüfe zuerst, an welchem Schritt es scheitert. Ändere nur die dazugehörige Einstellung und starte den kleinen Lernfall erneut. Die folgenden Fälle sind eine Diagnosehilfe, keine hier beobachteten Chroma-Fehlermessungen.
ModuleNotFoundError: chromadb
Prüfe: Installation und Skript können verschiedene Python-Umgebungen verwenden.
Nächster Schritt: Führe Installation, pip show und Skript mit demselben Python-Pfad aus dem Installationsabschnitt aus.
Textabfrage ohne Embedding-Funktion
Prüfe: Unsere Collection verwendet embedding_function=None.
Nächster Schritt: Verwende die gezeigten query_embeddings. Für query_texts brauchst du eine passende Embedding-Funktion.
Vektordimension passt nicht
Prüfe: Die Collection enthält zweidimensionale Vektoren.
Nächster Schritt: Prüfe die Zahl der Koordinaten jeder Eingabe. Ein anderer Embedding-Raum braucht eine passende getrennte Collection.
Erneutes add ändert einen Record nicht
Prüfe: Die ID existiert bereits; add ignoriert vorhandene Kennungen.
Nächster Schritt: Prüfe den Record mit get. Nutze zum Ändern den dokumentierten Update-Weg, statt add als Update zu behandeln.
Daten fehlen nach Programmende
Prüfe: Das Beispiel verwendet den flüchtigen Client chromadb.Client().
Nächster Schritt: Für dauerhafte Daten wählst du bewusst einen persistenten Client oder Serverbetrieb. Ein neuer Prozess mit demselben In-Memory-Code ist kein Persistenztest.
Bleibt ein Problem offen, notiere die vollständige Fehlermeldung, Python- und Chroma-Version, Clienttyp und den kleinsten auslösenden Code. Zugangswerte und private Dokumente gehören nicht in einen veröffentlichten Fehlerbericht.
Vom Lernbeispiel zur brauchbaren Suche
Vor einem echten Dokumentenbestand ersetzt du die künstlichen Koordinaten durch Embeddings eines geeigneten Modells. Dokumente und Abfragen müssen in denselben passenden Raum gelangen. Gleiche Dimensionen allein beweisen noch keine inhaltliche Kompatibilität.
Teste bekannte Treffer, fehlende Treffer, ausgeschlossene Quellen und aktualisierte Inhalte. Halte auch Dokumentherkunft, Chunk-Kennung und Löschweg fest. Ein alter Text mit einem guten Ähnlichkeitswert bleibt ein alter Text.
Eigene Prüffolge
1. Client, Version und Speicherart festhalten.
2. Eindeutige IDs und passende Vektordimension prüfen.
3. Einen winzigen Sollfall unabhängig nachrechnen.
4. Query-Felder und Get-Felder getrennt auslesen.
5. Filter und Zugriffsrechte mit Negativfällen prüfen.
6. Aktualisierung, Löschung und Sicherung dokumentieren.Achte auf doppelte IDs: Die Add-Dokumentation beschreibt, dass bereits vorhandene Kennungen beim Hinzufügen ignoriert werden. Ein erneutes add ist deshalb kein verlässliches Update. Ein Dimensionskonflikt führt dagegen zu einem Fehler.
Für eine andere Aufgabenverteilung kannst du FAISS als Bibliothek für Vektorsuche einordnen. Entscheidend ist, welche Daten- und Betriebsaufgaben deine Anwendung zusätzlich übernehmen soll.
Stand: 28. Oktober 2026. Die vier Herstellertexte wurden erneut geprüft. Die Sollrechnung bleibt eine unabhängige Kontrolle; eine tatsächlich ausgeführte Chroma-Suche wird nicht behauptet.
Häufige Fragen
Was ist Chroma DB?
Ein Datenbaustein zum Speichern und Abfragen von Embeddings mit Kennungen und optionalen Dokumenten oder Metadaten. Die fachliche Qualität eines Treffers muss die Anwendung zusätzlich prüfen.
Bleiben meine Daten mit chromadb.Client() erhalten?
Das hier verwendete In-Memory-Beispiel ist flüchtig. Wähle für dauerhafte Daten bewusst eine passende persistente oder serverbasierte Betriebsart.
Was unterscheidet Query von Get?
Query sucht nach ähnlichen Vektoren und gruppiert Treffer je Suchanfrage. Get ruft Records nach IDs oder Filtern ohne Ähnlichkeitsranking ab.
Sind die drei Lernvektoren echte Text-Embeddings?
Nein. Es sind eigene künstliche Koordinaten, deren Abstände sich nachrechnen lassen. Sie zeigen die Mechanik und keine semantische Leistungsfähigkeit.
Wie installiere ich Chroma DB für das Python-Beispiel?
Erstelle im Übungsordner eine virtuelle Python-Umgebung und installiere chromadb mit deren Python. Die Befehle im Installationsabschnitt trennen Windows von macOS und Linux. Starte das Skript anschließend mit genau demselben Python-Pfad.
Brauche ich für das Beispiel einen API-Schlüssel?
Für die gezeigten künstlichen Zahlenvektoren nicht. Die Collection hat keine Embedding-Funktion; die Abfrage übergibt query_embeddings direkt. Andere Embedding-Anbieter oder ein Cloudbetrieb können eigene Zugänge benötigen.
Warum funktioniert query_texts im gezeigten Beispiel nicht?
Die Collection wird mit embedding_function=None erstellt. Deshalb übergibt die Abfrage einen fertigen Vektor mit query_embeddings. Eine Textabfrage benötigt eine passende Embedding-Funktion; auch die Vektordimensionen müssen zur Collection passen.
Quellen & Methode
Vorgehen und Grenzen
Herstellerdokumentation zuletzt am 28. Oktober 2026 geprüft. Die zweidimensionalen Lernvektoren sind eigene künstliche Koordinaten; ihre Abstände wurden unabhängig nachgerechnet. Der Python-Code wurde mit der Dokumentation abgeglichen und auf Syntax geprüft. Die Installationsbefehle und die Datenbanksuche wurden hier nicht ausgeführt; die Sollwerte sind keine gemessene Suchqualität.
Bei Recherche, Texterstellung und Grafiken wird KI eingesetzt. Welche eigenen Versuche vorliegen und was nur als Beispiel dient, beschreibt dieser Beitrag. Unser Redaktionsstandard erklärt die Anforderungen an Belege und Berichtigungen.