Prüfe zuerst die aufbereiteten Wörter und den Datenbestand. BM25 verbindet Termstatistik, Sättigung und Längenausgleich. Für hybride Suche vergleichst du einen zusätzlichen Vektorweg und eine ausdrücklich gewählte Fusion – gleiche Fragen und überprüfte Quellen bleiben die Grundlage.
BM25 sortiert Texte nach Suchbegriffen
BM25 ist ein lexikalisches Rankingverfahren. „Lexikalisch“ heißt hier: Die Übereinstimmung aufbereiteter Begriffe spielt eine zentrale Rolle. Elasticsearch und Lucene benennen BM25 als Standard-Similarity. Die Bezeichnung sagt noch nichts darüber aus, welche Dateien oder Felder deine Anwendung tatsächlich durchsucht.
In einer Dokumenten-KI liegt diese Suche vor dem Antwortmodell. Sie wählt mögliche Textstellen aus. Erst danach kann ein Sprachmodell einen Entwurf mit diesen Stellen erstellen. Ein hoher Rang ist deshalb weder eine vollständige Antwort noch ein Quellenbeweis.
Der Guide Vektorsuche und Embeddings einordnen erklärt den benachbarten Weg mit Zahlenrepräsentationen. Die Verfahren sind unterschiedliche Suchsignale; welches für deine Frage hilft, prüfst du am eigenen Bestand.

Welche Wörter tatsächlich verglichen werden
Verglichen wird der extrahierte und aufbereitete Text: Der Analyzer bestimmt etwa Kleinschreibung, Wortgrenzen, sprachliche Formen und konfigurierte Synonyme. Die sichtbare PDF-Vorschau und der tatsächlich indexierte Inhalt können sich deshalb unterscheiden. Zuerst muss der Text überhaupt verfügbar sein.
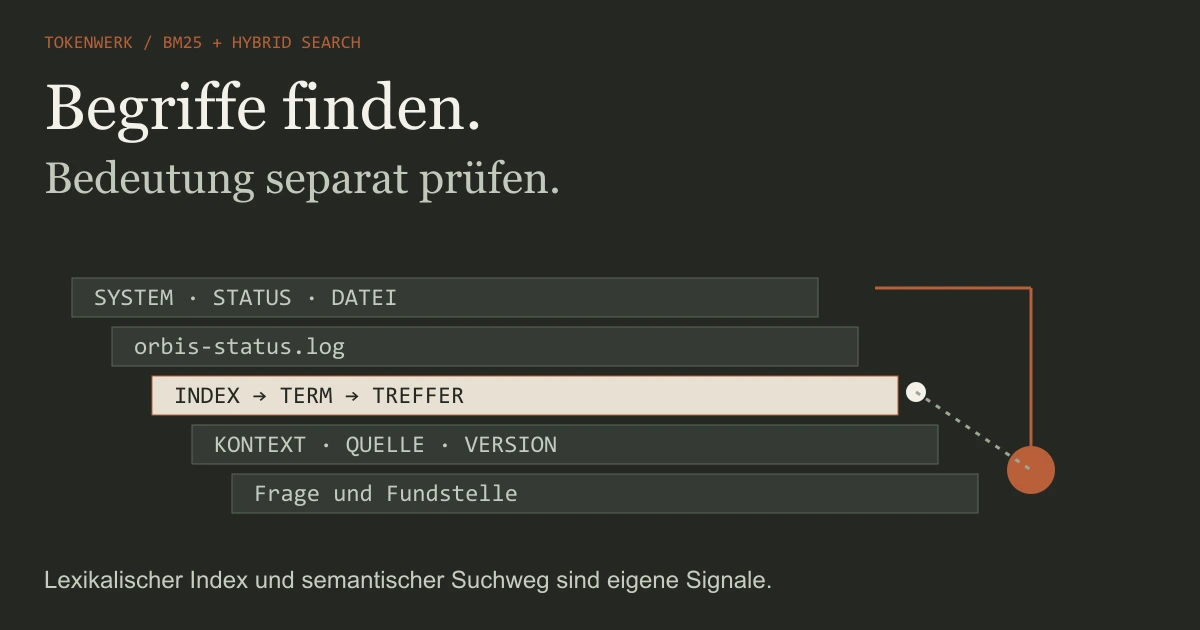
Nutze zwei eigene Fragen zu derselben Testquelle: orbis-status.log und „Wie heißt die Datei mit dem Systemzustand?“. Die erste enthält einen exakten Bezeichner; die zweite eine Umschreibung. Ob beide passende Treffer erhalten, hängt von Aufbereitung, Text und Suchverfahren ab. BM25 scheitert nicht zwingend an jeder Umschreibung, wenn passende Begriffe oder konfigurierte Erweiterungen vorhanden sind.
Prüfe bei einem fehlenden Treffer zuerst: Wurde der Dateiname vollständig extrahiert? Welches Feld wird durchsucht? Wie zerlegt der Analyzer Punkt, Bindestrich und Wortbestandteile? Ein Parameterwechsel kann einen nie indexierten Inhalt nicht wiederherstellen.
Seltenheit, Wiederholung und Textlänge
| Einfluss | Bedeutung |
|---|---|
| Dokumenthäufigkeit eines Terms | Wie viele Dokumente beziehungsweise Felder enthalten diesen Term? Die betrachtete Statistik hängt vom Index ab. |
| Termhäufigkeit im Treffer | Wie oft kommt der Term dort vor? Der Zusatznutzen weiterer Wiederholungen wird nicht unbegrenzt linear gezählt. |
| Länge des betrachteten Textfelds | Der Längenausgleich verhindert, dass bloß mehr Text automatisch denselben Vorteil erhält. |
k1 steuert die Sättigung der Termhäufigkeit; b den Einfluss des Längenausgleichs. Die aktuelle Elastic-Referenz nennt 1,2 und 0,75 als Standardwerte. Das sind dokumentierte Defaults dieses Systems und kein bewiesenes Optimum für jede Sprache, Quelle oder Frage.
In der versionierten Lucene-Referenz 10.2.2 wird die durchschnittliche Feldlänge aus der Gesamtzahl der Terme und der Dokumentzahl des Felds berechnet. Verwende deshalb nicht unbemerkt alle Dateien als Nenner, wenn nur ein bestimmtes Feld Teil der Suche ist.
Eine kleine IDF-Rechnung nachvollziehen
Der IDF-Faktor beschreibt hier die Gewichtung über die Häufigkeit eines Terms im Bestand. Die Lucene-Referenz 10.2.2 definiert ihn mit der folgenden Formel. ln ist der natürliche Logarithmus, N die betrachtete Dokumentzahl und df die Zahl der Dokumente mit dem Term.
Versionierte IDF-Definition und eigene Annahmen
IDF = ln(1 + (N - df + 0,5) / (df + 0,5))
Eigene fiktive Annahme: N = 10
Term A steht in 1 Dokument.
Term B steht in 8 Dokumenten.Unter diesen ausdrücklich gewählten Annahmen ergibt die eigene Rechnung:
| Eigene Annahme | Rechnerischer Faktor |
|---|---|
| N=10, df=1 | 1,992 |
| N=10, df=8 | 0,258 |
Der seltenere Term erhält in dieser Rechnung einen größeren Faktor. Die Werte enthalten noch keine vollständige Dokumentbewertung und sind keine Prozentwerte. Es wurde weder eine Suchmaschine gestartet noch die Qualität eines realen Bestands vermessen. Werte aus verschiedenen Indizes sind nicht ohne gemeinsamen Aufbau direkt vergleichbar.
BM25 mit semantischer Suche kombinieren
Hybrid Search kombiniert mehrere Suchsignale, zum Beispiel BM25 und dichte Vektorsuche. Beide können unterschiedliche Kandidaten oder Reihenfolgen liefern. Die Fusion ist eine zusätzliche Entscheidung – keine automatische Verbesserungsgarantie.
Ein Verfahren wie Reciprocal Rank Fusion führt Rangpositionen zusammen, statt die ungleichartigen Rohscores einfach zu addieren. Der gelesene pgEdge-Beitrag zeigt dafür eine konkrete PostgreSQL-Implementierung. Deren Gewichtungsparameter und Ergebniszahlen gehören zu diesem Aufbau und sind keine allgemeine Empfehlung für jede Anwendung.
Prüfe denselben Bezeichner, dieselbe Umschreibung und eine Frage ohne belegte Antwort auf beiden Wegen. Notiere Treffer und Rang vor der Fusion sowie die endgültige Auswahl danach. Ein Reranker kann eine weitere Stufe sein; auch dann muss die relevante Stelle überhaupt unter den Kandidaten sein.
Du kannst Den Datenweg einer lokalen RAG-Probe nachvollziehen, bevor du eine zweite Suchmethode ergänzt. Das verhindert, dass du eine schlechte Quellenantwort nur mit einer größeren Kandidatenliste verdeckst.
Eine Suche an echten Fragen beurteilen
Lege für jede Testfrage vorher fest, welche Stelle die Antwort tragen sollte. Vergleiche konkrete Treffer, nicht nur die höchste Zahl. Nimm bewusst einen fehlenden Fakt auf. Eine Suche darf Kandidaten liefern, ohne dass diese den gesuchten Inhalt enthalten; das Antwortsystem muss diese Grenze erkennen.
Eigene kurze Abnahme
Frage und erwartete relevante Stelle:
Tatsächlich indexierter Text:
BM25-Treffer und Rang:
Vektortreffer und Rang, falls verwendet:
Gewählte Fusion und Parameter:
Quelle gelesen: trägt sie die Aussage?
Unbekannte oder widersprüchliche Angabe:Das eigene Such-Prüfblatt herunterladen. Es enthält keine fremden Benchmarkwerte und keine gemessene Suchleistung. Mit der Lektion Eine Dokumentensuche mit klaren Prüffragen planen übst du die fachliche Abnahme auch ohne eigene Suchinfrastruktur.
Quellen & Methode
Vorgehen und Grenzen
Originalquellen am 20. Oktober 2026 im dokumentierten Umfang geprüft. Vier ausgewählte vollständige Haupttexte pro Thema symmetrisch verglichen. Beispiele und Grafiken sind eigene Lernhilfen. Rechenwerte und simulierte Clientaufrufe sind von echten Produktläufen getrennt; keine Botnachricht, Datenbankinstallation, Anbieterübertragung oder Modellmessung behauptet. Das Smartphone-Cover ist ein erzeugtes Konzept, kein echtes Produktfoto.
Bei Recherche, Texterstellung und Grafiken wird KI eingesetzt. Welche eigenen Versuche vorliegen und was nur als Beispiel dient, beschreibt dieser Beitrag. Unser Redaktionsstandard erklärt die Anforderungen an Belege und Berichtigungen.