Was zeigen 27 Antworten von GPT, Claude und Gemini?
Die drei getesteten Modellversionen konnten die kurze Zusammenfassung und das fehlende Budget inhaltlich richtig behandeln. Unterschiede zeigten sich beim exakt verlangten Ausgabeformat. Der Versuch umfasst 27 API-Antworten: drei Modelle, drei deutsche Aufgaben und je drei Wiederholungen. Er liefert keine allgemeine Rangliste; DeepSeek wurde nicht getestet.
- Umfang
- 3 Modelle × 3 Aufgaben × 3 Wiederholungen
- Versionen
- GPT-6.1 Sol · Sonnet 5.5 · Gemini 4 Argon
- Zugriffsweg
- DataForSEO · ohne Websuche
- Bewertung
- Sollregeln und KI-gestütztes Lesen
Keine menschliche Blindstudie. Abweichende Einstellungen, kurze künstliche Aufgaben und ein Vermittlungsdienst begrenzen den Vergleich.
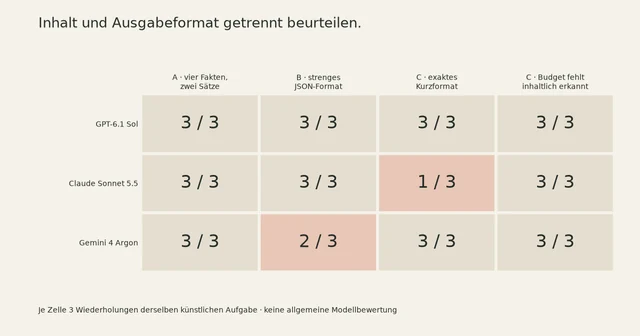
Die kurze Zusammenfassung erhielt bei allen drei Modellen die vorgegebenen Fakten. Unterschiede zeigten sich bei der maschinell geforderten Ausgabe: Ein Markdown-Codeblock kann einen JSON-Parser stoppen, eine zutreffende Zusatzbegründung das verlangte Kurzformat verfehlen. Das ist etwas anderes als eine erfundene Tatsache.
| Version | A · vier Fakten, zwei Sätze | B · strenges JSON | C · exaktes Kurzformat | C · fehlendes Budget erkannt |
|---|---|---|---|---|
| GPT-6.1 Sol | 3 / 3 | 3 / 3 | 3 / 3 | 3 / 3 |
| Claude Sonnet 5.5 | 3 / 3 | 3 / 3 | 1 / 3 | 3 / 3 |
| Gemini 4 Argon | 3 / 3 | 2 / 3 | 3 / 3 | 3 / 3 |
| DeepSeek | Nicht getestet | Nicht getestet | Nicht getestet | Nicht getestet |
Die Zahlen sind keine allgemeine Trefferquote. A und die inhaltliche Budgetprüfung beruhen auf KI-gestütztem redaktionellem Lesen jeder Antwort. Die ursprüngliche JSON- und Kurzformatregel wurde separat auf den unveränderten Text angewendet. Es gab weder eine menschliche Blindstudie noch eine zusammenfassende Siegerpunktzahl.
Vom LLM-Vergleich zum eigenen Praxistest.
Der allgemeine LLM-Vergleich beschreibt dokumentierte Eigenschaften. Dieser Praxistest ergänzt ihn um 27 tatsächlich beobachtete Antworten in drei begrenzten Aufgaben. Er zeigt besonders, warum fachliche Richtigkeit und ein verbindliches Ausgabeformat getrennt geprüft werden müssen.
Die Anbieterreihenfolge und Sollregeln standen vor dem ersten Aufruf fest. Die Auswertung erfolgte KI-gestützt und ohne unabhängiges menschliches Panel. DeepSeek blieb mangels bestätigten Zugangs ungetestet.
Drei bestätigte Zugänge. Der vierte bleibt offen.
- Zugriffsweg
- DataForSEO · LLM Responses Live API
- Umfang
- 3 Modelle × 3 Aufgaben × 3 Wiederholungen
- Ausgabe / Tools
- Maximal 1.024 Tokens · keine Websuche
- Abgerechnete Kosten
- 0,038478 US-Dollar
Die angefragten und zurückgegebenen IDs waren gpt-6.1-sol, claude-sonnet-5-5 und gemini-4-argon. Grundlage sind die Modelllisten und Antworten des Vermittlungsdienstes; ein unabhängiger Gewichtesnapshot oder Digest ist für diese gehosteten Aufrufe nicht verfügbar.
Für DeepSeek wurde kein Test ausgeführt. Ein passender Zugang war nicht bestätigt, und der genutzte Endpunkt bot DeepSeek nicht an. Aus dem ursprünglichen Vier-Anbieter-Plan wurde deshalb ein belegter Drei-Anbieter-Versuch. „Nicht getestet“ bedeutet keine schlechte Leistung.
Die Anbieterreihenfolge rotierte zwischen Aufgaben und Wiederholungen. Claude und Gemini erhielten Temperatur 0,2 und use_reasoning=false. Beim ausgewählten GPT-Modell unterstützt dieser Endpunkt keine Temperaturvorgabe; dort galt der Dienststandard. Die Antworten meldeten insgesamt zehn Reasoning-Tokens bei GPT, null bei Claude und Gemini. Ein fester Seed stand nicht zur Verfügung. Diese Unterschiede verhindern einen vollständig gleich eingestellten Modellvergleich.
Die Dokumentation des Zugriffswegs und die Preisübersicht erklären das Verfahren. Abgerechnet wurden 0,038478 US-Dollar einschließlich 27 Live-Grundgebühren von jeweils 0,0006 US-Dollar und der jeweiligen Modellnutzung. Das ist kein aktueller Preisvergleich direkter Anbieter-APIs.
Vor dem Versuch solltest du aktuelle Modellversionen nachschlagen und die konkrete Anbieter-ID in dein Protokoll übernehmen.
Um deinen kleinen Versuch von veröffentlichten Rankings zu unterscheiden, kannst du Benchmark-Bedingungen einordnen.
Wenn du den Ablauf praktisch durchgehen möchtest, kannst du einen Modellvergleich Schritt für Schritt aufbauen.
Drei Aufgaben. Zwei unterschiedliche Formatgrenzen.
- A · Zusammenfassen. Ein kurzer fiktiver Projektstand nennt einen internen Test am Mittwoch, 4. November, bereitliegende Dateien, eine offene Fortsetzungsentscheidung und den Verzicht auf externe Kundendaten. Gefordert sind zwei deutsche Sätze ohne zusätzliche Entscheidung. Alle neun gelesenen Antworten erhielten diese vier Angaben.
- B · JSON extrahieren. A-7 enthält 999 Cent, A-8 1.998 Cent und A-9 keinen bekannten Betrag. Erwartet sind genau drei Schlüssel, die Summe 2.997, alle drei IDs und A-9 als offene ID. Acht Antworten bestanden den unveränderten strengen Abgleich.
- C · Nichtwissen ausdrücken. Das Material nennt kein Budget. Alle neun Antworten erkannten das. Die eingefrorene Kurzformatprüfung akzeptiert nur „nicht angegeben“, unabhängig von Großschreibung und einem abschließenden Punkt. Sieben Antworten erfüllten auch dieses enge Format.
Die B-Anweisung war vor der ersten Anbieteranfrage präzisiert worden: ids muss ausdrücklich alle IDs enthalten. Anlass war der separate lokale Qwen-Versuch. Die Version 2 und die historische Originalfassung bleiben beide verfügbar. Das ist kein unabhängiger Test auf neuen, unbekannten Aufgaben.
Gemini, Aufgabe B, Wiederholung 3
```json
{
  "bekannte_summe_cent": 2997,
  "ids": [
    "A-7",
    "A-8",
    "A-9"
  ],
  "offene_ids": [
    "A-9"
  ]
}
```
Summe und Listen sind richtig. Die zusätzlichen Markdown-Zäune machen die gesamte Nachricht jedoch zu keinem direkt einlesbaren JSON-Dokument. Für den ursprünglichen Score wurden sie nicht entfernt. Erst eine getrennte Diagnose bestätigt, dass die Werte innerhalb des Blocks stimmen. Es wurde kein API-Schema-Modus angefordert, sondern JSON per Prompt verlangt. Wie sich nachgelagerte Regeln unterscheiden, zeigt die separate JSON-Prüfung mit zwei Prüfregeln an künstlichen Dateien.
Claude, Aufgabe C, Wiederholung 1
Nicht angegeben. Das Material nennt kein Budget; es besagt lediglich, dass im Versuch Nordlicht drei Aufgaben bearbeitet werden und eine Entscheidung über die Fortsetzung noch aussteht.Auch diese Antwort ist inhaltlich zutreffend: Es wurde kein Budget erfunden. Sie verfehlt die vorab festgelegte reine Kurzantwort durch ihre zusätzliche Erklärung. Die natürlichsprachige Anweisung ist weniger formal als ein erzwungenes Ausgabeschema; daraus leiten wir kein allgemeines Zuverlässigkeitsurteil ab.
Was die Antworten gekostet haben und wie lange wir warteten.
| Version | Median | Kleinster / größter Wert | Abgerechnete Summe |
|---|---|---|---|
| GPT-6.1 Sol | 2,343 s | 1,609 / 3,155 s | 0,010320 USD |
| Claude Sonnet 5.5 | 1,721 s | 1,112 / 2,495 s | 0,016060 USD |
| Gemini 4 Argon | 3,509 s | 1,930 / 21,308 s | 0,012098 USD |
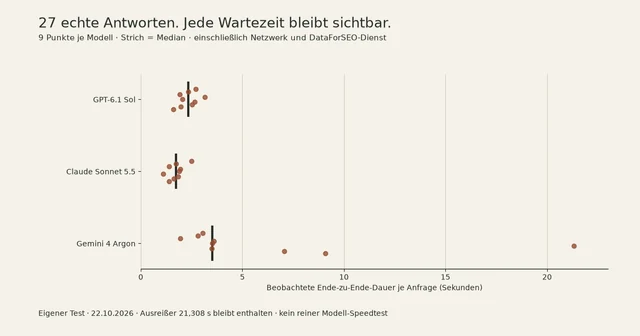
Ein Gemini-Aufruf dauerte 21,308 Sekunden. Er bleibt sichtbar und wurde weder wiederholt noch ersetzt. Gemessen wurde die Zeit vom Absenden bis zum vollständigen Empfang einschließlich Netzwerk und Vermittlungsdienst. Daraus lassen sich keine reinen Tokens-pro-Sekunde-Werte oder dauerhaften Geschwindigkeitsränge ableiten. Cacheverhalten und interne Dienstlast waren nicht kontrollierbar.
Was wir für eine Anwendung daraus lernen.
Wir würden eine Antwort erst fachlich und anschließend am vereinbarten Datenvertrag prüfen: Sind die benötigten Angaben enthalten? Ist das behauptete Wissen im Material belegt? Kann der nächste Verarbeitungsschritt das Format tatsächlich lesen? Ein lesbarer Zusatzsatz hilft Menschen, kann aber eine exakt erwartete Maschinenantwort verändern.
Der Versuch zeigt konkrete Beobachtungen dreier Versionen in drei kurzen künstlichen Aufgaben. Drei Wiederholungen derselben Aufgabe sind keine drei unabhängigen Tests der gesamten Modellqualität. Deutschkompetenz, Langkontext, Bilder, Toolnutzung, Sicherheit und produktive Fachprozesse wurden nicht umfassend untersucht. Es gab kein unabhängiges menschliches Bewertungspanel; Modellnamen waren bei der redaktionellen Prüfung sichtbar.
Für einen eigenen Test die vollständigen Prompts und Sollwerte vorab sichern, dieselben Werkzeuge und Einstellungen soweit möglich festlegen und jede Antwort samt Kosten protokollieren. Zusätzliche Versuche und geänderte Regeln getrennt kennzeichnen. Unsere Rohdaten enthalten die unveränderten finalen Antworttexte; Transporthüllen und etwaige Reasoning-Zusammenfassungen sind im öffentlichen Download weggelassen. Die Heroillustration ist symbolisch, kein Screenshot einer Modellantwort.
Redaktionell überarbeitet am . Der Versuch stammt unverändert vom 22. Oktober 2026.
Quellen und Teststand.
Technische Dokumentation abgerufen am 22.10.2026. Die Einzelresultate stammen aus dem verlinkten lokalen Testprotokoll. Inhalte und Grafiken wurden mit KI-Unterstützung ausgearbeitet; Messungen und Pläne sind getrennt gekennzeichnet.