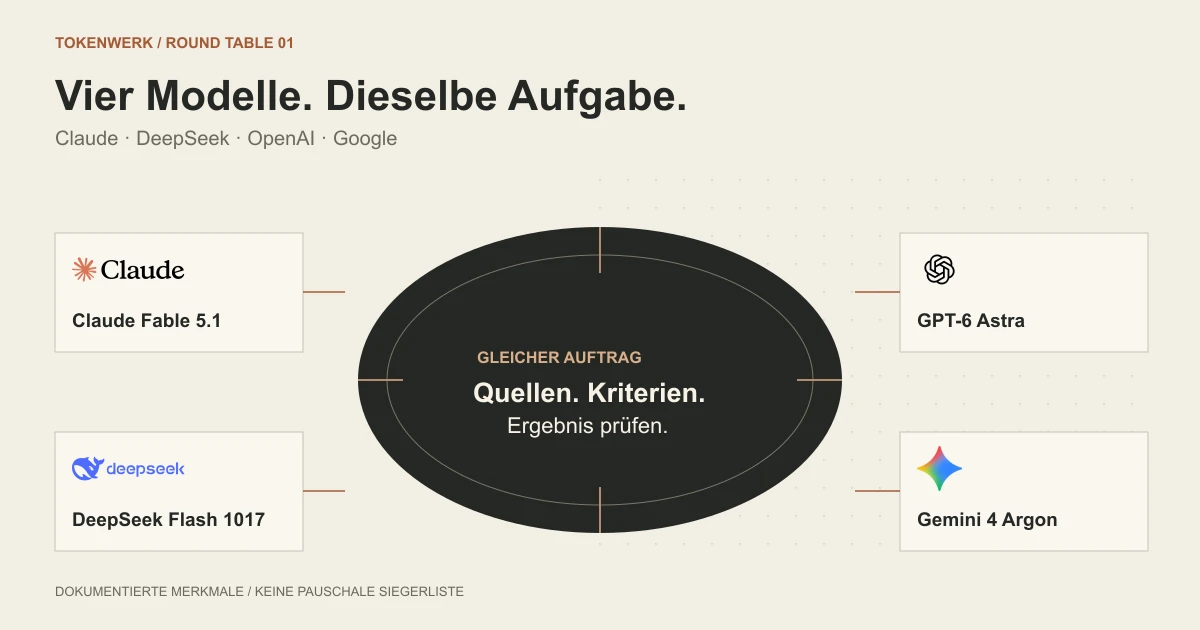
DeepSeek Flash 1017 ist in dieser Auswahl bei den dokumentierten Tokenpreisen am günstigsten. Gemini 4 Argon nimmt die breiteste Auswahl an Medien an. Fable 5.1 und Astra sind Kandidaten für besonders anspruchsvolle Arbeit. Welche Antwort deine Aufgabe am besten löst, muss ein gemeinsamer Test zeigen.
Vier Anbieter, vier konkrete Modellversionen
Verglichen werden die API-Modelle Claude Fable 5.1, DeepSeek V4.1 Flash 1017, GPT-6 Astra und Gemini 4 Argon. Ein Anbietername ist noch keine Modellversion. ChatGPT ist ein Produkt von OpenAI; GPT-6 Astra ist ein konkretes Modell. Auch Claude und Gemini können je nach Oberfläche, Tarif und Modus unterschiedliche Modelle einsetzen. Dieser Roundtable vergleicht die dokumentierten API-Modelle, damit die Angaben überprüfbar bleiben.
Fable 5.1, Astra und Argon werden von ihren Anbietern als Spitzenmodelle eingeordnet. Bei DeepSeek wählen wir bewusst das neue, multimodale Flash-1017-Update. Das ist keine Behauptung, dass Flash auf jeder Aufgabe das stärkste DeepSeek-Modell sei: Die offizielle Preisseite führt daneben weiterhin V4-Pro-0813 als eigene Version. Ein teurerer Pro-Name beweist ebenso wenig einen Qualitätsvorsprung.
Die weiteren Modellvergleiche vertiefen einzelne Paare. Hier geht es zuerst um die gemeinsame Auswahlfrage: Welche Eigenschaften brauchst du wirklich?
Das Datenblatt: Eingaben, Kontext und Ausgabe
| Merkmal | Claude Fable 5.1 | DeepSeek Flash 1017 | GPT-6 Astra | Gemini 4 Argon |
|---|---|---|---|---|
| API-ID | claude-fable-5-1 | deepseek-flash | gpt-6-astra | gemini-4-argon |
| Eingaben | Text, Bilder | Text, Bilder | Text, Bilder | Text, Bilder, Audio, Video, PDF |
| Ausgabe des Modells | Text | Text | Text | Text |
| Kontext laut Anbieter | 1 Mio. Tokens | 1 Mio. Tokens | 1.050.000 Tokens | 1.048.576 Tokens, gemeinsam für Eingabe, Denken und Ausgabe |
| Maximale Ausgabe | 128.000 Tokens | 384.000 Tokens | 128.000 Tokens | 65.536 synchron; längere Ausgaben per Long Decode im gemeinsamen Fenster |
| Modellgewichte | Nicht veröffentlicht | Veröffentlicht, MIT-Lizenz | Nicht veröffentlicht | Nicht veröffentlicht |
Kontext bezeichnet den Arbeitsbereich in Tokens, also den Texteinheiten des Modells. Ein großes Fenster belegt keine zuverlässige Verarbeitung jeder enthaltenen Stelle. Prüfe deshalb auch, ob Antworten die richtige Passage verwenden.
Bei Argon teilen sich Eingabe, Denkprozess und Antwort das Fenster. Eine lange Datei lässt entsprechend weniger Platz für die Ausgabe. Bei allen vier Modellen sind Bildverständnis und Bilderzeugung verschiedene Aufgaben: Die hier verglichenen Modelle geben Text aus. Zusätzliche Werkzeuge können andere Ausgaben ermöglichen.
Die vier Modelle am Tisch: Vorteile und Grenzen
01 / Anthropic
Claude Fable 5.1
Anthropic positioniert Fable für schwierige Denkaufgaben und lange Agentenabläufe. Das Modell ist allgemein zugänglich; Mythos 5.1 hat laut Anbieter dieselben Fähigkeiten, bleibt aber verifizierten Organisationen vorbehalten.
- Vorteil
- Adaptive Denktiefe und ein großes Kontextfenster für mehrstufige Arbeit. Der Zugang ist auf mehreren Cloudplattformen dokumentiert.
- Grenze
- Hoher Standardpreis; Thinking bleibt aktiv. Anthropic empfiehlt für die meisten Aufgaben zunächst das günstigere Opus 5.5. Fable ist deshalb ein Kandidat für schwierige Fälle, kein sinnvoller Standard für jeden kurzen Text.
Beleg: Anthropics Modellunterlagen.
02 / DeepSeek
V4.1 Flash 1017
Das Update vom 17. Oktober ist über Web, App und API verfügbar. Die API-ID deepseek-flash verweist laut aktueller Preisseite auf diese Version. Bilder werden als Eingabe unterstützt.
- Vorteil
- Niedrige dokumentierte Tokenpreise und veröffentlichte Gewichte mit MIT-Lizenz. Dadurch kommen neben der Anbieter-API auch andere Betriebswege infrage.
- Grenze
- Selbstbetrieb braucht eine passende Infrastruktur; offene Gewichte machen daraus kein gewöhnliches Laptop-Setup. Der Preis richtet sich unter anderem nach Cache und UTC-Zeitfenster. DeepSeeks eigene Leistungstabellen sind Herstellerangaben.
Belege: API-Zuordnung und Preise, offizielle Gewichte.
03 / OpenAI
GPT-6 Astra
OpenAI führt Astra als sein leistungsfähigstes Modell für besonders anspruchsvolle Arbeit. Dokumentiert sind unter anderem Coding, Recherche und die Nutzung von Werkzeugen über die Responses API.
- Vorteil
- Ein dokumentiertes Werkzeugangebot mit Websuche, Dateisuche, Codeausführung und Computersteuerung. Die Denkintensität lässt sich einstellen.
- Grenze
- Hoher Standardpreis und zusätzliche Werkzeuggebühren. Über 272.000 Eingabetokens steigt der Preis für die gesamte Anfrage. Astra selbst gibt Text aus; ein angebundenes Bildwerkzeug ist ein eigener Baustein.
Beleg: OpenAIs Astra-Datenblatt.
04 / Google
Gemini 4 Argon
Googles aktuelles Spitzenmodell ist in der Gemini API und in AI Studio verfügbar. Es nimmt unterschiedliche Medien an und kann lange Ausgaben über eine Hintergrundausführung fortsetzen.
- Vorteil
- Text, Bilder, Audio, Video und PDF als dokumentierte Eingaben. Für gemischtes Material ist Argon damit ein naheliegender Kandidat.
- Grenze
- Eingabe, Denken und Ausgabe teilen sich ein Fenster. Eine Million Tokens sind kein zusätzliches Ausgabebudget. Explizites Caching wird nicht unterstützt; der Einführungspreis endet am 30. November 2026.
Belege: Modellkarte und Argon-Dokumentation.
Was dieselbe Token-Menge kostet
Für eine nachvollziehbare Rechnung setzen wir 100.000 Eingabetokens und 10.000 abgerechnete Ausgabetokens fest. Kein Cache-Treffer, keine Werkzeuge, kein Batch-Rabatt. Das ist eine Rechengröße, keine Messung einer gelösten Aufgabe.
| Modell | Eingabe | Ausgabe | 100.000 rein + 10.000 raus |
|---|---|---|---|
| Claude Fable 5.1 | 10,00 $ | 50,00 $ | 1,500 $ |
| DeepSeek Flash 1017 · Peak | 0,30 $ | 1,20 $ | 0,042 $ |
| GPT-6 Astra · bis 272K Eingabe | 10,00 $ | 50,00 $ | 1,500 $ |
| Gemini 4 Argon · Einführung | 2,00 $ | 10,00 $ | 0,300 $ |

Rechenweg: 0,1 × Eingabepreis + 0,01 × Ausgabepreis. Bei DeepSeek ergibt das 0,1 × 0,30 + 0,01 × 1,20 = 0,042 US-Dollar. Zu Off-Peak-Zeiten halbiert sich dieser Beispielbetrag auf 0,021 Dollar. Googles angekündigte Preise ab 1. Dezember 2026 ergeben im gleichen Beispiel 0,600 Dollar.
Bei Astra gelten oberhalb von 272.000 Eingabetokens für die gesamte Anfrage doppelte Eingabe-/Cachepreise und der 1,5-fache Ausgabepreis. Diese Grenze wird im Beispiel nicht erreicht. Die Beträge sind USD-Listenwerte; Steuern, Umrechnung und andere Gebühren sind nicht eingerechnet. Denk-Tokens können die abgerechnete Ausgabe erhöhen. Vergleiche im eigenen Betrieb auch Wiederholungen und Nacharbeit.
Welche Auswahl zu deiner Aufgabe passt
Die folgende Vorauswahl ist eine redaktionelle Ableitung aus den dokumentierten Merkmalen. Sie ist keine gemessene Qualitätsrangfolge. Beginne mit der billigsten Option, die deine fachlichen Prüfkriterien erfüllt, und erhöhe den Aufwand dort, wo Ergebnisse tatsächlich scheitern. Mit der Entscheidungsvorlage für KI-Tools kannst du die gewählte Modellversion anschließend im konkreten Produkt und Arbeitsweg prüfen.
| Deine Aufgabe | Erster Kandidat | Was du prüfen solltest |
|---|---|---|
| Viele gleichartige Entwürfe mit knappem API-Budget | DeepSeek Flash 1017 | Faktenfehler, Nacharbeit und tatsächliche Gesamtkosten |
| Audio, Video und Text gemeinsam auswerten | Gemini 4 Argon | Unterstützte Medien im konkreten Zugang; Belege und Zeitstellen |
| Schwieriger mehrstufiger Dokument- oder Codeauftrag | Claude Fable 5.1 oder GPT-6 Astra | Identische Aufgabe mit begrenzten Werkzeugrechten; Vergleich mit einer günstigeren Alternative |
| Modellgewichte selbst kontrollieren | DeepSeek Flash 1017 | Lizenz, Hardware, Runtime und Betriebskosten vor dem Download |
Bei gemischten Eingaben und engem Budget lohnt die Vertiefung zu DeepSeek Flash 1017 und Gemini 4 Argon. Für sensible Daten musst du außerdem den konkreten Vertrag, die Verarbeitung und die eingeräumten Rechte des gewählten Zugangs prüfen. Aus einem Logo oder einer Modelllizenz lässt sich keine Freigabe für Kundendaten ableiten.

Vier Modelle fair prüfen: eine Aufgabe zum Kopieren
Du brauchst zunächst eine kleine Aufgabe mit einer bekannten Lösung. Gleiche Quelle, gleicher Auftrag, keine Websuche: So kannst du erkennen, ob ein Modell einen korrigierten Termin berücksichtigt, richtig rechnet und eine Wissenslücke offenlässt.
Dein identischer Prüfauftrag · fiktive Daten
AUFGABE: Prüfe die folgenden fiktiven Projektnotizen.
Verwende ausschließlich diese Quelle. Erfinde keine fehlenden Angaben.

QUELLE:
[A] Notiz vom 12.10.2026: Workshop am 04.11.2026 um 10 Uhr,
    Raum Nord, 12 Plätze, 40 Euro je Person.
[B] Korrektur vom 15.10.2026: Neuer Termin 06.11.2026 um 14 Uhr.
    Raum und Teilnehmerpreis bleiben unverändert.
[C] Notiz vom 16.10.2026: Zwei Plätze werden für das Team reserviert.

ANTWORTE in einer Tabelle mit Aussage, Ergebnis und Beleg [A/B/C]:
1. Welcher Termin gilt zuletzt?
2. Wie viele Plätze bleiben für externe Teilnehmer?
3. Wie hoch ist der Umsatz bei vollständigem Verkauf dieser Plätze?
4. Ist die Buchungsfrist bekannt?

Vorgaben: Rechenweg zeigen, fehlende Angaben als unbekannt markieren.
Keine Websuche, keine Werkzeuge, höchstens 180 Wörter.Die Sollantwort kannst du selbst nachrechnen
- Termin: 6. November 2026, 14 Uhr. Beleg: Korrektur [B].
- Externe Plätze: 12 − 2 = 10. Belege: [A] und [C].
- Umsatz im Beispiel: 10 × 40 Euro = 400 Euro. Belege: [A] und [C]. Gemeint ist der Verkauf der externen Plätze.
- Buchungsfrist: unbekannt. Keine der drei Notizen nennt sie.
Speichere Modell-ID, Datum, Denkmodus, Ausgabelimit und Originalantwort. Notiere die Dauer bis zur vollständigen Antwort und die vom Anbieter ausgewiesenen Tokens. Gleich benannte Denkstufen sind zwischen Anbietern kein identisches Rechenbudget.
| Modell + Version | Fakten / Belege | Format / Unbekannt | Zeit / Kosten / Nacharbeit |
|---|---|---|---|
| Claude Fable 5.1 | Noch nicht geprüft | Noch nicht geprüft | Noch nicht gemessen |
| DeepSeek Flash 1017 | Noch nicht geprüft | Noch nicht geprüft | Noch nicht gemessen |
| GPT-6 Astra | Noch nicht geprüft | Noch nicht geprüft | Noch nicht gemessen |
| Gemini 4 Argon | Noch nicht geprüft | Noch nicht geprüft | Noch nicht gemessen |
Eine richtige Antwort auf diese Mini-Aufgabe reicht für eine Produktentscheidung nicht aus. Ergänze mehrere typische Fälle, gezielte Lücken und widersprüchliche Angaben. Prüfe Fakten und Belege getrennt vom Schreibstil. Eine flüssige Formulierung darf einen falschen Termin nicht ausgleichen.
Unser Fazit: nach Ergebnis entscheiden
Der größte Abstand in dieser Auswahl liegt zunächst bei den dokumentierten Tokenpreisen und den unterstützten Eingaben. Ob sich das teurere Modell lohnt, entscheidet dein überprüftes Arbeitsergebnis: weniger Fehler, geringere Nacharbeit oder eine Aufgabe, die der günstigere Kandidat nicht zuverlässig löst.
Wähle zwei passende Kandidaten, teste mit demselben Material und halte die Grenzen fest. Der Lernpfad zum Beurteilen von KI-Modellen führt dich durch Aufgabe, Testbedingungen und Auswertung.
Quellen & Methode
Vorgehen und Grenzen
Stand 20. Oktober 2026. Herstellerunterlagen und offizielle Modell-Repositories ausgewertet; vier Vergleichs-Vollquellen dienten ausschließlich der Recherche von Nutzerfragen und Inhaltslücken. Mit KI-Unterstützung eigenständig ausgearbeitet. Der Roundtable ist ein redaktionelles Format, kein Gespräch mit den Anbietern. Es wurden keine Modellaufrufe oder Leistungstests ausgeführt. Grafiken, fiktive Aufgabe und Kostenrechnung sind eigene Darstellungen. Keine pauschale Qualitätsrangliste; API-Daten gelten nicht automatisch für Chat-Abos.
Bei Recherche, Texterstellung und Grafiken wird KI eingesetzt. Welche eigenen Versuche vorliegen und was nur als Beispiel dient, beschreibt dieser Beitrag. Unser Redaktionsstandard erklärt die Anforderungen an Belege und Berichtigungen.