Was zeigte Qwen3.5 4B im lokalen Ollama-Test?
Qwen3.5 4B lief am 22. Oktober 2026 lokal auf unserem Laptop. Getestet wurden eine Zusammenfassung, eine JSON-Extraktion und eine Frage ohne belegbare Antwort: ein Erstaufruf, neun Folgeaufrufe und drei getrennte JSON-Nachtests. Die Beobachtungen gelten für diese künstlichen Aufgaben und dieses Setup, nicht allgemein für lokale KI.
- Umfang
- 10 ursprüngliche Anfragen + 3 Nachtests
- Modell
- qwen3.5:4b · Q4_K_M
- Bedingungen
- Ein Laptop · fester Seed · kurze Aufgaben
- Bewertung
- Feste Sollwerte und KI-gestütztes Lesen
Der Nachtest präzisiert den Prompt. Er ersetzt keine ursprüngliche Antwort und ist kein unabhängiger Test mit neuem Material.
Die Zusammenfassungen erhielten in allen drei Warmläufen die vier vorgegebenen Angaben. Auf die unbeantwortbare Budgetfrage kam jeweils „nicht angegeben“. Beim JSON waren Summe und Liste der offenen IDs korrekt; die allgemeine ID-Liste enthielt jedoch nur A-7 und A-8. Unser eingefrorener Sollwert verlangte zusätzlich A-9.
| Aufgabe | Beobachtung | Soll erfüllt | Median Ende-zu-Ende |
|---|---|---|---|
| A · Zusammenfassen | Vier Angaben erhalten; zwei Sätze | 3 von 3 | 1,071 s |
| B · JSON extrahieren | Gültiges JSON; A-9 fehlt in ids | 0 von 3 | 0,920 s |
| C · Fehlende Budgetangabe | „nicht angegeben“ | 3 von 3 | 0,238 s |
Das sind Beobachtungen dieser drei Aufgaben, keine Genauigkeitsquote für das Modell. Gleicher Seed, serielle Aufrufe und Cache-Nutzung machen die Wiederholungen nicht zu unabhängigen Stichproben.
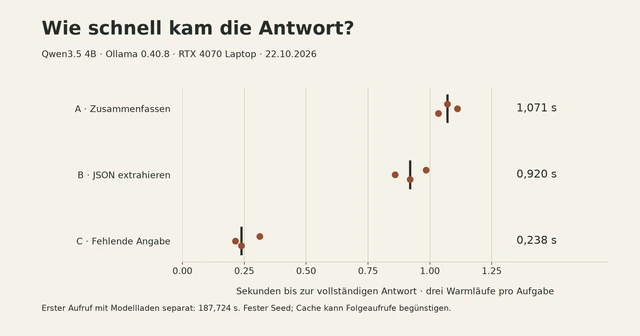
Erstaufruf: 187,724 Sekunden. Die API meldete davon rund 106,731 Sekunden Laden, 74,649 Sekunden Eingabeverarbeitung und 6,316 Sekunden Ausgabeerzeugung. Der Aufruf lief während der n8n-Paketinstallation auf demselben Rechner. Das ist ein protokollierter Erstlauf unter dieser Last, kein sauber isolierter Startvergleich.
Ollama-Erfahrungen nachvollziehbar festhalten.
Das gemessene Beispiel zeigt, weshalb „läuft gut“ als Urteil zu kurz greift. Antwortzeit, fachlicher Sollabgleich und eine klare Aufgabenbeschreibung beantworten unterschiedliche Fragen. Bei einer schnellen JSON-Antwort fehlte eine ID gegenüber dem festgelegten Soll; der getrennte Nachtest präzisierte das Feld.
Die eigene Auswertung nennt auch ihre Schwächen: drei künstliche Aufgaben, fester Seed, mögliche Cache-Effekte und ein Erstaufruf bei paralleler Installation. Die vollständigen Rohantworten und jedes Messergebnis stehen im Download.
Das tatsächlich benutzte Setup.
- Laufzeit / Modell
- Ollama 0.40.8 · qwen3.5:4b · Q4_K_M
- Rechner
- Intel i9-13900H · 63,73 GiB RAM · Windows 11
- Grafik
- RTX 4070 Laptop GPU · 8.188 MiB · Treiber 596.21
- Aktiver Kontext
- 4.096 Tokens · maximal 512 Ausgabetokens
Die portable Laufzeit band an 127.0.0.1:11435. OLLAMA_NO_CLOUD=1 war gesetzt. Temperatur 0,2, Seed 42, think: false, stream: false und zehn Minuten Haltezeit blieben gleich. Jede Anfrage begann ohne vorherigen Chatverlauf. Der Modell-Digest steht vollständig in versuch.json.
Nach den Anfragen meldete /api/ps 3.140.495.604 Bytes zugeordneten GPU-Speicher, ungefähr 2,93 GiB. Das ist die API-Angabe zur Modellbelegung, keine gemessene Verbrauchsspitze des gesamten Rechners. Strombedarf, Temperatur und Nutzung mit langen Dokumenten wurden nicht untersucht.
Wenn dir die Laufzeit noch neu ist, beginne mit den Grundlagen von Ollama.
Für eine Container-Variante kannst du Ollama in Docker einrichten; protokolliere diesen Unterschied zum nativen Betrieb.
Bevor du lange Texte testest, lies, wie du das Kontextfenster gezielt einstellen und überprüfen kannst.
Die Rohantwort erklärt den Nachtest.
Eine der ursprünglichen JSON-Antworten lautete exakt:
{
  "bekannte_summe_cent": 2997,
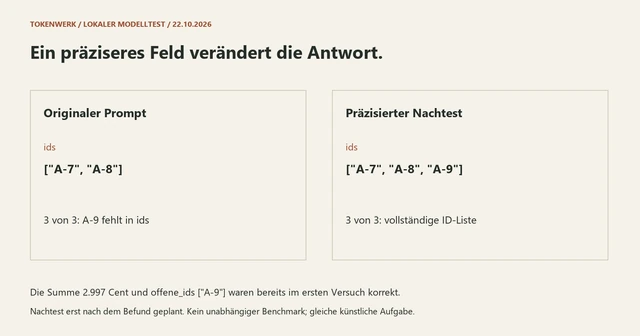
  "ids": ["A-7", "A-8"],
  "offene_ids": ["A-9"]
}
Die Rechnung stimmt: 999 plus 1.998 ergibt 2.997 Cent. Der strenge Sollabgleich scheitert an ids. Allerdings sagt der ursprüngliche Prompt nicht ausdrücklich, dass diese Liste auch Datensätze ohne Betrag enthalten soll. Die Beobachtung ist daher zunächst eine Abweichung vom festgelegten Datenvertrag bei unklarer Felddefinition.
Erst nach diesem Befund wurde ein getrennter Nachtest eingefroren. Zusätzlich zum unveränderten ursprünglichen Prompt stand dort:
In ids stehen ALLE IDs des Materials, auch wenn ihr Betrag unbekannt ist. offene_ids enthält zusätzlich die IDs mit unbekanntem Betrag.Alle drei Zusatzantworten enthielten danach ids: ["A-7", "A-8", "A-9"], die korrekte Summe und offene_ids: ["A-9"]. Die drei ursprünglichen Abweichungen bleiben im Protokoll. Der Nachtest zeigt eine Verbesserung in derselben Aufgabe; er ist keine unabhängige Bestätigung auf neuen Daten.
Für den eigenen Versuch: zuerst Modell und Digest abgleichen, dieselben Anfragen ohne Chatverlauf senden, vollständige Antwortzeiten erfassen und jede Rohantwort sichern. Der Download enthält die exakten Einstellungen und den Originaltext. Ein anderer Rechner muss weder identische Zeiten noch identische Texte liefern. Für eine andere Aufgabe kannst du konkrete Modellversionen mit Quellen vergleichen, bevor du einen neuen Versuchsstand festlegst.
Was wir daraus mitnehmen – und was offen bleibt.
Für diese kurze Zusammenfassung und das ausdrückliche Nichtwissen funktionierte die gewählte Version in den beobachteten Läufen. Bei strukturierten Daten war eine eindeutige Felddefinition entscheidend. Deshalb würden wir in einer Anwendung sowohl Struktur als auch fachliche Vollständigkeit prüfen, bevor Daten weiterverarbeitet werden.
Die Bewertung der Zusammenfassungen war KI-gestütztes redaktionelles Lesen, kein unabhängiges menschliches Panel. Für JSON und die Budgetfrage kamen feste Sollregeln hinzu. Es gab weder eine repräsentative Aufgabenauswahl noch Bild-, Tool-, Sicherheits- oder Langkontexttests. Die Folgezeiten sind durch unterschiedliche Antwortlängen, festen Seed und mögliche Cache-Wiederverwendung geprägt.
Die Inferenzanfragen gingen an die lokale API. Der Modelldownload benötigte vorher das Internet; ein vollständiger Netzwerkaudit fand nicht statt. Aus diesem Versuch folgt keine Datenschutz-, Sicherheits- oder Hardwareempfehlung für andere Aufgaben. Die Heroillustration ist symbolisch und kein Foto des benutzten Laptops.
Redaktionell überarbeitet am . Der Versuch stammt unverändert vom 22. Oktober 2026.
Quellen und Teststand.
Technische Dokumentation abgerufen am 22.10.2026. Die Einzelresultate stammen aus dem verlinkten lokalen Testprotokoll. Inhalte und Grafiken wurden mit KI-Unterstützung ausgearbeitet; Messungen und Pläne sind getrennt gekennzeichnet.