Training verändert das Modell anhand von Daten. Inferenz verwendet ein trainiertes Modell für eine konkrete Eingabe. Eine einzelne Antwort ist deshalb nicht automatisch ein neuer Trainingsschritt. Laufzeit, Speicher und Kosten hängen vom tatsächlichen Betrieb ab.
Was bedeutet Inferenz bei KI?
Inferenz ist die Verarbeitung einer neuen Eingabe durch ein trainiertes Modell. Zum Beispiel gibst du den Auftrag: „Kürze diese Notiz auf zwei Sätze.“ Die Anwendung bereitet die Anfrage vor, das Modell verarbeitet sie und liefert eine Ausgabe zurück. Der Begriff beschreibt den Rechenschritt, nicht die Qualität des Ergebnisses.
Eine richtige Antwort muss weiterhin geprüft werden. Ein Modell kann beim Inferenzieren auch eine falsche Behauptung oder eine unpassende Zusammenfassung erzeugen. Dass es dafür Rechenzeit gebraucht hat, ist kein Beleg für den Inhalt.
Training und Inferenz unterscheiden
| Frage | Training | Inferenz |
|---|---|---|
| Was passiert? | Modellparameter werden anhand von Daten angepasst. | Ein trainiertes Modell berechnet ein Ergebnis für neue Eingaben. |
| Was ist das Ergebnis? | Ein angepasstes Modell beziehungsweise ein neuer Modellstand. | Zum Beispiel Text, ein Bild, eine Einordnung oder ein Zahlenwert. |
| Was prüfst du? | Trainingsverfahren, Daten und spätere Evaluation. | Antwortqualität, Laufzeit, Ressourcen und Verhalten im konkreten Einsatz. |
| Lernt jede Chatantwort das Modell neu an? | Ein späteres Trainingsverfahren ist eine eigene Frage. | Die normale Antwortberechnung allein ist kein solcher Trainingsschritt. |
Ein Dienst kann Eingaben speichern oder später für ein gesondertes Training verwenden; ein Produkt kann auch eine Memory-Funktion anbieten. Solche Daten- und Produktregeln musst du separat prüfen. Sie folgen nicht allein aus dem Wort „Inferenz“.

Wie aus einer Eingabe Text entsteht
- Anfrage aufbereiten: Die Anwendung stellt Aufgabe, Anweisungen und zulässigen Kontext zusammen.
- Text in Tokens überführen: Der passende Tokenizer erzeugt die vom Modell verwendeten Einheiten und Kennungen.
- Modell berechnen lassen: Das Modell verarbeitet den Kontext. Bei autoregressiver Textgenerierung werden weitere Tokens schrittweise erzeugt.
- Ausgabe zurückgeben: Tokens werden als lesbarer Text ausgegeben; die Anwendung kann zusätzlich Formatprüfungen durchführen.
- Ergebnis kontrollieren: Du prüfst Inhalt, Quellen und die Anforderungen deiner Aufgabe.
Das ist ein vereinfachter Ablauf für Textgenerierung, keine Beschreibung jedes KI-Modells. Ein Klassifikationsmodell muss zum Beispiel keine längere Tokenfolge als Antwort erzeugen. Auch Werkzeugaufrufe und zusätzliche Modellschritte können einen realen Ablauf erweitern.
Auf dem eigenen Rechner oder über eine API?
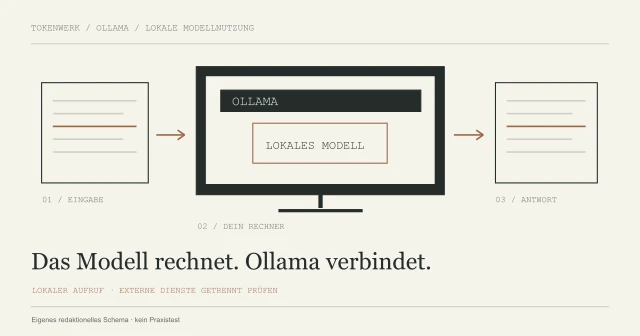
Für einen ersten eigenen Versuch kannst du ein lokales Modell mit Ollama nutzen. Du brauchst ein passendes Modell, eine Laufzeit und einen Rechner mit genügend Speicher. Die erste Antwort ist dann ein Inferenzvorgang auf diesem Setup, kein selbst durchgeführtes Modelltraining.
Bei einem API-Zugang läuft die Modellberechnung beim Anbieter. Deine Anwendung sendet die unterstützte Anfrage und verarbeitet die Antwort. Netzwerkweg, Warteschlangen, zusätzliche Werkzeuge und Nachbearbeitung können die wahrgenommene Zeit mitbestimmen. „Die Antwort dauerte fünf Sekunden“ ist ohne diese Einordnung noch kein reiner Modellgeschwindigkeitswert.
Ein lokaler Rechner braucht ebenfalls eine passende Konfiguration. Modellgröße, Zahlenformat, Kontextumfang und gleichzeitig laufende Anfragen beeinflussen den Ressourcenbedarf. Eine allgemeine Mindestmenge an Grafikspeicher für jede Form von Inferenz gibt es daraus nicht.
Welche Werte du beim Ausprobieren festhältst
| Wert | Was er beschreibt | Was er nicht allein belegt |
|---|---|---|
| Zeit bis zum ersten Token | Wie lange du bis zum ersten ausgegebenen Token wartest | Wie schnell die gesamte Antwort fertig wird. |
| Ausgaberate | Wie viele Tokens pro Zeitintervall erzeugt werden | Dass die Antwort richtig oder für die Aufgabe geeignet ist. |
| Gesamtdauer | Zeit für den von dir festgelegten kompletten Ablauf | Dass allein das Modell diese gesamte Zeit verursacht hat. |
| Durchsatz | Erledigte Arbeit pro Zeit unter einer bestimmten Last | Die Wartezeit einer einzelnen Anfrage. |
| Speicher und Kosten | Ressourcen beziehungsweise Abrechnung innerhalb der erfassten Grenzen | Ein allgemeines Preis-Leistungs-Ranking aller Modelle. |
Schreibe dazu, ob Modellladen, Netzwerk, Suche und Werkzeuge enthalten sind. Verwende dieselbe Eingabe, vergleichbare Ausgabelimits und einen klaren Start- und Endpunkt. Wiederhole einen Versuch, wenn du Schwankungen beurteilen willst. Eine ausgedachte Zahl oder ein Einzelwert von fremder Hardware wäre dafür keine belastbare Vergleichsbasis.
Welche Aussage ein Versuch tatsächlich erlaubt, zeigt unser dokumentierter lokaler Praxistest. Übertrage dessen Zeiten oder Ergebnisse nicht pauschal auf einen anderen Rechner, ein anderes Modell oder eine andere Aufgabe.
Ein Modell für die eigene Aufgabe auswählen
Für die Vorauswahl kannst du Modelle direkt vergleichen. Kontext, Ein- und Ausgabe sowie Zugang helfen bei der Eingrenzung. Eine allgemeine Eigenschaftentabelle ersetzt aber keinen Geschwindigkeitstest auf deiner tatsächlichen Aufgabe.
Beginne mit einem prüfbaren Ergebnis: etwa einer Zusammenfassung, die alle drei festgelegten Fakten erhält. Erst wenn die Antwort diese Prüfung besteht, helfen Unterschiede bei Wartezeit, Speicher und Kosten bei der Auswahl. Eine besonders schnelle falsche Antwort löst deine Aufgabe nicht.
Vorlage für einen kleinen Inferenzversuch
Aufgabe und erwartetes Ergebnis:
Modell-ID und Version:
Laufzeit/API und Datum:
Rechner oder Anbieterzugang:
Eingabe und erlaubter Kontext:
Ausgabelimit und Einstellungen:
Start- und Endpunkt der Zeitmessung:
Modellladen/Netzwerk/Werkzeuge enthalten?
Tatsächliche Antwort und Inhaltsprüfung:
Zeit, Nutzung/Kosten und offene Grenzen:Häufige Fragen
Was ist KI-Inferenz einfach erklärt?
Ein trainiertes Modell verarbeitet eine neue Eingabe und berechnet ein Ergebnis. Das kann eine Textantwort, eine Klassifikation oder eine andere Ausgabe sein. Die Berechnung garantiert keine richtige Antwort.
Wird bei jeder Chatantwort neu trainiert?
Die normale Antwortberechnung ist Inferenz und nicht automatisch ein Trainingsschritt mit angepassten Modellparametern. Ob ein Dienst Eingaben später speichert oder für gesondertes Training nutzt, ist eine separate Produkt- und Datenschutzfrage.
Brauche ich für Inferenz eine Grafikkarte?
Das hängt vom Modell und der Laufzeit ab. Manche Modelle lassen sich auf einer CPU ausführen; andere benötigen andere Ressourcen oder einen Anbieterzugang. Eine allgemeine Hardwareanforderung für jede KI-Inferenz gibt es nicht.
Sind Tokens pro Sekunde ein Qualitätswert?
Nein. Die Rate beschreibt Geschwindigkeit innerhalb bestimmter Bedingungen. Du musst Antwortqualität, Wartezeit, Ausgabelänge, Hardware und Kosten getrennt betrachten.
Was ist der Unterschied zwischen lokaler Inferenz und einer KI-API?
Bei lokaler Inferenz wird das Modell auf dem eigenen Gerät oder einer selbst betriebenen Umgebung ausgeführt. Bei einer Anbieter-API sendest du Anfragen an dessen Dienst. Die übrige Anwendung und verbundene Werkzeuge können trotzdem weitere Datenwege haben.
Quellen & Methode
Vorgehen und Grenzen
Stand: 27. Oktober 2026. Definitionen und technische Einordnung nach den genannten Originalquellen. Dieser Beitrag enthält keinen eigenen Modell- oder Hardwarebenchmark. Die Messvorlage dient deinem eigenen Versuch. Symbolbild mit KI gestaltet; Erklärgrafik redaktionell erstellt.
Bei Recherche, Texterstellung und Grafiken wird KI eingesetzt. Welche eigenen Versuche vorliegen und was nur als Beispiel dient, beschreibt dieser Beitrag. Unser Redaktionsstandard erklärt die Anforderungen an Belege und Berichtigungen.