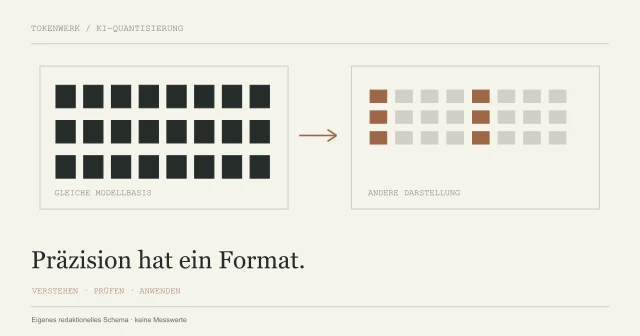
Wähle zuerst die Aufgabe, danach eine unterstützte Modellversion und eine zum Rechner passende Datei. Teste mit unkritischen Beispielen und prüfe den tatsächlichen Datenweg. Eine universelle Empfehlung für jeden Rechner gibt es nicht. Unser lokaler Ollama-Praxistest dokumentiert einen Erstaufruf, neun Folgeanfragen und drei JSON-Nachtests mit Qwen3.5 4B. Die Ergebnisse gelten für die dort beschriebenen künstlichen Aufgaben und das eingesetzte Laptop-Setup.
Welche Aufgabe soll das Modell zuverlässig erledigen?
Ein kurzer deutscher Textentwurf, eine Dokumentenfrage und das Bearbeiten eines Bildes stellen unterschiedliche Anforderungen. Lege deshalb einen Beispielsatz fest: „Das Modell soll aus einem freigegebenen Absatz drei Angaben extrahieren und fehlende Werte offenlassen.“
Danach prüfst du Ein- und Ausgabe des Modells. Ein Textmodell liest nicht automatisch Scans oder Audio. Zusätzliche OCR-, Sprach- oder Suchkomponenten gehören gesondert in die Auswahl. Definiere außerdem, woran du einen Fehler erkennst. Ein flüssig klingender Text ist noch kein ausreichendes Qualitätskriterium.
Dateigröße ist nicht der gesamte Speicherbedarf
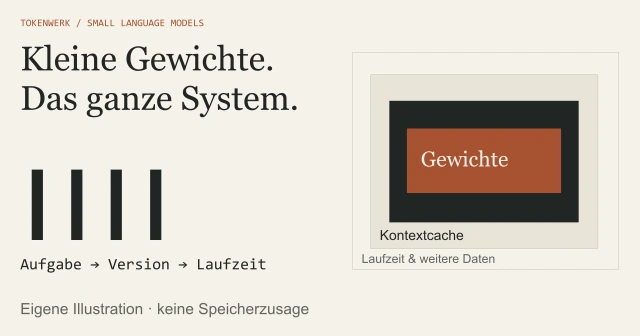
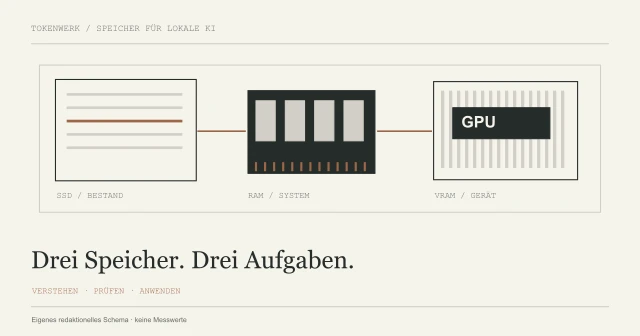
Zum Modell kommen unter anderem Arbeitsdaten der Laufzeit und der Kontextcache. Längere Eingaben und parallele Anfragen können den Speicherbedarf erhöhen. Ob Rechenarbeit auf GPU oder CPU landet, hängt vom Rechner, der Laufzeit und der Modellvariante ab. Die Berechnung eines Ergebnisses mit dem trainierten Modell heißt Inferenz; sie ist von einem neuen Trainingslauf zu unterscheiden.
Der Guide zum Speicherbedarf lokaler KI trennt diese Bestandteile. Versuche eine kleine, für deinen Rechner dokumentierte Variante, bevor du große Dateien auf Verdacht herunterlädst. Eine Quantisierung spart häufig Speicher; wie stark sie dein Ergebnis verändert, muss zu deiner Aufgabe geprüft werden.

Modellfamilie, Version und Dateiformat trennen
Halte Repository, Checkpoint und Quantisierung fest. Prüfe anschließend, ob deine Laufzeit diese Architektur und dieses Format unterstützt. Ein GGUF-Download und ein Safetensors-Repository sind nicht beliebig austauschbar. Die Ollama-Importdokumentation beschreibt dafür unterschiedliche Wege.
Auch beim Kontext solltest du tatsächliche Einstellungen prüfen. Die Kontextdokumentation erläutert den zusätzlichen Ressourcenbedarf. Allgemeine Dokumentationsseiten können unterschiedliche Voreinstellungen beschreiben; notiere deshalb deine installierte Version und die beobachtete Konfiguration.
Offene Datei, offene Nutzung?
Die erlaubte Nutzung folgt aus der konkreten Lizenz und gegebenenfalls weiteren Bedingungen. Prüfe das vor der Integration in ein Kundenprodukt oder einem internen Dienst. Der Unterschied zwischen Open Source und offene Gewichte hilft, Downloadbarkeit und tatsächliche Freiheiten auseinanderzuhalten.
Lege die geprüfte Lizenz zusammen mit dem Versionsverweis ab. Bei einem späteren Modellwechsel ist es sinnvoll, dieselbe Prüfung erneut durchzuführen. Ein ähnlich klingender Modellname beweist keine identischen Bedingungen.
Eine kleine Abnahme vor dem größeren Projekt
Fiktiver Test: Gib drei erfundene Termine mit jeweils einer fehlenden Angabe vor. Das Modell soll Datum, Ort und offenen Punkt in einer Tabelle zurückgeben. Prüfe jede Zeile an deiner Vorlage und wiederhole die Aufgabe mit einem bewusst widersprüchlichen Satz.
Eigenes Auswahlblatt · keine gemessenen Ergebnisse
Aufgabe und richtige Beispiellösung:
Modell / genaue Datei / Quantisierung:
Laufzeit und Version:
Verfügbarer RAM / VRAM:
Kontext und parallele Anfragen:
Antwort korrekt / unklar / falsch:
Beobachtete Laufzeit und Speicherbelegung:Mit Ollama mit GPU prüfen kannst du die tatsächliche Rechennutzung weiter prüfen. Tokenwerk behauptet mit dieser Vorlage keinen selbst ausgeführten Hardware- oder Modellvergleich.
Eine lokale App kann trotzdem Cloud-Funktionen nutzen
Die Ollama-API-Dokumentation nennt lokale und gehostete Endpunkte. Ein Aufruf an localhost und eine Anfrage an einen Cloud-Dienst haben unterschiedliche Datenwege. Die bloße Installation einer Desktop-App entscheidet diese Frage nicht. Wenn du mit Ollama beginnen möchtest, führt dich der Ollama-Einstieg von der Software zur ersten kontrollierten Antwort.
Prüfe auch Erweiterungen, Websuche und angebundene Werkzeuge. Die Ollama-FAQ beschreibt einen Modus ohne Cloud-Funktionen. Teste deine konkrete Konfiguration mit unkritischem Material und berücksichtige, dass Downloads und spätere Updates weiterhin einen eigenen Netzwerkbedarf haben.
Quellen & Methode
Vorgehen und Grenzen
Quellenprüfung am 19. Oktober 2026. Aktuelle Hersteller- und Behördenangaben sind von redaktionellen Beispielen getrennt. Tokenwerk hat keine eigene Produkt-, Hardware- oder Modellmessung ausgeführt. Datenschutz- und Lizenzhinweise dienen der Orientierung; der konkrete Einsatz benötigt seine passende betriebliche und gegebenenfalls rechtliche Prüfung.
Bei Recherche, Texterstellung und Grafiken wird KI eingesetzt. Welche eigenen Versuche vorliegen und was nur als Beispiel dient, beschreibt dieser Beitrag. Unser Redaktionsstandard erklärt die Anforderungen an Belege und Berichtigungen.