Lies zu einer Zahl immer Modellversion, Testversion, Einstellung, Aufgabe und Auswertung. Vergleiche gleiche Verfahren. Nutze die Ergebnisse für eine Vorauswahl und prüfe anschließend deine konkrete Aufgabe.
Was ist ein KI-Benchmark?
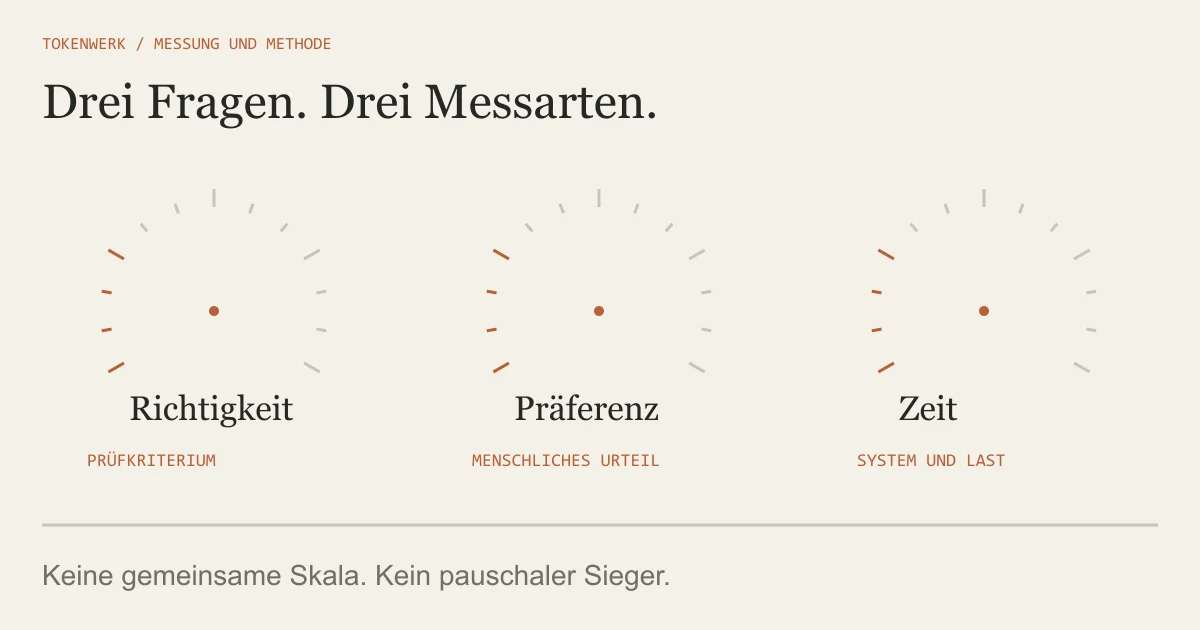
Ein Benchmark macht eine begrenzte Leistung beobachtbar. Er kann zum Beispiel Antworten mit Referenzlösungen vergleichen, menschliche Urteile sammeln oder Antwortzeiten messen. Diese Verfahren beantworten unterschiedliche Fragen und benötigen unterschiedliche Einheiten.
Der Unterschied wird bei einer Dokumentenaufgabe sichtbar: Eine Antwort kann flüssig klingen und bevorzugt werden, obwohl eine Zahl falsch übernommen wurde. Sie kann korrekt sein, aber zu langsam für eine interaktive Anwendung. Eine einzelne Gesamtnote würde diese Unterschiede verdecken.
Ein guter Ergebnisbericht nennt deshalb nicht nur einen Modellnamen. Er beschreibt, welche Version mit welchen Aufgaben und Einstellungen geprüft wurde und woran Erfolg erkannt wird. Eine Rangliste ohne diese Angaben ist für eine belastbare Auswahl unvollständig.
Richtigkeit, Präferenz und Tempo messen verschiedene Dinge
| Messung | Typische Einheit | Was offen bleibt |
|---|---|---|
| Antwort stimmt mit dem Prüfkriterium überein | Anteil richtiger Fälle oder aufgabenspezifischer Score | Übertragung auf andere Aufgaben, Sprache und Daten |
| Menschen bevorzugen eine Antwort | Präferenzrating nach dem jeweiligen Verfahren | Objektive Richtigkeit jeder Aussage |
| System antwortet unter bestimmter Last | Sekunden, Zeit bis zur ersten Ausgabe oder Tokens pro Sekunde | Inhaltliche Qualität und Verhalten bei anderer Hardware oder Last |
Beim Arena-Text-Battle sehen Menschen zunächst zwei anonymisierte Antworten, wählen eine Präferenz und erfahren danach die beteiligten Modelle. Das ist ein wertvolles Präferenzsignal. Es ist keine automatische Prüfung jeder darin genannten Tatsache. Andere Arena-Modi und Prüfungen müssen jeweils nach ihrer eigenen Methode gelesen werden.
Auch ein Index aus mehreren Prüfungen ist nicht einfach ein Prozentwert „Intelligenz“. Welche Tests einfließen, wie sie gewichtet werden und welche Version verwendet wird, gehört zur Definition dieses Index. Rechne unterschiedliche Skalen nicht zu einer eigenen scheinbar präzisen Siegerzahl zusammen.

Diese Angaben gehören zu jedem Ergebnis
Notiere die genaue Modell-ID oder Datei, Datum, Benchmarkversion und Sprache. Ergänze Promptvorlage, erlaubte Werkzeuge, Beispiele im Kontext, Ausgabelimit und relevante Samplingparameter. Bei lokalem Tempo kommen Hardware und Last hinzu. Ein Webprodukt mit Suchwerkzeug und eine nackte Modell-API sind verschiedene Systeme.
Die Dokumentation des lm-evaluation-harness zeigt solche Stellschrauben konkret: Aufgaben, Few-shot-Beispiele, Chattemplate, Generierungsparameter, Zufallsstart und gespeicherte Einzelantworten sind konfigurierbar. „Mit demselben Benchmark getestet“ reicht somit ohne Konfiguration nicht immer als Gleichheitsnachweis.
Methodenkarte zu einem Ergebnis
Modell-ID / Datei / Variante:
Testname / Version / Datum:
Sprache und Aufgabenauswahl:
Promptvorlage und Beispiele:
Erlaubte Werkzeuge / Webzugriff:
Ausgabelimit / Sampling / Zufallsstart:
Anzahl Fälle und Wiederholungen:
Bewertung / Einheit / Umgang mit Fehlern:
Hardware und Last, falls Tempo gemessen wird:
Originalquelle / offengelegte Grenzen:Nutze konkrete Modellversionen im Verzeichnis, um den Zugang und dokumentierte Eigenschaften zu prüfen. Ein Profil ersetzt dabei nicht die Methode des jeweiligen Benchmarks und beweist keine selbst gemessene Leistung.
Warum zwei Werte nicht automatisch vergleichbar sind
Schon andere Aufgaben, Vorlagen oder Antwortformate können einen Vergleich verändern. Manche Auswertungen verlangen eine genau formatierte Antwort. Ein inhaltlich richtiger Gedanke im falschen Format kann dann anders bewertet werden als bei menschlicher Lektüre. Das ist zunächst eine Eigenschaft der Prüfung, die im Bericht stehen muss.
Die historische Einführung von HELM Lite 1.0.0 aus dem Jahr 2023 erklärt den Unterschied zu HELM Classic: Bestimmte Metriken und Wiederholungen wurden reduziert, während der Fokus auf Fähigkeiten lag. Das Beispiel zeigt eine Methodenänderung; es ist keine aktuelle Modellrangliste. Ein gleich klingender Projektname macht unterschiedliche Versionen nicht identisch.
Achte außerdem auf Stichprobe, Schwankung und vorläufige Werte. Die aktuelle Arena-Policy beschreibt unter bestimmten Bedingungen vorläufige Ergebnisse für früh verfügbare oder zuvor anonym getestete Modelle. Behandle ein enges oder vorläufiges Ergebnis nicht als dauerhaften Abstand zwischen allen Produkten eines Anbieters.
Aus einem englischen Fachtest folgt auch keine geprüfte Qualität für deinen deutschen Brief. Für einen anderen Einsatz brauchst du zusätzliche passende Belege. Wenn die Testdetails fehlen, bleibt der Vergleich offen.
Ein kleiner eigener Test mit klaren Grenzen
Wähle eine begrenzte reale Aufgabe und erstelle zunächst unkritisches eigenes Material. Lege vor dem Test fest, welche Fehler relevant sind. Das folgende Beispiel ist selbst geschrieben und wurde hier nicht mit Modellen ausgeführt.
Fiktive Quelle und Prüffall
QUELLE
Im Pilotversuch wurden sechs Dokumente vorbereitet. Vier sind freigegeben. Die übrigen zwei dürfen noch nicht veröffentlicht werden. Ein Startdatum steht nicht fest.

AUFTRAG
Erstelle eine Tabelle: Gesamtzahl, freigegebene Zahl, zurückgehaltene Zahl und Startdatum. Verwende nur die Quelle. Nenne zu jedem Eintrag die passende Textstelle. Markiere fehlende Angaben als „nicht angegeben“.Deine Prüfkriterien sind hier konkret: sechs insgesamt, vier freigegeben, zwei zurückgehalten und kein erfundenes Datum. Halte pro Fall fest, was korrekt oder falsch war. Prüfe eine erzeugte Tabelle auch auf fehlende Zeilen und falsche Zuordnungen.
Dieser kleine Versuch erlaubt nur ein Fazit zu den gewählten Fällen. Er ist kein statistischer Nachweis allgemeiner Überlegenheit. Das Praxisprojekt zwei Modelle reproduzierbar vergleichen hilft dir, Bedingungen, Ausgaben und Bewertung für eine zweite Person nachvollziehbar festzuhalten.
So nutzt du Ranglisten für eine Entscheidung
Für eine erste Übersicht helfen passende öffentliche Prüfungen. Für eine Dokumentenextraktion zählt anschließend ein eigener Test auf richtige Werte und Belege. Für einen Chat unter Last brauchst du zusätzlich Tempo und Stabilität. Für einen Einsatz mit Werkzeugen musst du auch erlaubte Aktionen und die Kontrolle der Ergebnisse prüfen. Der Vergleich von KI-Tools ergänzt die Messwertlektüre um deinen vollständigen Arbeitsweg und die erforderliche Nacharbeit.
Formuliere dein Fazit mit Grenze: „Version A erfüllte in unserem dokumentierten Test diese Kriterien; andere Sprachen und größere Dateien wurden nicht geprüft.“ Das ist nützlicher als „Anbieter A ist die beste KI“. Eine Modellfamilie umfasst mehrere Versionen und Zugänge.
Im Benchmark-Explorer mit Quellen und Bedingungen bleiben konkrete Messwerte bei ihren jeweiligen Verfahren. Dort stehen unterschiedliche Skalen bewusst nebeneinander, ohne sie direkt zu verrechnen. Die Grafik dieses Artikels erklärt Messarten; sie enthält keine erfundenen aktuellen Rankings.
Quellen & Methode
Vorgehen und Grenzen
Aktuelle Hersteller- und Methodikdokumentation am 20. Oktober 2026 in den jeweils genannten Lesebereichen geprüft. Historische Vergleichstexte dienen der Intentanalyse. Vorlagen, Rechnungen und Illustrationen sind eigene Beispiele. Keine eigenen Hardwarebenchmarks, Modellvergleiche oder Audio-Erkennungsversuche.
Bei Recherche, Texterstellung und Grafiken wird KI eingesetzt. Welche eigenen Versuche vorliegen und was nur als Beispiel dient, beschreibt dieser Beitrag. Unser Redaktionsstandard erklärt die Anforderungen an Belege und Berichtigungen.