Erfasse zuerst die Hardware. Prüfe danach die Anforderungen deiner Laufzeit und des Modells. Kontrolliere beim kleinen Versuch, ob CPU oder GPU verwendet wird. Erst ein belegter Engpass begründet ein Upgrade.
Was macht einen PC für lokale KI geeignet?
Für einen ersten lokalen Chat brauchst du eine unterstützte Laufzeit, passende Modellgewichte und genügend freien Speicher. Für viele gleichzeitige Anfragen, sehr lange Dokumente oder aufwendige Bildverarbeitung gelten andere Bedingungen. Training und Inferenz sind ebenfalls verschiedene Aufgaben: Beim Training werden Gewichte verändert, bei der Inferenz wird ein vorhandenes Modell ausgeführt.
„KI-PC“ bezeichnet keine einheitliche Leistungszusage für jedes Sprachmodell. Eine NPU ist ein spezialisierter Rechenbaustein. Ob dein gewähltes Programm sie tatsächlich nutzt, hängt von dessen unterstützten Backends ab. Ein Backend ist der technische Rechenweg zwischen Anwendung und Hardware.
Schreibe dein Vorhaben in einen Satz, etwa: „Ich möchte eine kurze eigene Notiz lokal in eine Tabelle umwandeln.“ Halte fest, ob du einen Desktopchat oder eine API für eine andere Anwendung brauchst. Damit wird aus einer unbestimmten Kaufidee eine prüfbare Anforderung.
Erst den vorhandenen Rechner erfassen
Notiere Betriebssystem und Version, CPU beziehungsweise Chip, eingebauten Arbeitsspeicher, GPU samt Grafikspeicher und freien Datenträgerplatz. Bei Apple Silicon teilen sich CPU und GPU den vereinheitlichten Speicher. Eine entsprechende Zahl lässt sich deshalb nicht einfach mit separatem RAM plus VRAM einer anderen Architektur gleichsetzen. Die Speicherplanung am Mac mini für lokale KI zeigt diesen Fall an Modellbedarf, Kontext und übrigen Programmen.
Unter Windows findest du Speicher und GPU im Task-Manager unter „Leistung“, auf dem Mac unter „Über diesen Mac“ und den Systeminformationen. Unter Linux liefern beispielsweise uname -m, free -h und df -h Informationen zu Architektur, Arbeitsspeicher und Datenträgern. Diese Befehle verändern keine Konfiguration.
Deine Rechnerinventur
Aufgabe und gewünschte Anwendung:
Betriebssystem / Version / Architektur:
CPU oder Chip:
Installierter und aktuell freier RAM:
GPU / eigener VRAM oder gemeinsamer Speicher:
Freier Datenträgerplatz:
Laufzeit / Version:
Modell-ID / genaue Datei / Quantisierung:
Geplanter Kontext und gleichzeitige Anfragen:
Noch ungeprüfte Voraussetzungen:Die LM-Studio-Anforderungen zeigen, warum Details zählen: Auf dem Mac werden Apple Silicon und macOS 14 oder neuer genannt; für Windows x64 ist AVX2 erforderlich. 16 GB RAM sind dort eine Empfehlung, keine Zusage, dass jedes Modell mit jedem Kontext hineinpasst. Übertrage diese Angaben nicht ungeprüft auf eine andere Anwendung.
LLM-Hardware: RAM und VRAM richtig planen
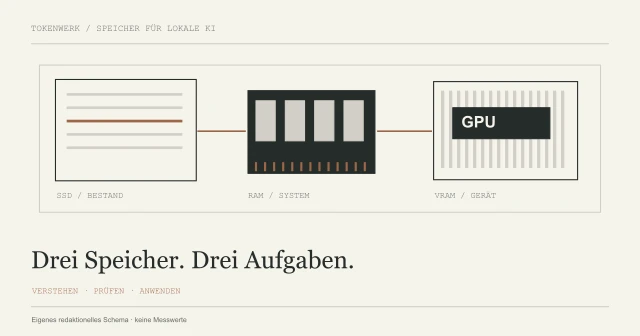
RAM ist der Arbeitsspeicher des Rechners, VRAM der eigene Speicher einer entsprechenden GPU. Auf dem Datenträger abgelegte Gewichte müssen für die Berechnung in einen unterstützten Speicherweg geladen werden. Je nach Laufzeit kann ein Modell ganz auf CPU, ganz auf GPU oder verteilt laufen. „Die Datei passt auf die SSD“ ist deshalb kein ausreichender Nachweis. Der vertiefende Guide zum Speicherbedarf lokaler KI zeigt, welche Bestandteile neben der Modelldatei in deine Planung gehören.
Eine vereinfachte Rechnung macht die Größenordnung verständlich: Acht Milliarden Parameter mit vier Bit je Gewicht ergeben 8.000.000.000 × 4 / 8 = 4.000.000.000 Byte, also vier dezimale Gigabyte reine Gewichtsdaten. Das ist eine idealisierte Untergrenze. Quantisierungsmetadaten, Kontextcache, Zwischenergebnisse, Laufzeit und Betriebssystem kommen hinzu. Eine reale 4-Bit-Datei und der tatsächliche Speicherbedarf können davon abweichen.
Auch lange Eingaben kosten Speicher. In Ollama erhöhen Kontext und parallele Verarbeitung den zusätzlichen Bedarf. Plane deshalb mit deiner wirklichen Aufgabe und prüfe den aktiven Wert. Die Anleitung zum Ollama-Kontextfenster einstellen führt von der Vorgabe zum tatsächlich geladenen Kontext.
Nutze eine kleine, dokumentierte Modellvariante für den Einstieg. Eine höhere Parameterzahl ist kein Ersatz für einen eigenen Qualitätscheck. Quantisierung kann Gewichte verkleinern; ob das Ergebnis für deine Aufgabe genügt, musst du anschließend prüfen.

Ollama, Vulkan und der passende Rechenweg
| Plattform / Hardware | Zu prüfender Weg | Wichtige Grenze |
|---|---|---|
| NVIDIA | Unterstützte GPU, Compute Capability und Treiber | Ein Markenname allein bestätigt weder Geräteunterstützung noch ausreichend VRAM. |
| AMD unter Windows oder Linux | Gerätespezifische ROCm-/HIP-Unterstützung oder geeigneter anderer Backendpfad | Die unterstützten Geräte unterscheiden sich nach Plattform. |
| Apple GPU | Metal | Gemeinsamer Speicher und unterstützte Modellvariante bleiben zu prüfen. |
| Windows / Linux mit Vulkan | Installiertes Vulkan-Backend und passende GPU-/Treiberunterstützung | Laut aktuellem Dokument standardmäßig aktiv, wenn das Backend installiert ist; kein pauschaler Geschwindigkeitsgewinn. |
Die Ollama-GPU-Matrix ist vor Installation oder Kauf die maßgebliche konkrete Referenz. Wiederhole keine ältere Anleitung, die Vulkan generell erst mit OLLAMA_VULKAN=1 als experimentelle Sonderfunktion einschaltet. Die aktuelle Dokumentation beschreibt einen anderen Standard. Daraus folgt trotzdem keine Zusage, dass jede Vulkan-fähige Karte deine Aufgabe gut ausführt.
Bei einem Container muss die Hardware außerdem im Container erreichbar sein. Der Guide Ollama in Docker mit GPU betreiben trennt Grundsetup, Treiber und GPU-Zugriff. Ein funktionierender Docker-Start belegt noch keinen GPU-Betrieb. Ändere keine Geräteberechtigungen oder Sicherheitsmechanismen auf Verdacht.
Prüfen, wo dein Modell wirklich läuft
Öffne nach dem Laden eines lokalen Modells ein zweites Terminal und nutze den dokumentierten Befehl ollama ps. Die Spalte PROCESSOR zeigt CPU-, GPU- oder gemischte Belegung. Halte zusätzlich Laufzeitversion, Modelltag und Kontext fest. Ein leeres Ergebnis kann bedeuten, dass gerade kein Modell geladen ist; es ist kein GPU-Defektbeweis.
Kleine, selbst erstellte Probe
QUELLE
Im Übungsordner liegen drei Textdateien. Zwei davon sind geprüft. Für die dritte fehlt eine Freigabe.

AUFTRAG
Erstelle eine Tabelle mit Gesamtzahl, geprüfter Zahl und offenem Punkt. Verwende ausschließlich die Quelle. Erfinde keinen Dateinamen.Kontrolliere erst die Richtigkeit. Notiere dann beobachtete Ladezeit, Reaktionsverhalten und Speicherbelegung unter denselben Bedingungen. Die Beispielaufgabe wurde für diesen Artikel nicht als Hardwarebenchmark ausgeführt. Ohne gleichen Kontext, gleiche Variante und gleiche Last sind zwei Zeitangaben kein fairer Vergleich.
Wann aufrüsten – und wann erst das Setup ändern?
Wenn ein Download scheitert, prüfe zunächst Datenträger und Verbindung. Wenn das Modell nicht lädt, gleiche Format, Laufzeit und Speicher ab. Wenn der Rechner während langer Eingaben auslagert, reduziere zunächst unnötigen Kontext oder Parallelität und wiederhole dieselbe Aufgabe. Ist die GPU ungenutzt, untersuche zuerst Unterstützung und Backend.
Erst danach lässt sich eine Kaufentscheidung eingrenzen: mehr Speicher, eine unterstützte GPU mit passendem VRAM oder ein anderer Rechner. Ein CPU-Tausch behebt keinen fehlenden GPU-Treiber. Ein NPU-Label behebt kein inkompatibles Modellformat. Prüfe auch Netzteil, Gehäuse, Kühlung und die Möglichkeit einer Erweiterung am konkreten Gerät.
Wenn du den gesamten Weg lernen möchtest, führt dich der Lernpfad für lokale KI von Gewichten und Laufzeit bis zur ersten überprüften Antwort. Das Titelbild hier ist eine bildgenerierte Hardware-Konzeptszene. Es zeigt kein getestetes Kaufprodukt und keine empfohlene reale Komponentenliste.
Quellen & Methode
Vorgehen und Grenzen
Aktuelle Hersteller- und Methodikdokumentation am 20. Oktober 2026 in den jeweils genannten Lesebereichen geprüft. Historische Vergleichstexte dienen der Intentanalyse. Vorlagen, Rechnungen und Illustrationen sind eigene Beispiele. Keine eigenen Hardwarebenchmarks, Modellvergleiche oder Audio-Erkennungsversuche.
Bei Recherche, Texterstellung und Grafiken wird KI eingesetzt. Welche eigenen Versuche vorliegen und was nur als Beispiel dient, beschreibt dieser Beitrag. Unser Redaktionsstandard erklärt die Anforderungen an Belege und Berichtigungen.