1017 ist ein Update von V4.1 Flash, keine bestätigte neue Pro-Generation. Die Gewichte sind unter MIT veröffentlicht. DeepSeek meldet bessere Ergebnisse bei kürzeren Abläufen; die genannten Messwerte stammen vom Hersteller und sind keine Tokenwerk-Tests.
Der Name im Code bleibt deepseek-flash
Im aktuellen DeepSeek-Modellprofil steht jetzt die Zuordnung zum 1017-Checkpoint. Bestehende Links behalten ihre Adresse. Die API-ID ist ein laufender Alias: Wer darüber eine Anfrage sendet, pinnt damit nicht dauerhaft einen bestimmten Gewichte-Stand.
Die aktuelle Preisseite nennt 1M Kontext, maximal 384K Output sowie Text- und Bildverarbeitung für Flash. Die veröffentlichten Gewichte bilden einen separaten Weg für den eigenen Betrieb. Deren Referenzimplementierung ist kein fertiger Installer für kleine Rechner.
API-Konfiguration · dokumentierte ID
Modell: deepseek-flash
Basis-URL: https://api.deepseek.com
Dokumentierter Checkpoint am 19.10.2026: DeepSeek-V4.1-Flash-1017Lege bei einem Vergleich Endpunkt, Datum, Einstellungen und gemeldete Version ab. Ein historischer Versuch unter dem gleichen Alias kann noch mit älteren Gewichten gelaufen sein.
Drei Anbieterwerte – mit ihren Testbedingungen
| Prüfung | V4.1 Flash vorher | Flash 1017 | Bedingung |
|---|---|---|---|
| Terminal-Bench 4.0 | 31,2 | 42,3 | Claude-Code-Harness |
| DeepSWE v1.1 | 74,2 | 77,0 | Mini-SWE-V2-Harness |
| ProgramBench | 20,3 | 29,1 | Herstellervergleich der Modellkarte |
Die Tabelle zeigt einzelne Ergebnisse aus der offiziellen Modellkarte. Sie ist weder eine unabhängige Nachmessung noch eine Garantie für deinen Coding-Agenten. Andere Testversionen, Werkzeuge oder Auswertungen sind keine austauschbaren Tabellenzeilen. Der Lernpfad Modelle und Benchmarks beurteilen führt durch diese Unterschiede.
Aus kürzeren Antworten folgt nicht automatisch ein fixer Prozentsatz an Kostenersparnis. Dafür brauchst du den tatsächlich abgerechneten Verbrauch deines Ablaufs und seine fachliche Erfolgsquote.

Peak und Off-Peak auseinanderhalten
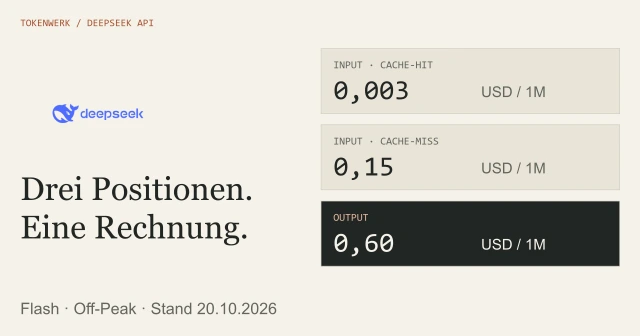
| Tarif | Input | Output |
|---|---|---|
| Off-Peak | 0,15 USD | 0,60 USD |
| Peak | 0,30 USD | 1,20 USD |
Peak liegt laut Anbieter montags bis freitags von 01–04 und 06–10 Uhr UTC, chinesische Feiertage ausgenommen. Die übrige Zeit zählt als Off-Peak. Cache-Treffer sind eine eigene Tarifkategorie. Der Tokenwerk-Rechner verwendet den dokumentierten Peak-Tarif ohne Cache.
Eigene Rechenillustration: 100.000 Eingabe- und 20.000 Ausgabetokens kosten ohne Zusatzleistungen 0,027 USD Off-Peak oder 0,054 USD Peak. Das ist keine beobachtete Agentensitzung. Wie du alle Anfragen und Nacharbeit einbeziehst, zeigt Kosten und Nutzen prüfen.
Search und Fetch sind eigene APIs
Parallel zum Modellrefresh hat DeepSeek seine Suche und den Seitenabruf als separate Schnittstellen geöffnet. Search findet Seiten, Fetch ruft eine einzelne Seite ab. Diese Werkzeugdienste sind keine zusätzliche Modellgeneration.
Laut Dokumentation kostet jeder Dienst 0,75 USD je 1.000 erfolgreiche, nicht leere Abrufe. Serverseitige Aufrufe über die genannten Integrationen sind vorübergehend gebührenfrei; deren Abrechnung beginnt am 31. Oktober 2026 um 16 Uhr UTC, entsprechend dem 1. November um 00 Uhr in Peking. Das gilt nicht pauschal als kostenlose Nutzung aller direkten API-Aufrufe. Modell- und Werkzeugkosten bleiben getrennt zu betrachten.
Vor einem produktiven Wechsel eine bekannte Aufgabe wiederholen
- Ausgangslage sichern: Beispielmaterial, bisheriges Ergebnis und Einstellungen festhalten.
- Gleiche Aufgabe senden: Keine zusätzlichen Promptänderungen mit dem Modellrefresh vermischen.
- Verhalten prüfen: Ausgabeformat, Tool Calls, Fehlerbehandlung und fachliches Ergebnis kontrollieren.
- Verbrauch auswerten: Tatsächliche Tokens, Werkzeugaufrufe und nötige Nacharbeit vergleichen.
Die offizielle API stellt den neuen Checkpoint über den bisherigen Alias bereit. Diese redaktionelle Prüfliste wurde nicht als eigener Leistungstest ausgeführt. Aussagen über V4.1 Pro oder eine weitere Generation werden daraus nicht abgeleitet. Der Vier-Anbieter-Vergleich ordnet diesen DeepSeek-Zugang neben Claude, OpenAI und Gemini anhand dokumentierter Eigenschaften und gemeinsamer Prüffragen ein.
Quellen & Methode
Vorgehen und Grenzen
Quellenprüfung am 19. Oktober 2026. Herstellerangaben sind entsprechend gekennzeichnet; Tokenwerk hat keinen eigenen Modell- oder Hardwaretest ausgeführt. Beispiele und Prüfschritte sind redaktionell erstellt. Die vollständige Recherche und der Linkplan liegen im lokalen Projektarchiv.
Bei Recherche, Texterstellung und Grafiken wird KI eingesetzt. Welche eigenen Versuche vorliegen und was nur als Beispiel dient, beschreibt dieser Beitrag. Unser Redaktionsstandard erklärt die Anforderungen an Belege und Berichtigungen.