Text & Reasoning
GPT-6.1 Sol
Für Programmierung und professionelle Aufgaben; Tool-Aufrufe sind in der Responses API dokumentiert.
Technologie verstehen.
Besser entscheiden.
 Text & Reasoning
GPT-6 Astra ist im OpenAI-Katalog für anspruchsvolle Analyse-, Code- und Werkzeugaufgaben positioniert. Es verarbeitet Text und Bilder und antwortet mit Text. Das Profil ordnet Funktion, Kontextgrenzen und Tarif ein, ohne daraus einen allgemeinen Qualitätsrang abzuleiten.
Nutze den in den Quellen genannten Anbieterzugang für genau diese Version. Ein Produktabo enthält nicht automatisch API-Guthaben.
Aktuell im HerstellerkatalogQuellenstand 2026-10-13
OpenAI im Verzeichnis
Nachprüfung am 24. Oktober 2026; Herstellerdokumentation, kein eigener Modelltest.
OpenAI hat am 20. Oktober eine12-Stunden-Cacheoption in der Responses API ergänzt; deren Schreibkosten betragen laut Changelog 2,5 mal den Inputtarif. Am 22. Oktober wurde die Decisions API mit GPT-6 Luna allgemein verfügbar und unterstützt bis 400 Fragen je Request. Diese Funktion wird nicht anderen Modellen als unterstützt zugeschrieben. Der Datenstand der übrigen Modellfelder steht weiterhin separat im Profil.
Herstellerquelle zum Update · geprüft am 24. Oktober 2026
Identität, Funktionen und Betrieb getrennt lesen. Die Angaben beziehen sich auf diese konkrete Version.
„Nicht bestätigt“ kennzeichnet eine offene Angabe. Es bedeutet weder „nicht vorhanden“ noch „unbegrenzt“.
| Hersteller | OpenAI |
|---|---|
| Modellfamilie | GPT |
| Modell-/API-ID | gpt-6-astra |
| Status | Aktuell im Herstellerkatalog |
| Modellart | Text & Reasoning |
|---|---|
| Eingabe | Text, Bild |
| Ausgabe | Text |
| Kontext | 1.050.000 Tokens |
|---|---|
| Maximaler Output / Horizont | 128.000 Tokens |
| Bereitstellung | Gehostete API |
|---|---|
| Gewichte | Gehosteter oder integrierter Zugang |
| Lizenz | Anbieterbedingungen |
Input und Output sind getrennte Texttarife je einer Million Tokens. Preisstufen, Cache, Werkzeuge und weitere Bedingungen stehen im Kostenabschnitt. Kein Preis für eine konkrete Aufgabe.
Datenbasis: Herstellerangaben im Quellenstand 2026-10-13. Quellen zu diesem Profil ↓

OpenAI nennt unter anderem mehrstufige Abläufe mit Code, Browsern und Dokumenten als Einsatzgebiete. In einer Anwendung entstehen diese Abläufe aus Modell, zugelassenen Werkzeugen und eigener Steuerung. Ein Modellname allein öffnet keinen Browser und legt keine Berechtigungen fest. Auch eine automatisierte Aufgabe braucht Kriterien für ein korrektes Ergebnis. Das Vergleichsblatt für KI-Tools hilft dir, Ergebnis, Datenweg und erforderliche Nacharbeit für dieselbe Aufgabe festzuhalten.
Die API-ID lautet gpt-6-astra. Reasoning-Effort unterstützt low, medium, high, xhigh und max. Die aktuelle Familienanleitung schließt none aus und verlangt für Werkzeugaufrufe die Responses API. Chat Completions ist unterstützt, aber bei Astra nicht die Schnittstelle für Tool Calling.
Text und Bilder sind Eingaben, Text ist die native Ausgabe. Unterstützte Werkzeuge können andere Ergebnisse erzeugen, beispielsweise eine Bilddatei. Das ist eine Werkzeugfunktion und sollte nicht als native Bildausgabe von Astra in einem Modellvergleich stehen.
Die Modellseite nennt 1.050.000 Tokens Gesamtkontext, maximal 922.000 Eingabetokens und 128.000 Ausgabetokens. Diese Zahlen begrenzen eine Anfrage, messen aber nicht die Zuverlässigkeit langer Analysen. Eine kleine Aufgabe mit mehreren überprüfbaren Bedingungen ist ein besserer Start für deine eigene Bewertung als eine pauschale Siegerbezeichnung.
Der Standardtarif beträgt je Million Tokens 10 USD normale Eingabe, 1 USD Cache-Lesen, 12,50 USD Cache-Schreiben und 50 USD Ausgabe. Über 272.000 Eingabetokens steigt der Eingabe-/Cachetarif für die ganze Anfrage auf das Doppelte, der Ausgabetarif auf das 1,5-Fache. Fast und Ultrafast haben eigene Tarife.
Fiktive Standardrechnung: 10.000 normale Eingabetokens und 2.000 Ausgabetokens ergeben 0,20 USD. Ein hoher Preis pro Token beantwortet noch nicht die Kosten pro erfolgreich gelöster Aufgabe. Zusätzliche Werkzeug-, Bild- oder andere Verarbeitungskosten und Steuern sind in dieser Rechnung nicht enthalten.
Zugang: Gehostete API. Eine öffentlich dokumentierte Modell-ID bestätigt keine Freischaltung deines Kontos.
Textkosten im Rechner schätzen →Praxisergänzung geprüft am 21. Oktober 2026 · eigene Aufgabe, kein Modellbenchmark
Ein teureres Modell lohnt sich erst, wenn sein Ergebnis bei deinen schwierigen Aufgaben einen überprüfbaren Nutzen hat. Der folgende Fall trennt abgeschlossene Arbeit von fehlenden Informationen. Er ist klein genug, dass du jede Entscheidung selbst nachlesen kannst. Die Aufgabe prüft Regelanwendung und den Umgang mit Unsicherheit; sie misst weder allgemeine Intelligenz noch die Zuverlässigkeit eines autonomen Agenten.
Wähle für die API gpt-6-astra. OpenAI dokumentiert mehrere Reasoning-Stufen; eine höhere Stufe verändert den Verarbeitungsaufwand, ist aber keine Abnahmegarantie. Gib hier weder Browser- noch Shellrechte frei. Für einen fairen Vergleich behältst du Vorlage, gewünschtes Ergebnis und Einstellungen bei und notierst tatsächliche Nutzung statt eines geschätzten Preisvorteils.
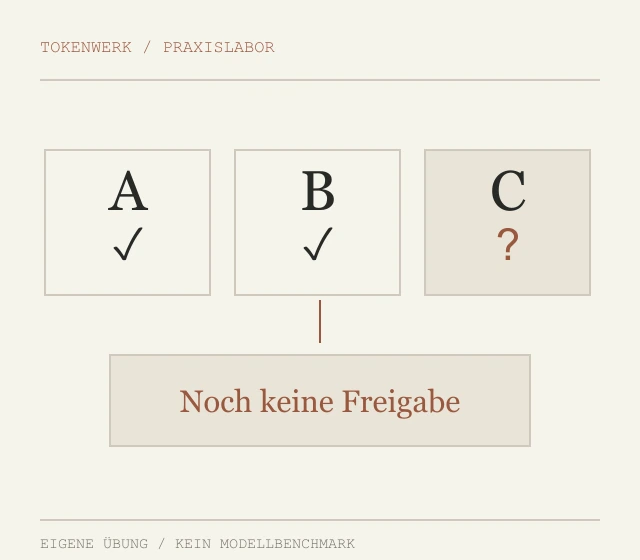
Lege die Freigaberegel vor dem ersten Versuch fest und kopiere sie zusammen mit allen vier Befunden.
Lass dir neben dem strukturierten Ergebnis eine kurze Begründung mit den jeweiligen Befundbuchstaben geben.
Ändere im Gegenversuch nur den fehlenden Nachweis C auf bestanden. Erst dadurch darf sich das Gesamtergebnis ändern.
Die Angaben sind fiktiv. Speichere den geforderten JSON-Teil der Antwort separat als antwort.json; zusätzliche Erklärungen gehören in eine andere Datei.
Fiktive Freigaberegel: Freigabe nur, wenn A, B und C bestanden sind. Unbekannt zählt nicht als bestanden.
A: Sicherung geprüft, bestanden.
B: Wiederherstellung geprüft, bestanden.
C: Zustimmung des Datenverantwortlichen, unbekannt.
D: Oberfläche sieht fertig aus. D ist kein Freigabekriterium.
Liefere zuerst JSON mit freigabe (Boolean), blockierende_nachweise (sortierte Liste), rueckfrage_an (Text).
Verwende für rueckfrage_an genau "Datenverantwortlicher". Begründe danach die Entscheidung mit A bis D. Führe keine Aktion aus.Vorlage herunterladenLokalen JSON-Prüfer herunterladen
{
  "freigabe": false,
  "blockierende_nachweise": [
    "C"
  ],
  "rueckfrage_an": "Datenverantwortlicher"
}Das Soll ist redaktionell aus der Vorlage abgeleitet, keine aufgezeichnete Modellantwort. Der lokale Prüfer vergleicht die festgelegten Felder und führt keinen generierten Code oder API-Aufruf aus. Er bewertet keine freien Begründungen.
Speichere Prüfer und deine Antwort im selben Ordner. Mit installiertem Python: python pruefen.py antwort.json.
| Beobachtung | Was du prüfst |
|---|---|
| Freigabe trotz unbekanntem C | Ein fehlender Nachweis wurde als Zustimmung gelesen. |
| D wird zum Muss-Kriterium | Das Modell hat die vorher festgelegte Regel verändert. |
| Keine Kosten-/Einstellungsnotiz | Ein späterer Modellvergleich ist schwer reproduzierbar. |
Wie du aus solchen Einzelproben eine begründete Auswahl machst, lernst du in Modelle mit denselben Aufgaben bewerten mit festgelegten Qualitätskriterien.
Für die praktische Auswertung kannst du einen Modellvergleich dokumentieren und dabei Einstellungen, Fehler und tatsächliche Kosten zusammenhalten.
Gezielte Praxisergänzung auf Basis aktueller Herstellerunterlagen. Der Datenstand der bisherigen Modell-Faktentabellen bleibt separat ausgewiesen. Neue Beispiele und Grafiken sind eigene Erklärungen; es wurden keine Modellantworten oder Leistungswerte gemessen.
Herstellerunterlagen zur Ergänzung: GPT-6 Astra Model | OpenAI API (Abruf 2026-10-21) · Function calling | OpenAI API (Abruf 2026-10-21).
Die verlinkten Herstellerunterlagen wurden für dieses Profil ausgewertet. Ältere Versionen und Einführungstexte dienen der Einordnung; aktuelle technische Angaben haben Vorrang. Abrufdaten stehen an den Quellen. Die Grafik ist redaktionell, kein Leistungstest.
Für anspruchsvolle Reasoning-, Code-, Computer-Use-, Recherche- und Dokumentaufgaben. Das ist eine Herstellerpositionierung. Die Eignung für ein konkretes Projekt muss mit eigenen Aufgaben geprüft werden.
Die aktuelle GPT-6-Anleitung schließt none bei Astra aus. Die Modellseite nennt die unterstützten Stufen low, medium, high, xhigh und max.
Die native Modellbeschreibung nennt Text- und Bildeingabe sowie Textausgabe. Ein unterstütztes Image-Generation-Werkzeug kann zusätzlich Bilder erzeugen; Modell- und Werkzeugausgabe sind getrennt zu betrachten.
10 USD je Million normaler Eingabetokens und 50 USD je Million Ausgabetokens. Cache hat eigene Kategorien. Über 272.000 Eingabetokens gilt für die gesamte Anfrage ein höherer Tarif; Fast und Ultrafast werden separat berechnet.
Nein. Die Abhängigkeitsaufgabe enthält nur fiktive Vorgaben und vorab definierte Prüfkriterien. Sie wurde nicht mit Astra ausgeführt und liefert keinen Qualitätsrang.
Im dokumentierten Quellenstand: 1.050.000 Tokens. Beachte die Bedingungen der konkreten Modellversion und des verwendeten Endpunkts. Kontext ist keine Wortzahl und kein Nachweis, dass jede enthaltene Information zuverlässig verarbeitet wird.
Lege eine kleine Aufgabe mit bekanntem oder nachprüfbarem Ergebnis fest. Notiere Version, Eingabe und Einstellungen. Vergleiche die Ausgabe mit deinem Prüfkriterium und halte Fehler sowie tatsächliche Kosten getrennt fest. Die Testidee auf dieser Seite ist ein Vorschlag und wurde hier nicht als Modelltest ausgeführt.
Nein. Sie zeigt höchstens, dass diese konkrete Aufgabe unter den notierten Bedingungen gelöst wurde. Weitere unabhängige Fälle und Wiederholungen sind nötig.
Ändere ausschließlich C von unbekannt auf bestanden und starte mit denselben übrigen Bedingungen neu. Dann darf die Regel eine Freigabe ergeben.
Nein. Sie verwendet nur die fiktive Textvorlage. Werkzeuge und automatische Freigaben sind nicht Bestandteil der Übung.
Text & Reasoning
Für Programmierung und professionelle Aufgaben; Tool-Aufrufe sind in der Responses API dokumentiert.
Text & Reasoning
Für häufige, klar abgegrenzte Text-, Analyse- und Klassifikationsaufgaben.
Text & Reasoning
Text- und Bild-Eingaben mit Text-Ausgabe. GPT-6 Sol wird weiterhin im OpenAI-Katalog geführt; für neue Projekte auch die GPT-6-Reihe vergleichen.