Embeddings
text-embedding-3-large
text-embedding-3-large ist ein Embeddings-Modell von OpenAI. Eingabe: Text. Ausgabe: Embedding-Vektoren.
Technologie verstehen.
Besser entscheiden.
 Embeddings
text-embedding-3-small ist ein Embedding-Modell von OpenAI. Es stellt Eingaben als Zahlenvektoren dar. Damit kannst du Ähnlichkeiten untersuchen, etwa für eine Suche nach passenden Dokumenten.
Nutze den in den Quellen genannten Anbieterzugang für genau diese Version. Ein Produktabo enthält nicht automatisch API-Guthaben.
Aktuell im HerstellerkatalogQuellenstand 2026-10-13
OpenAI im Verzeichnis
Identität, Funktionen und Betrieb getrennt lesen. Die Angaben beziehen sich auf diese konkrete Version.
„Nicht bestätigt“ kennzeichnet eine offene Angabe. Es bedeutet weder „nicht vorhanden“ noch „unbegrenzt“.
| Hersteller | OpenAI |
|---|---|
| Modellfamilie | GPT |
| Modell-/API-ID | text-embedding-3-small |
| Status | Aktuell im Herstellerkatalog |
| Modellart | Embeddings |
|---|---|
| Eingabe | Text |
| Ausgabe | Embedding-Vektoren |
| Kontext | Nicht bestätigt |
|---|---|
| Maximaler Output / Horizont | Nicht bestätigt |
| Bereitstellung | Gehostete API |
|---|---|
| Gewichte | Gehosteter oder integrierter Zugang |
| Lizenz | Anbieterbedingungen |
Die Grafik zeigt die ausgewiesenen Eingabe- und Ausgabearten. Sie beschreibt einen Arbeitsweg und enthält keine erfundenen Messwerte oder Leistungswerte.
Datenbasis: Herstellerangaben im Quellenstand 2026-10-13. Quellen zu diesem Profil ↓

text-embedding-3-small ist ein Embeddings-Modell von OpenAI. Eingabe: Text. Ausgabe: Embedding-Vektoren.
Embeddings sind Vektoren für Ähnlichkeit und Retrieval. Nutze dieselben Dokumente und Suchfragen, halte Dimension und Vorverarbeitung fest und bewerte relevante Treffer. Die Grundlagen zu Vektordatenbanken erklären, wie solche Repräsentationen bei der Suche verwendet und passende Treffer geprüft werden.
Prüfe vor einem API-Aufruf, ob dein Konto Zugriff hat und welchen Endpunkt, Tarif und welche Region du verwenden musst. Notiere die genaue Modellversion. Ein Kurzname in der API kann später auf einen anderen Modellstand verweisen.
Leistung: Wir haben die Leistung dieses Modells hier nicht selbst gemessen. Nutze die Aufgabe unten, um es an deinen Anforderungen zu prüfen.
Standardtarif für Texttokens. Bild-, Audio-, Werkzeug-, Cache- und Verarbeitungstarife werden separat berechnet.
Zugang: Gehostete API. Prüfe vor einer Integration die für dein Konto und deine Region verfügbaren Endpunkte. Ein Eintrag im öffentlichen Katalog ist keine Bestätigung eines freigeschalteten Kontos.
Praxisergänzung geprüft am 21. Oktober 2026 · eigene Aufgabe, kein Modellbenchmark
Ein Embedding-Modell schreibt keine Antwort auf deine Frage. Es wandelt Text in Zahlenvektoren um, die eine Anwendung miteinander vergleicht. Für einen verständlichen Einstieg reichen drei Dokumente und eine Frage. Hier soll die Frage nach dem Kennwort zur Passage über die Kontoeinstellungen führen, obwohl dort ein anderes Wort für dieselbe Sache steht.
Das Beispiel nutzt die dokumentierte Embeddings-Schnittstelle und die ID text-embedding-3-small. Dafür brauchst du Python, das Paket openai und einen selbst eingerichteten API-Zugang. Der Schlüssel gehört in die Umgebung, nicht in das Beispiel. Der Code erzeugt erst bei deinem bewussten Start eine externe API-Anfrage; auf Tokenwerk läuft keine solche Anfrage.
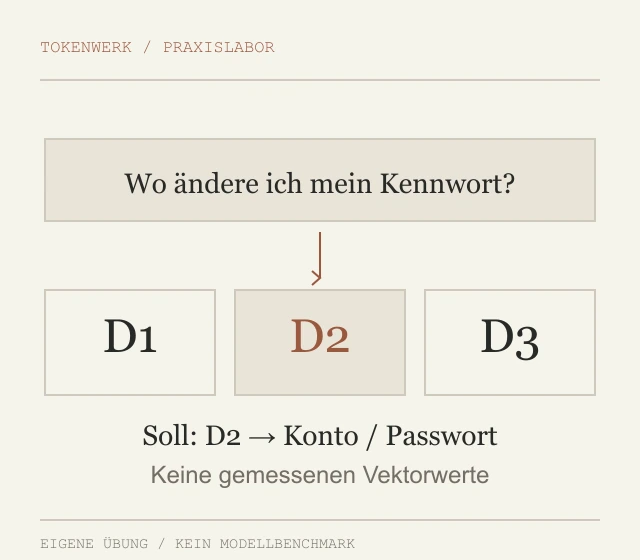
Lies die drei fiktiven Texte und lege D2 als fachlich erwarteten Treffer fest, bevor du den Code startest.
Richte deinen eigenen API-Zugang ein und prüfe, ob du diese Texte senden möchtest. Führe das Beispiel nur bewusst aus.
Vergleiche die ausgegebene Dokument-ID mit D2. Ergänze anschließend eine Frage, die keines der Dokumente beantwortet.
Der Code wird hier nur angezeigt. Ein eigener Start sendet die Beispieltexte an den Anbieter; nutze dafür deinen eigenen, bewusst freigegebenen Zugang.
# Voraussetzung: Python und das Paket openai; OPENAI_API_KEY in der Umgebung.
# Erst bei eigenem Start werden Texte an OpenAI gesendet und API-Kosten erzeugt.
import json
import math
from openai import OpenAI

texte = ["Die Monatsrechnung steht unter Abrechnung.",
         "Das Passwort lässt sich in den Kontoeinstellungen ändern.",
         "Die Lieferung kommt am nächsten Werktag."]
frage = "Wo ändere ich mein Kennwort?"
antwort = OpenAI().embeddings.create(
    model="text-embedding-3-small", input=texte + [frage])
vektoren = [x.embedding for x in sorted(antwort.data, key=lambda x: x.index)]
def cos(a, b):
    norm = math.sqrt(sum(x*x for x in a) * sum(y*y for y in b))
    if norm == 0:
        raise ValueError("Nullvektor: Ergebnis separat prüfen")
    return sum(x*y for x,y in zip(a,b)) / norm
rang = sorted(range(len(texte)), key=lambda i: cos(vektoren[i], vektoren[-1]), reverse=True)
print(json.dumps({"treffer_id": "D" + str(rang[0]+1)}, ensure_ascii=False))Vorlage herunterladenLokalen JSON-Prüfer herunterladen
{
  "treffer_id": "D2"
}Das Soll ist redaktionell aus der Vorlage abgeleitet, keine aufgezeichnete Modellantwort. Der lokale Prüfer vergleicht die festgelegten Felder und führt keinen generierten Code oder API-Aufruf aus. Er bewertet keine freien Begründungen.
Speichere Prüfer und deine Antwort im selben Ordner. Mit installiertem Python: python pruefen.py antwort.json.
| Beobachtung | Was du prüfst |
|---|---|
| Der erste Treffer wird zur sicheren Antwort | Ähnlichkeit und sachlicher Beleg werden verwechselt. |
| Vektoren verschiedener Modelle werden gemischt | Dokumente und Fragen müssen im selben passenden Vektorraum verglichen werden. |
| Ein fester Score wird als allgemeine Qualitätsgrenze verwendet | Eine sinnvolle Schwelle hängt von Korpus, Modell und deiner Fehlerbewertung ab. |
Den nächsten Schritt erklärt der Guide zu Retrieval und belegte Antworten unterscheiden und trennt Suchtreffer, Antwortentwurf und Belegkontrolle.
Mit der Lektion kannst du eine Dokumentensuche vorbereiten und vor dem Aufbau festlegen, welche Quellen und Antworten zulässig sind.
Gezielte Praxisergänzung auf Basis aktueller Herstellerunterlagen. Der Datenstand der bisherigen Modell-Faktentabellen bleibt separat ausgewiesen. Neue Beispiele und Grafiken sind eigene Erklärungen; es wurden keine Modellantworten oder Leistungswerte gemessen.
Herstellerunterlagen zur Ergänzung: text-embedding-3-small Model | OpenAI API (Abruf 2026-10-21) · Vector embeddings | OpenAI API (Abruf 2026-10-21).
Quellenstand: 2026-10-13. Spezifikationen, Tarife und Zugang können sich ändern. Die Illustration zeigt den dokumentierten Datenweg, keine gemessene Leistung.
text-embedding-3-small ist ein Embeddings-Modell von OpenAI. Eingabe: Text. Ausgabe: Embedding-Vektoren. Hersteller: OpenAI. Dokumentierte ID: text-embedding-3-small.
Eingabe: Text. Ausgabe: Embedding-Vektoren. Maßgeblich sind die Funktionen des konkreten Endpunkts in der Herstellerquelle.
Der dokumentierte Zugang lautet: Gehostete API. Öffentlich verfügbare offene Gewichte werden damit nicht bestätigt. Ein integriertes On-Device-Modell kann besondere Hardware und Plattformvorgaben haben.
0.02 USD je 1 Mio. Eingabetokens. Standardtarif für Texttokens. Bild-, Audio-, Werkzeug-, Cache- und Verarbeitungstarife werden separat berechnet. Bei selbst betriebenen Gewichten kommen Hardware- und Betriebskosten hinzu.
Nein. Das Profil dokumentiert Herstellerangaben mit Quellenstand 2026-10-13. Die Testidee ist redaktionell formuliert und wurde hier nicht ausgeführt; sie ist keine Qualitätsgarantie.
In diesem Profil ist kein allgemeines Token-Kontextlimit bestätigt. Maßgeblich sind die für diese Modellart dokumentierten Eingabegrenzen beim Hersteller. Aus einem fehlenden Wert folgt keine unbegrenzte Eingabe.
Lege eine kleine Aufgabe mit bekanntem oder nachprüfbarem Ergebnis fest. Notiere Version, Eingabe und Einstellungen. Vergleiche die Ausgabe mit deinem Prüfkriterium und halte Fehler sowie tatsächliche Kosten getrennt fest. Die Testidee auf dieser Seite ist ein Vorschlag und wurde hier nicht als Modelltest ausgeführt.
Nein. Es liefert numerische Vektoren. Das Python-Beispiel berechnet daraus nur eine Rangfolge und gibt eine Dokument-ID aus.
Nein. D2 ist der redaktionell festgelegte Solltreffer aus den fiktiven Texten. Der gezeigte Code wurde nicht gegen die kostenpflichtige API ausgeführt.
Ja. Eine Rangfolge hat weiterhin einen ersten Platz. Ob dessen Inhalt die Frage belegt, muss eine zusätzliche Prüfung entscheiden.
Embeddings
text-embedding-3-large ist ein Embeddings-Modell von OpenAI. Eingabe: Text. Ausgabe: Embedding-Vektoren.