Embeddings
text-embedding-3-small
text-embedding-3-small ist ein Embeddings-Modell von OpenAI. Eingabe: Text. Ausgabe: Embedding-Vektoren.
Technologie verstehen.
Besser entscheiden.
 Embeddings
text-embedding-3-large ist ein Embedding-Modell von OpenAI. Es stellt Eingaben als Zahlenvektoren dar. Damit kannst du Ähnlichkeiten untersuchen, etwa für eine Suche nach passenden Dokumenten.
Nutze den in den Quellen genannten Anbieterzugang für genau diese Version. Ein Produktabo enthält nicht automatisch API-Guthaben.
Aktuell im HerstellerkatalogQuellenstand 2026-10-13
OpenAI im Verzeichnis
Identität, Funktionen und Betrieb getrennt lesen. Die Angaben beziehen sich auf diese konkrete Version.
„Nicht bestätigt“ kennzeichnet eine offene Angabe. Es bedeutet weder „nicht vorhanden“ noch „unbegrenzt“.
| Hersteller | OpenAI |
|---|---|
| Modellfamilie | GPT |
| Modell-/API-ID | text-embedding-3-large |
| Status | Aktuell im Herstellerkatalog |
| Modellart | Embeddings |
|---|---|
| Eingabe | Text |
| Ausgabe | Embedding-Vektoren |
| Kontext | Nicht bestätigt |
|---|---|
| Maximaler Output / Horizont | Nicht bestätigt |
| Bereitstellung | Gehostete API |
|---|---|
| Gewichte | Gehosteter oder integrierter Zugang |
| Lizenz | Anbieterbedingungen |
Die Grafik zeigt die ausgewiesenen Eingabe- und Ausgabearten. Sie beschreibt einen Arbeitsweg und enthält keine erfundenen Messwerte oder Leistungswerte.
Datenbasis: Herstellerangaben im Quellenstand 2026-10-13. Quellen zu diesem Profil ↓

text-embedding-3-large ist ein Embeddings-Modell von OpenAI. Eingabe: Text. Ausgabe: Embedding-Vektoren.
Embeddings sind Vektoren für Ähnlichkeit und Retrieval. Nutze dieselben Dokumente und Suchfragen, halte Dimension und Vorverarbeitung fest und bewerte relevante Treffer. Die Grundlagen zu Vektordatenbanken erklären, wie solche Repräsentationen bei der Suche verwendet und passende Treffer geprüft werden.
Prüfe vor einem API-Aufruf, ob dein Konto Zugriff hat und welchen Endpunkt, Tarif und welche Region du verwenden musst. Notiere die genaue Modellversion. Ein Kurzname in der API kann später auf einen anderen Modellstand verweisen.
Leistung: Wir haben die Leistung dieses Modells hier nicht selbst gemessen. Nutze die Aufgabe unten, um es an deinen Anforderungen zu prüfen.
Standardtarif für Texttokens. Bild-, Audio-, Werkzeug-, Cache- und Verarbeitungstarife werden separat berechnet.
Zugang: Gehostete API. Prüfe vor einer Integration die für dein Konto und deine Region verfügbaren Endpunkte. Ein Eintrag im öffentlichen Katalog ist keine Bestätigung eines freigeschalteten Kontos.
Praxisergänzung geprüft am 22. Oktober 2026 · eigene Aufgabe, kein Modellbenchmark
Ein Suchsystem kann nach einem Modellwechsel plausible, aber unbrauchbare Treffer liefern. Vor der Ähnlichkeitsrechnung müssen Anfrage und gespeicherte Dokumente zusammenpassen. Die Übung arbeitet nur mit fiktiven Metadaten; sie erzeugt keine Vektoren. Du prüfst, welche Einträge im gewählten Bestand vergleichbar sind und wo ein Neuaufbau oder eine Klärung nötig ist.
OpenAI beschreibt Embeddings als numerische Textrepräsentationen. Für text-embedding-3-large nennt der Guide standardmäßig 3072 Dimensionen; eine explizite dimensions-Einstellung ist davon zu unterscheiden. Für unseren künstlichen Bestand werden genau diese Modell-ID und diese Ausgabelänge festgelegt. Ein reiner Längenvergleich reicht nicht: Vektoren eines anderen Modells gehören nicht automatisch in denselben Raum.
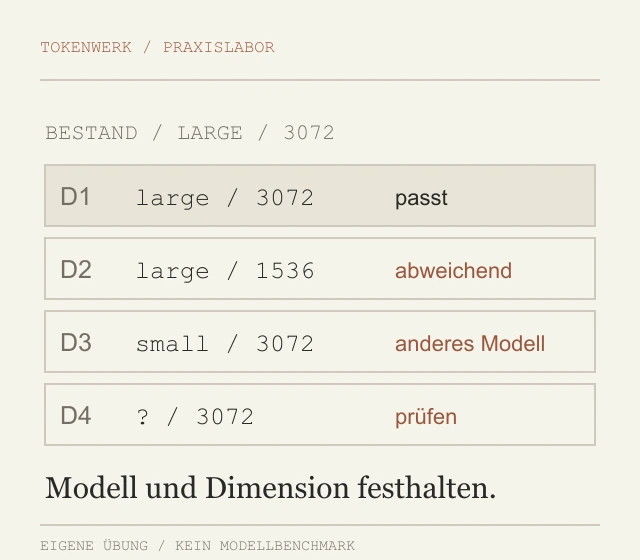
Halte Modellversion, gewählten Zugang und Einstellungen fest. Nutze nur die fiktiven Angaben dieser Vorlage.
Bearbeite die Aufgabe und speichere den geforderten JSON-Teil unverändert als antwort.json. Bei einer freien Antwort erstellst du den Prüfteil selbst und kennzeichnest das.
Vergleiche mit dem Soll und prüfe mindestens einen veränderten Eingabefall. Ein bestandener Beispielsatz ersetzt keine Abnahme auf deinen eigenen Daten.
Die Angaben sind fiktiv. Speichere den geforderten JSON-Teil der Antwort separat als antwort.json; zusätzliche Erklärungen gehören in eine andere Datei.
Metadatenprüfung, keine API-Anfrage: Die Suchanfrage verwendet text-embedding-3-large mit 3072 Dimensionen. Unser Bestand soll genau damit erzeugt sein.
D1: Modell text-embedding-3-large, Dimension 3072
D2: Modell text-embedding-3-large, Dimension 1536
D3: Modell text-embedding-3-small, Dimension 3072
D4: Modell unbekannt, Dimension 3072
JSON: vergleichbar (sortierte IDs), neu_einbetten (bekannt abweichende Konfiguration), metadaten_pruefen (unbekanntes Modell). Keine Ähnlichkeitsscores erfinden.Vorlage herunterladenLokalen JSON-Prüfer herunterladen
{
  "vergleichbar": [
    "D1"
  ],
  "neu_einbetten": [
    "D2",
    "D3"
  ],
  "metadaten_pruefen": [
    "D4"
  ]
}Das Soll ist redaktionell aus der Vorlage abgeleitet, keine aufgezeichnete Modellantwort. Der lokale Prüfer vergleicht die festgelegten Felder und führt keinen generierten Code oder API-Aufruf aus. Er bewertet keine freien Begründungen.
Speichere Prüfer und deine Antwort im selben Ordner. Mit installiertem Python: python pruefen.py antwort.json.
| Beobachtung | Was du prüfst |
|---|---|
| D3 wird wegen gleicher Länge übernommen | Gleiche Dimension beweist keine Modell- oder Vektorraumgleichheit. |
| D2 wird durch Abschneiden anderer Vektoren passend gemacht | Ein ungeprüfter Umbau ist kein Ersatz für einen konsistenten Embedding-Prozess. |
| D4 gilt automatisch als large | Bewahre Herkunft und Konfiguration beim Erzeugen und Speichern auf. |
Den Unterschied zwischen Dokumentvektor und formuliertem Antworttext erklärt auch Embedding und Antwortmodell getrennt betreiben. Der Guide beschreibt einen anderen, lokalen Betriebsweg.
Wie du Modellwahl und Dokumentherkunft im Workflow kontrollierst, zeigt der Guide zu einen RAG-Datenweg in n8n prüfen.
Gezielte Praxisergänzung auf Basis aktueller Herstellerunterlagen. Der Datenstand der bisherigen Modell-Faktentabellen bleibt separat ausgewiesen. Neue Beispiele und Grafiken sind eigene Erklärungen; es wurden keine Modellantworten oder Leistungswerte gemessen.
Herstellerunterlagen zur Ergänzung: text-embedding-3-large Model | OpenAI API (Abruf 2026-10-22) · Vector embeddings | OpenAI API (Abruf 2026-10-22).
Quellenstand: 2026-10-13. Spezifikationen, Tarife und Zugang können sich ändern. Die Illustration zeigt den dokumentierten Datenweg, keine gemessene Leistung.
text-embedding-3-large ist ein Embeddings-Modell von OpenAI. Eingabe: Text. Ausgabe: Embedding-Vektoren. Hersteller: OpenAI. Dokumentierte ID: text-embedding-3-large.
Eingabe: Text. Ausgabe: Embedding-Vektoren. Maßgeblich sind die Funktionen des konkreten Endpunkts in der Herstellerquelle.
Der dokumentierte Zugang lautet: Gehostete API. Öffentlich verfügbare offene Gewichte werden damit nicht bestätigt. Ein integriertes On-Device-Modell kann besondere Hardware und Plattformvorgaben haben.
0.13 USD je 1 Mio. Eingabetokens. Standardtarif für Texttokens. Bild-, Audio-, Werkzeug-, Cache- und Verarbeitungstarife werden separat berechnet. Bei selbst betriebenen Gewichten kommen Hardware- und Betriebskosten hinzu.
Nein. Das Profil dokumentiert Herstellerangaben mit Quellenstand 2026-10-13. Die Testidee ist redaktionell formuliert und wurde hier nicht ausgeführt; sie ist keine Qualitätsgarantie.
In diesem Profil ist kein allgemeines Token-Kontextlimit bestätigt. Maßgeblich sind die für diese Modellart dokumentierten Eingabegrenzen beim Hersteller. Aus einem fehlenden Wert folgt keine unbegrenzte Eingabe.
Lege eine kleine Aufgabe mit bekanntem oder nachprüfbarem Ergebnis fest. Notiere Version, Eingabe und Einstellungen. Vergleiche die Ausgabe mit deinem Prüfkriterium und halte Fehler sowie tatsächliche Kosten getrennt fest. Die Testidee auf dieser Seite ist ein Vorschlag und wurde hier nicht als Modelltest ausgeführt.
Der Guide nennt 3072 als Standard. Eine bewusst gesetzte dimensions-Option kann die Länge ändern. Die Übung legt absichtlich eine einzige Konfiguration fest.
Nein. Es sind fiktive Bestandsmetadaten, keine gemessenen Vektoren oder Suchergebnisse.
Prüfe den gesamten Bestand und seine Konfiguration. Dokumente und Anfragen müssen zum selben vorgesehenen Embedding-Verfahren passen; ein neuer Modellname allein migriert gespeicherte Vektoren nicht.
Embeddings
text-embedding-3-small ist ein Embeddings-Modell von OpenAI. Eingabe: Text. Ausgabe: Embedding-Vektoren.