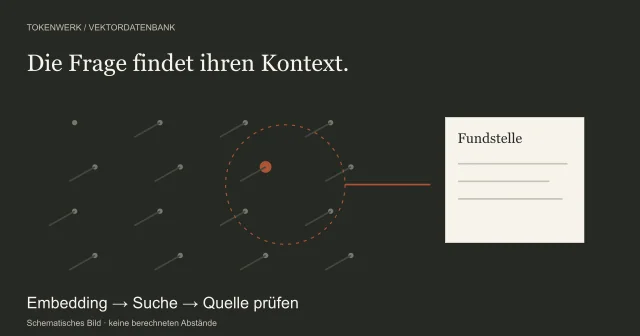
Verwende dasselbe Embeddingmodell für Quellen und Frage. Prüfe die abgerufenen Passagen, bevor du der Antwort vertraust. Der gezeigte Code nutzt nur fiktive Texte und den lokalen Ollama-Endpunkt; er ist eine Lernprobe und kein fertiges Wissenssystem.
Was RAG mit Ollama ergänzt
RAG bedeutet hier: Vor dem Antworten werden zur Frage passende Textstellen ausgewählt. Diese Stellen gehen zusammen mit der Frage an das Antwortmodell. Die Modellgewichte werden dadurch nicht verändert und die Quelle wird nicht automatisch zu dauerhaftem Modellwissen. Die RAG-Grundlagen erklären, welche Aufgaben zusätzlich zur Modelllaufzeit durch Quellenaufbereitung und Suche entstehen.
Ollama stellt in der Probe zwei Modelle über seine lokale API bereit. Das Embeddingmodell erzeugt Zahlenvektoren. Das Chatmodell erzeugt Sprache. Unser kleines Python-Programm übernimmt Auswahl und Übergabe der Textstellen.
Eine Vektordatenbank ist für diese drei fiktiven Absätze nicht nötig; die Vektoren bleiben nur während des Laufs im Arbeitsspeicher. Das macht den Weg sichtbar. Ein größerer Bestand braucht andere Überlegungen zu Speicherung, Aktualisierung und Zugriffen.

Zwei passende lokale Modelle vorbereiten
Du brauchst einen laufenden lokalen Ollama-Server und Python 3.11 oder neuer. Das Programm verwendet ausschließlich die Python-Standardbibliothek. Installiere dafür keine fremden RAG-Pakete auf Verdacht.
Auf dem Modellrechner · gewählte lokale Modelle
ollama pull embeddinggemma:300m
ollama pull gemma4:e2bDie Ollama-Modellkarte verlangt für EmbeddingGemma mindestens Version 0.11.10. Das Modell erzeugt Embeddings und ersetzt kein Chatmodell. gemma4:e2b stammt als lokaler Einstieg aus dem aktuellen Ollama-Quickstart; es ist hier ein gewähltes Beispiel, keine pauschale Empfehlung für jede Hardware oder Dokumentenaufgabe.
Prüfe Speicher, Laufzeit und Modellgröße vor dem Download. Den Rechner für lokale KI prüfen erklärt den Abgleich. Wenn Modelle nacheinander geladen werden müssen, kann das die Wartezeit beeinflussen. Dieser Artikel enthält keine eigene Laufzeit- oder Qualitätsmessung.
Der Code verbindet sich ausschließlich direkt mit 127.0.0.1:11434. Ollama muss daher im selben erreichbaren Betriebssystemkontext laufen. Ein entfernter Modellserver, Containergrenzen oder andere Ports benötigen einen bewusst angepassten Aufbau.
Ollama-Embeddings mit der aktuellen API erzeugen
Die aktuelle Schnittstelle lautet POST /api/embed. Über input kannst du einen Text oder mehrere Texte übergeben. Die Antwort enthält embeddings als Liste von Vektoren, auch bei einer einzelnen Frage.
Eigener beispielhafter Request-Body
{
  "model": "embeddinggemma:300m",
  "input": ["Fiktive Quelle A", "Fiktive Quelle B"],
  "truncate": false
}truncate: false macht einen zu langen Input zum Fehler, statt ihn still kürzen zu lassen. Wie viele Zahlen ein Vektor enthält, hängt vom Modell ab. Trage deshalb keine angeblich universellen 768 Dimensionen in deinen Code ein.
Dokumente und Frage müssen mit demselben gewählten Embeddingmodell und einer zueinander passenden Konfiguration verarbeitet werden. Ein Cache aus einem anderen Modell ist kein gleichwertiger Suchbestand. Embeddings und Vektorsuche einordnen erklärt diese Beziehung ausführlicher.
Unser Programm kontrolliert Zahl, Dimension und endliche Zahlenwerte der Vektoren. Danach berechnet es eine Cosine-Ähnlichkeit. Der Wert dient zum Sortieren, nicht als Wahrscheinlichkeit, dass eine Antwort wahr ist.
Eine kleine lokale RAG-Probe ausführen
Lade das vollständige eigene Python-Beispiel als Textdatei herunter und speichere es bewusst als ollama-rag-beispiel.py. Prüfe die Dateiendung; eine weiterhin vorhandene .txt-Endung ist nicht derselbe Dateiname.
Die Datei enthält drei kurze erfundene Atlas-Quellen mit IDs. Sie liest keine privaten Ordner und startet keinen öffentlichen Webserver. Die Auswahl wird bei jedem Lauf neu im Arbeitsspeicher aufgebaut.
- Der Code sendet die drei Texte an das lokale Embeddingmodell.
- Die Frage wird mit demselben Modell in einen Vektor übersetzt.
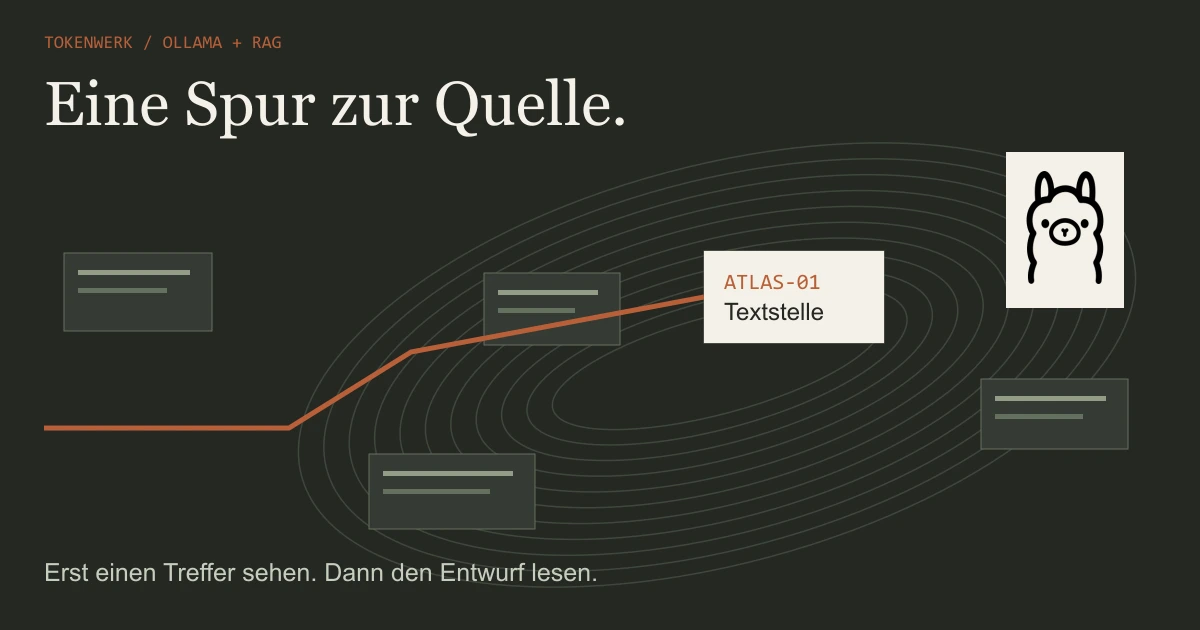
- Die zwei am ähnlichsten bewerteten Quellen werden ausgewählt und mit ihrer ID angezeigt.
- Nur diese Ausschnitte und die Frage gehen an das gewählte lokale Chatmodell.
- Das Programm druckt einen ausdrücklich ungeprüften Antwortentwurf.
Eigene erste Quellenfrage · im Ordner der Datei
python ollama-rag-beispiel.py "Wie erhält das fiktive Testgerät Atlas Strom?"Unter Systemen mit dem Befehlsnamen python3 verwendest du diesen statt python. Bei einer fehlenden Verbindung prüfst du zunächst Ollama und die Umgebung; bei einem unbekannten Modell den exakten Modellnamen.
Die Schnittstellenfolge und die eigene Programmlogik werden separat mit simulierten API-Antworten geprüft. Für diesen Artikel wurde kein tatsächlicher Ollama-Embedding- oder Modellaufruf ausgeführt. Eine von dir erzeugte Ausgabe ist deshalb erst nach dem folgenden Quellencheck ein Abnahmebeleg.
Treffer und Antwort getrennt abnehmen
Lies zuerst die vom Programm ausgegebenen Quellen, nicht nur den flüssigen Antworttext. Für die Stromfrage muss die ausgewählte Passage ATLAS-01 den USB-C-Hinweis tragen. Prüfe anschließend, ob der Entwurf genau diese Angabe wiedergibt und die passende ID nennt.
Eigene Negativfrage
python ollama-rag-beispiel.py "Welche Batteriekapazität hat das fiktive Testgerät Atlas?"Die Quellen enthalten keine Batteriezahl. Der Entwurf soll diese Lücke als „nicht angegeben“ behandeln. Auch die ähnlichste Passage kann eine Frage nicht beantworten. Ein Treffer wird durch den höchsten Score nicht automatisch zu einem hinreichenden Beleg.
| Beobachtung | Was du daraus prüfst |
|---|---|
| Die richtige Quelle fehlt | Retrieval, Modellwahl oder Textaufteilung zuerst untersuchen. |
| Quelle passt, Antwort ergänzt Werte | Inhaltlicher Fehler des Entwurfs; nicht durch einen guten Suchscore entschuldigt. |
| Frage ist nicht beantwortbar | Keine Zahl ergänzen; fehlende Angabe offenhalten. |
| Quellen-ID klingt passend | Originalpassage trotzdem vollständig vergleichen. |
Wiederhole beide Fragen nach Modell- oder Quellenänderungen. Halte Modellnamen und Programmstand zusammen fest. Es gibt hier keine feste universelle Scoregrenze, die richtige Antworten garantiert.
Was vor einem echten Wissenssystem fehlt
Die Lernprobe hat keinen dauerhaften Index, keine Nutzerverwaltung, keine Dokumentenrechte und keine Löschroutine für einen realen Bestand. Für einen produktiven Dienst müsstest du diese Aufgaben zusätzlich planen und prüfen. Zugriffsschutz im Nachhinein nur an den Antworttext zu hängen reicht dafür nicht.
Quelltexte bleiben Daten. Prompt Injection in Dokumenten erkennen zeigt, warum eingelesene Anweisungen keine neuen Berechtigungen schaffen dürfen. Unser Beispiel besitzt keine Modelltools und führt aus einer Antwort keinen Shellbefehl aus; ein später ergänzter Agent hätte einen anderen Risikoumfang.
Prüfe außerdem den vollständigen Datenweg einschließlich weiterer Oberflächen und optionaler Dienste. Der hier festgelegte lokale HTTP-Zugang ist eine konkrete Eigenschaft dieses Programms, keine pauschale Datenschutzgarantie für jedes Ollama-/RAG-Setup. Für eine zusätzliche Dokumentenoberfläche kannst du AnythingLLM mit eigenen Dokumenten einrichten; den dort gewählten Modell- und Datenweg prüfst du separat.
Quellen & Methode
Vorgehen und Grenzen
Aktuelle Originaldokumentation am 20. Oktober2026 vollständig im dokumentierten Umfang geprüft. Historische Haupttexte dienen der symmetrischen Intentanalyse. Testquelle, RAG-Programm, Vergleichsblatt, Konfigurationsfragment und Grafiken sind eigene Beispiele. Keine echte Claude-/Ollama-/n8n-/Make-Nutzung, Modellmessung oder Änderung laufender Dienste behauptet.
Bei Recherche, Texterstellung und Grafiken wird KI eingesetzt. Welche eigenen Versuche vorliegen und was nur als Beispiel dient, beschreibt dieser Beitrag. Unser Redaktionsstandard erklärt die Anforderungen an Belege und Berichtigungen.