Text & Reasoning
Nemotron 3.5 Lightning 30B-A3B
Offenes Hybrid-MoE-Modell von NVIDIA. 30B Gesamtparameter, 3B aktiv; auf einem H100 nennt die Referenzkonfiguration 256K Kontext.
Technologie verstehen.
Besser entscheiden.
 Text & Reasoning
Nemotron 3 Super 120B-A12B ist ein Sprachmodell von NVIDIA. Offenes Hybrid-MoE-Modell von NVIDIA. 120B Gesamtparameter, 12B aktiv.
Wenn du lokal arbeiten möchtest, prüfe zuerst Lizenz, passende Laufzeit und den Speicherbedarf deiner Modellvariante. Offene Gewichte allein sagen noch nicht, ob dein Rechner dafür ausreicht.
Aktuell im HerstellerkatalogQuellenstand 2026-10-13
NVIDIA im Verzeichnis
Identität, Funktionen und Betrieb getrennt lesen. Die Angaben beziehen sich auf diese konkrete Version.
„Nicht bestätigt“ kennzeichnet eine offene Angabe. Es bedeutet weder „nicht vorhanden“ noch „unbegrenzt“.
| Hersteller | NVIDIA |
|---|---|
| Modellfamilie | Nemotron |
| Modell-/API-ID | nvidia/NVIDIA-Nemotron-3-Super-120B-A12B-BF16 |
| Status | Aktuell im Herstellerkatalog |
| Modellart | Text & Reasoning |
|---|---|
| Eingabe | Text |
| Ausgabe | Text |
| Kontext | 1.048.576 Tokens |
|---|---|
| Maximaler Output / Horizont | Nicht bestätigt |
| Bereitstellung | Offene Gewichte; selbst betreiben |
|---|---|
| Gewichte | Offene Gewichte dokumentiert |
| Lizenz | NVIDIA Nemotron Open Model License |
Die Grafik zeigt die im Profil dokumentierten Grenzen. Kontext und maximale Ausgabe sind keine addierbaren Budgets und keine Qualitätsbewertung. Zusätzliche Bedingungen stehen im Datenblatt.
Datenbasis: Herstellerangaben im Quellenstand 2026-10-13. Quellen zu diesem Profil ↓

Wähle eine kleine Aufgabe mit einer überprüfbaren Lösung: etwa fünf Informationen aus einem gegebenen Dokument extrahieren. Prüfe die Antworten am Original, nicht nur die Formulierung.
Vor einem lokalen Test zuerst Gewichteformat, Lizenz, Arbeitsspeicher und unterstützte Runtime prüfen. Notiere die genaue Modellversion. Ein Kurzname in der API kann später auf einen anderen Modellstand verweisen. Der Auswahlguide für lokale KI-Modelle vertieft die Prüfung von Aufgabe, Gewichteformat, Speicher und Lizenz vor einem eigenen Versuch.
Lokaler Betrieb: Verfügbare Gewichte allein belegen nicht, dass dieses Modell auf deinem Rechner läuft. Speicherbedarf, Quantisierung, Kontext und unterstützte Hardware müssen zusammenpassen.
Leistung: Wir haben die Leistung dieses Modells hier nicht selbst gemessen. Nutze die Aufgabe unten, um es an deinen Anforderungen zu prüfen.
Tarife und Zugang vor Nutzung in der Anbieterquelle prüfen.
Zugang: Offene Gewichte; selbst betreiben. Prüfe vor einer Integration die für dein Konto und deine Region verfügbaren Endpunkte. Ein Eintrag im öffentlichen Katalog ist keine Bestätigung eines freigeschalteten Kontos.
Praxisergänzung geprüft am 22. Oktober 2026 · eigene Aufgabe, kein Modellbenchmark
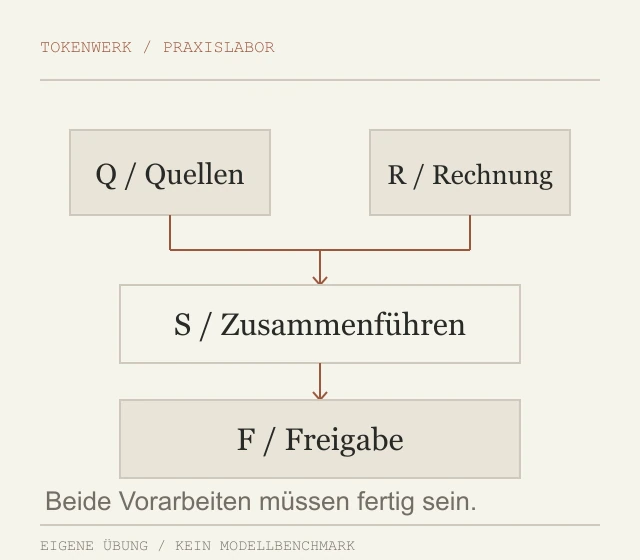
Ein fiktiver Ablauf hat zwei voneinander unabhängige Vorarbeiten. Die Zusammenführung darf erst nach beiden erfolgen; eine anschließende Freigabe bleibt erforderlich. Prüfe drei Ablaufpläne gegen genau diese Regeln. Es werden keine Agenten gestartet und keine Aktionen ausgeführt.
NVIDIA dokumentiert Nemotron-3-Super-120B-A12B-BF16 als Modell für Reasoning und agentische Anwendungen. Die Größe aktiver Teilbereiche ist vom gesamten Modell zu unterscheiden. Für diese reine Textprobe genügt ein bereits eingerichteter, zulässiger Zugang. Halte Revision, Template und Denkmodus fest; der bestandene Planungsfall wäre keine Messung paralleler Ausführung oder tatsächlicher Agentenrechte.
Halte Modellversion, gewählten Zugang und Einstellungen fest. Nutze nur die fiktiven Angaben dieser Vorlage.
Bearbeite die Aufgabe und speichere den geforderten JSON-Teil unverändert als antwort.json. Bei einer freien Antwort erstellst du den Prüfteil selbst und kennzeichnest das.
Vergleiche mit dem Soll und prüfe mindestens einen veränderten Eingabefall. Ein bestandener Beispielsatz ersetzt keine Abnahme auf deinen eigenen Daten.
Die Angaben sind fiktiv. Speichere den geforderten JSON-Teil der Antwort separat als antwort.json; zusätzliche Erklärungen gehören in eine andere Datei.
Fiktive Regeln: Q=Quellen sichten und R=Rechnung prüfen dürfen unabhängig erfolgen. S=Zusammenführen darf erst nach Q und R erfolgen. F=Freigabe ist nach S erforderlich. Plane nichts außerhalb dieser Regeln. A: Q,R,S,F. B: Q,S,R,F. C: Q,R,S. JSON: regelkonform, zusammenfuehrung_zu_frueh, freigabe_fehlt (je sortierte Plan-IDs).Vorlage herunterladenLokalen JSON-Prüfer herunterladen
{
  "regelkonform": [
    "A"
  ],
  "zusammenfuehrung_zu_frueh": [
    "B"
  ],
  "freigabe_fehlt": [
    "C"
  ]
}Das Soll ist redaktionell aus der Vorlage abgeleitet, keine aufgezeichnete Modellantwort. Der lokale Prüfer vergleicht die festgelegten Felder und führt keinen generierten Code oder API-Aufruf aus. Er bewertet keine freien Begründungen.
Speichere Prüfer und deine Antwort im selben Ordner. Mit installiertem Python: python pruefen.py antwort.json.
| Beobachtung | Was du prüfst |
|---|---|
| B wird akzeptiert | Prüfe beide Vorbedingungen, nicht nur Q. |
| C gilt als fertig | Eine abgeschlossene Zusammenführung ersetzt die geforderte Freigabe nicht. |
| Das Modell startet Teilaufgaben selbst | Die Probe verlangt nur Planprüfung, keine Werkzeugausführung. |
Wie aus einer Planregel ein kontrollierter Arbeitsschritt wird, zeigt Freigaben vor der tatsächlichen Aktion einbauen.
Für eine konkrete Umsetzung hilft dir n8n-Workflows mit überprüfbaren Zwischenschritten aufbauen, bevor du weitere Dienste verbindest.
Gezielte Praxisergänzung auf Basis aktueller Herstellerunterlagen. Der Datenstand der bisherigen Modell-Faktentabellen bleibt separat ausgewiesen. Neue Beispiele und Grafiken sind eigene Erklärungen; es wurden keine Modellantworten oder Leistungswerte gemessen.
Herstellerunterlagen zur Ergänzung: NVIDIA-Nemotron-3-Super-120B-A12B-BF16 (Abruf 2026-10-22) · https://huggingface.co/nvidia/NVIDIA-Nemotron-3-Super-120B-A12B-BF16/raw/main/config.json (Abruf 2026-10-22).
Quellenstand: 2026-10-13. Spezifikationen, Tarife und Zugang können sich ändern. Die Illustration zeigt den dokumentierten Datenweg, keine gemessene Leistung.
Offenes Hybrid-MoE-Modell von NVIDIA. 120B Gesamtparameter, 12B aktiv. Hersteller: NVIDIA. Dokumentierte ID: nvidia/NVIDIA-Nemotron-3-Super-120B-A12B-BF16.
Eingabe: Text. Ausgabe: Text. Maßgeblich sind die Funktionen des konkreten Endpunkts in der Herstellerquelle.
Offene Gewichte sind dokumentiert. Die Lizenz NVIDIA Nemotron Open Model License, unterstützte Runtime und benötigte Hardware musst du zusätzlich prüfen.
Kein bestätigter Einheitspreis im geprüften Quellenstand. Tarife und Zugang vor Nutzung in der Anbieterquelle prüfen. Bei selbst betriebenen Gewichten kommen Hardware- und Betriebskosten hinzu.
Nein. Das Profil dokumentiert Herstellerangaben mit Quellenstand 2026-10-13. Die Testidee ist redaktionell formuliert und wurde hier nicht ausgeführt; sie ist keine Qualitätsgarantie.
Im dokumentierten Quellenstand: 1.048.576 Tokens. Bis 1M Tokens laut Modellkarte; tatsächlich nutzbarer Kontext hängt von Hardware, Präzision und Runtime ab. Kontext ist keine Wortzahl und kein Nachweis, dass jede enthaltene Information zuverlässig verarbeitet wird.
Lege eine kleine Aufgabe mit bekanntem oder nachprüfbarem Ergebnis fest. Notiere Version, Eingabe und Einstellungen. Vergleiche die Ausgabe mit deinem Prüfkriterium und halte Fehler sowie tatsächliche Kosten getrennt fest. Die Testidee auf dieser Seite ist ein Vorschlag und wurde hier nicht als Modelltest ausgeführt.
Nein. Sie prüft fiktive Reihenfolgen in einem Text. Es findet weder parallele Ausführung noch ein Zugriff auf Werkzeuge statt.
Die Vorlage erlaubt unabhängige Vorarbeiten. Der konkrete Plan A beschreibt trotzdem nur eine zulässige Reihenfolge; es wird keine reale Parallelität gemessen.
Nein. Ein echtes System muss Voraussetzungen und Freigaben technisch durchsetzen. Die Modellantwort allein autorisiert keine Aktion.
Text & Reasoning
Offenes Hybrid-MoE-Modell von NVIDIA. 30B Gesamtparameter, 3B aktiv; auf einem H100 nennt die Referenzkonfiguration 256K Kontext.
Text & Reasoning
Offenes Hybrid-MoE-Modell von NVIDIA. 30B Gesamtparameter, 3B aktiv.
Text & Reasoning
Offenes Hybrid-MoE-Modell von NVIDIA. 550B Gesamtparameter, 55B aktiv.