KI & Modelle / Guide
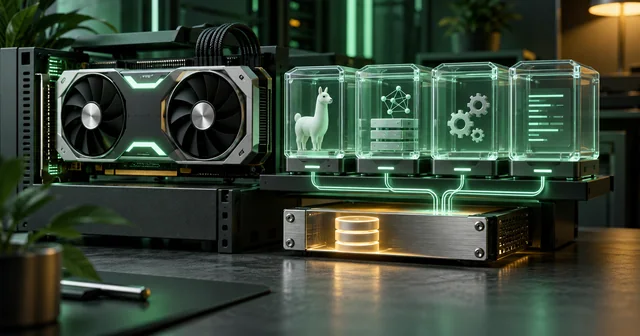
Ollama mit Docker: Installation, Speicher und GPU
Ollama mit Docker Compose einrichten: Modelle dauerhaft speichern, Portzugriff begrenzen und CPU- oder GPU-Betrieb prüfen. Mit Konfiguration und Fehlersuche.
Technologie verstehen.
Besser entscheiden.
Praxisprojekt
Ein lokales Modell mit reproduzierbarer Konfiguration starten und Grenzen des Datenflusses prüfen.
Ein lokales Modell mit reproduzierbarer Konfiguration starten und Grenzen des Datenflusses prüfen.
Rechner mit unterstützter Laufzeit; mindestens 10 GB freier Speicher als Download-Puffer. Der tatsächliche Arbeitsspeicher hängt von Modell, Quantisierung, Kontext und Runtime ab.
Keine API-Kosten, wenn vollständig lokal; Strom, Speicher und ggf. zusätzliche Hardware sind eigene Kosten.
Ein anderer Nutzer kann Modell-ID, Quantisierung, Laufzeit, Testeingaben und beobachtete Grenzen nachvollziehen.
Weiter mit dem passenden Lernpfad, den Modellprofilen und dem Glossar.
Vom Nachlesen zum Anwenden
Praxis im Magazin
Ollama mit Docker Compose einrichten: Modelle dauerhaft speichern, Portzugriff begrenzen und CPU- oder GPU-Betrieb prüfen. Mit Konfiguration und Fehlersuche.
Ollama auf Port 11434 prüfen, Portkonflikte zuordnen und OLLAMA_HOST ändern. Mit Beispielen für Windows, macOS, Linux und getrennten Container-Adressen.
Ein lokales Modell mit reproduzierbarer Konfiguration starten und Grenzen des Datenflusses prüfen.
Rechner mit unterstützter Laufzeit; mindestens 10 GB freier Speicher als Download-Puffer. Der tatsächliche Arbeitsspeicher hängt von Modell, Quantisierung, Kontext und Runtime ab.
Keine API-Kosten, wenn vollständig lokal; Strom, Speicher und ggf. zusätzliche Hardware sind eigene Kosten.
Ein anderer Nutzer kann Modell-ID, Quantisierung, Laufzeit, Testeingaben und beobachtete Grenzen nachvollziehen.
Die Seite führt dich durch 5 dokumentierte Schritte. Prüfe jeden Schritt, bevor du mit dem nächsten fortfährst.