Text & Reasoning
GPT-6.1 Sol
Für Programmierung und professionelle Aufgaben; Tool-Aufrufe sind in der Responses API dokumentiert.
Technologie verstehen.
Besser entscheiden.
 Text & Reasoning
GPT-6 Sol ist ein weiterhin dokumentierter OpenAI-Zugang für Code- und Werkzeugaufgaben. Die Modellseite verweist inzwischen auf GPT-6.1 Sol als neuere Variante. Hier werden der bestehende Zugang, seine Einstellungen und die Unterschiede beim Umstieg getrennt erklärt.
Nutze den in den Quellen genannten Anbieterzugang für genau diese Version. Ein Produktabo enthält nicht automatisch API-Guthaben.
Aktuell im HerstellerkatalogQuellenstand 2026-10-13
OpenAI im Verzeichnis
Nachprüfung am 24. Oktober 2026; Herstellerdokumentation, kein eigener Modelltest.
OpenAI hat am 20. Oktober eine12-Stunden-Cacheoption in der Responses API ergänzt; deren Schreibkosten betragen laut Changelog 2,5 mal den Inputtarif. Am 22. Oktober wurde die Decisions API mit GPT-6 Luna allgemein verfügbar und unterstützt bis 400 Fragen je Request. Diese Funktion wird nicht anderen Modellen als unterstützt zugeschrieben. Der Datenstand der übrigen Modellfelder steht weiterhin separat im Profil.
Herstellerquelle zum Update · geprüft am 24. Oktober 2026
Identität, Funktionen und Betrieb getrennt lesen. Die Angaben beziehen sich auf diese konkrete Version.
„Nicht bestätigt“ kennzeichnet eine offene Angabe. Es bedeutet weder „nicht vorhanden“ noch „unbegrenzt“.
| Hersteller | OpenAI |
|---|---|
| Modellfamilie | GPT |
| Modell-/API-ID | gpt-6-sol |
| Status | Aktuell im Herstellerkatalog |
| Modellart | Text & Reasoning |
|---|---|
| Eingabe | Text, Bild |
| Ausgabe | Text |
| Kontext | 1.050.000 Tokens |
|---|---|
| Maximaler Output / Horizont | 128.000 Tokens |
| Bereitstellung | Gehostete API |
|---|---|
| Gewichte | Gehosteter oder integrierter Zugang |
| Lizenz | Anbieterbedingungen |
Input und Output sind getrennte Texttarife je einer Million Tokens. Preisstufen, Cache, Werkzeuge und weitere Bedingungen stehen im Kostenabschnitt. Kein Preis für eine konkrete Aufgabe.
Datenbasis: Herstellerangaben im Quellenstand 2026-10-13. Quellen zu diesem Profil ↓

Die konkrete API-ID ist gpt-6-sol. Sie ist von gpt-6.1-sol zu unterscheiden: Ein ähnlicher Name bestätigt keine identischen Einstellungen. Die aktuelle Sol-Modellseite nennt die neuere Variante, dokumentiert aber weiterhin die Funktionen und Tarife dieses Zugangs. Das Profil ist deshalb eine Einordnung für vorhandene Integrationen, keine Behauptung, Sol sei die neueste Version. Das Vergleichsblatt für KI-Tools hilft dir, Ergebnis, Datenweg und erforderliche Nacharbeit für dieselbe Aufgabe festzuhalten.
GPT-6 Sol unterstützt none, low, medium, high, xhigh und max als Reasoning-Effort, mit medium als Voreinstellung. Function Calling in Chat Completions ist nur bei none unterstützt; Responses ist für Reasoning mit Werkzeugen vorgesehen. Beim neueren GPT-6.1 Sol ist none nicht unterstützt, und Werkzeugaufrufe benötigen Responses.
Beide Sol-Varianten haben normale Standardpreise von 2/10 USD je Million Eingabe-/Ausgabetokens. Der dokumentierte Cache-Lesepreis beträgt hier 0,20 USD, beim neueren Sol 0,10 USD. Diese einzelne Tarifdifferenz entscheidet nicht allein über die Kosten eines ganzen Arbeitsablaufs: Anfragen, Ausgaben und verwendete Werkzeuge müssen ebenfalls berücksichtigt werden.
Text und Bilder können eingegeben werden, Text wird ausgegeben. Das gesamte Kontextfenster beträgt 1.050.000 Tokens, maximale Eingabe 922.000 und maximaler Output 128.000 Tokens. Eine kleine, gleichbleibende Prüffrage hilft, einen Versionswechsel von einer gleichzeitig geänderten Aufgabenstellung zu unterscheiden.
Standardpreise je Million Tokens: 2 USD normale Eingabe, 0,20 USD Cache-Lesen, 2,50 USD Cache-Schreiben und 10 USD Ausgabe. Über 272.000 Eingabetokens gelten für die gesamte Anfrage doppelte Eingabe-/Cachepreise und der 1,5-fache Ausgabetarif. Andere Verarbeitungsarten haben eigene Tarife.
Fiktive Rechnung: 10.000 normale Eingabetokens plus 2.000 Ausgabetokens ergeben im kurzen Standardtarif 0,04 USD. Das Beispiel enthält keinen Cache-Treffer, deshalb führt der unterschiedliche Cache-Lesepreis der beiden Sol-Varianten hier zu keiner Ersparnis. Werkzeug-, Bild- und weitere Zusatzkosten sowie Steuern sind nicht enthalten.
Zugang: Gehostete API. Eine öffentlich dokumentierte Modell-ID bestätigt keine Freischaltung deines Kontos.
Textkosten im Rechner schätzen →Praxisergänzung geprüft am 21. Oktober 2026 · eigene Aufgabe, kein Modellbenchmark
Zwei Anforderungen sehen fast gleich aus. Nur der Umgang mit fehlenden Preisen ändert sich. Du lässt den Unterschied benennen und leitest konkrete Prüffälle ab, bevor jemand die neue Regel in Code gießt. Das ist eine kleine Übung für die Kontrolle von Versionsänderungen.
Nutze ausdrücklich gpt-6-sol; GPT-6.1 Sol ist eine andere Version. Laut Hersteller unterstützt Sol Text- und Bildeingaben sowie strukturierte Textausgaben. Für diese Textübung brauchst du weder eine Shell noch ein Werkzeug mit Schreibrechten. Notiere den verwendeten Zugang und die Einstellungen, damit du den Versuch später mit einer anderen Version wiederholen kannst.
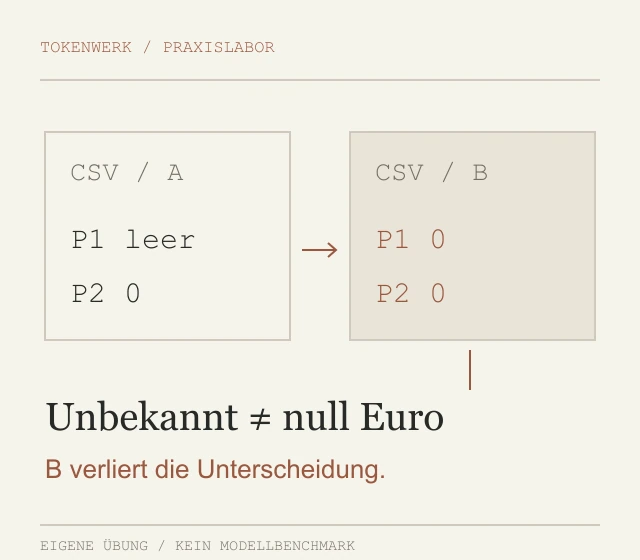
Lies beide Textstände selbst und markiere den einzigen sachlichen Unterschied.
Übergebe unveränderte Stände und die drei Beispieldatensätze. Fordere einen Vergleich, keine automatische Migration.
Prüfe die Sollfelder. Eine spätere Codeänderung braucht eigene Tests mit den echten Import- und Exportregeln.
Die Angaben sind fiktiv. Speichere den geforderten JSON-Teil der Antwort separat als antwort.json; zusätzliche Erklärungen gehören in eine andere Datei.
Stand A: CSV mit Name, Menge, Preis. Fehlende Preise bleiben leer.
Stand B: CSV mit Name, Menge, Preis. Fehlende Preise werden mit 0 ersetzt.
Beispieldaten: P1 hat keinen bekannten Preis; P2 kostet 0; P3 kostet 12.50.
Aufgabe: Beschreibe den einzigen sachlichen Unterschied separat in einem Satz.
Gib danach ausschließlich das Prüf-JSON aus: geaendertes_feld="Preis", spaltenanzahl=3,
preise_A und preise_B als Objekte mit P1, P2, P3. Stelle ein leeres CSV-Preisfeld im Prüf-JSON als null dar.
Setze verlust_unterscheidung auf true, wenn unbekannter und echter Nullpreis in B zusammenfallen.
Keine Datei ändern und keine weiteren Änderungen erfinden.Vorlage herunterladenLokalen JSON-Prüfer herunterladen
{
  "geaendertes_feld": "Preis",
  "spaltenanzahl": 3,
  "preise_A": {
    "P1": null,
    "P2": 0,
    "P3": 12.5
  },
  "preise_B": {
    "P1": 0,
    "P2": 0,
    "P3": 12.5
  },
  "verlust_unterscheidung": true
}Das Soll ist redaktionell aus der Vorlage abgeleitet, keine aufgezeichnete Modellantwort. Der lokale Prüfer vergleicht die festgelegten Felder und führt keinen generierten Code oder API-Aufruf aus. Er bewertet keine freien Begründungen.
Speichere Prüfer und deine Antwort im selben Ordner. Mit installiertem Python: python pruefen.py antwort.json.
| Beobachtung | Was du prüfst |
|---|---|
| null und 0 werden gleich behandelt | Vergleiche P1 und P2 getrennt; hier ist der Informationsverlust die eigentliche Änderung. |
| Zusätzliche Spalten werden behauptet | Lege beide Originalstände nebeneinander: Beide nennen dieselben drei Spalten. |
| Sol und Sol 6.1 werden im Test vertauscht | Halte die genaue Modell-ID fest; ein Namenswechsel macht einen Vergleich sonst unklar. |
Bevor aus dem Vergleich eine Änderung wird, kannst du Tests für KI-Code prüfen und eigene Grenzfälle festlegen.
Willst du den Versionswechsel untersuchen, kannst du zwei Modelle mit derselben Aufgabe vergleichen und Abweichungen je Durchlauf dokumentieren.
Gezielte Praxisergänzung auf Basis aktueller Herstellerunterlagen. Der Datenstand der bisherigen Modell-Faktentabellen bleibt separat ausgewiesen. Neue Beispiele und Grafiken sind eigene Erklärungen; es wurden keine Modellantworten oder Leistungswerte gemessen.
Herstellerunterlagen zur Ergänzung: GPT-6 Sol Model | OpenAI API (Abruf 2026-10-21) · GPT-6 Luna Model | OpenAI API (Abruf 2026-10-21).
Die verlinkten Herstellerunterlagen wurden für dieses Profil ausgewertet. Ältere Versionen und Einführungstexte dienen der Einordnung; aktuelle technische Angaben haben Vorrang. Abrufdaten stehen an den Quellen. Die Grafik ist redaktionell, kein Leistungstest.
Nein. Die API-IDs gpt-6-sol und gpt-6.1-sol sind getrennt dokumentiert. Die aktuelle Sol-Modellseite verweist auf 6.1 als neuere Variante; Einstellungen und Cache-Tarife unterscheiden sich.
Ja. Die Modellseite unterstützt none sowie low, medium, high, xhigh und max. Die Voreinstellung ist medium. Das unterscheidet sich vom neueren Sol6.1, das none nicht unterstützt.
Bei GPT-6 Sol ist Function Calling in Chat Completions nur mit reasoning_effort none unterstützt. Die Responses API ist für integrierte Werkzeuge und Reasoning mit Tools vorgesehen.
Im kurzen Standardtarif kostet Cache-Lesen bei Sol6 0,20 USD je Million Tokens, bei Sol6.1 0,10 USD. Normale Eingabe und Ausgabe kosten bei beiden 2/10 USD. Lange Eingaben und andere Verarbeitungsarten haben eigene Regeln.
Hier wird ihre dokumentierte API-Konfiguration eingeordnet. Die beiden Textstände sind eine eigene, noch nicht ausgeführte Übung; es wurden keine Modellantworten oder Qualitätswerte gemessen.
Im dokumentierten Quellenstand: 1.050.000 Tokens. Beachte die Bedingungen der konkreten Modellversion und des verwendeten Endpunkts. Kontext ist keine Wortzahl und kein Nachweis, dass jede enthaltene Information zuverlässig verarbeitet wird.
Lege eine kleine Aufgabe mit bekanntem oder nachprüfbarem Ergebnis fest. Notiere Version, Eingabe und Einstellungen. Vergleiche die Ausgabe mit deinem Prüfkriterium und halte Fehler sowie tatsächliche Kosten getrennt fest. Die Testidee auf dieser Seite ist ein Vorschlag und wurde hier nicht als Modelltest ausgeführt.
Nein. Die Modell-ID gpt-6-sol bezeichnet den hier behandelten Stand. Für eine Gegenüberstellung mit GPT-6.1 Sol brauchst du einen eigenen Durchlauf und ein Protokoll der jeweiligen Einstellungen.
Die Vorlage definiert einen leeren Preis als unbekannt. 0 ist dagegen ein bekannter Zahlenwert. Werden beide gleich gespeichert, lässt sich die ursprüngliche Bedeutung später nicht mehr unterscheiden.
Nein. Er liest deine kleine JSON-Antwort und vergleicht festgelegte Werte. Er öffnet keine CSV-Bestandsdatei, führt keinen Modellcode aus und sendet keine Daten an eine API.
Text & Reasoning
Für Programmierung und professionelle Aufgaben; Tool-Aufrufe sind in der Responses API dokumentiert.
Text & Reasoning
Für komplexe Analyse, Programmierung, Recherche und Aufgaben mit mehreren Werkzeugschritten.
Text & Reasoning
Für häufige, klar abgegrenzte Text-, Analyse- und Klassifikationsaufgaben.