Für lokale Sprachmodelle zählen Modellvariante, nutzbarer Grafikspeicher und ein unterstützter Softwarepfad zusammen. Rechne Gewichte, Kontext und Reserve getrennt. Kaufe erst, wenn du einen belegten Engpass und einen passenden Lösungsweg kennst.
Erst die KI-Aufgabe, dann die Grafikkarte
„KI nutzen“ kann einen kurzen Textentwurf, eine lange Dokumentfrage, Bilderzeugung oder Modelltraining bedeuten. Diese Aufgaben haben unterschiedliche Anforderungen. Dieser Guide konzentriert sich auf lokale Sprachmodell-Inferenz: Ein vorhandenes Modell erzeugt Antworten. Er ist keine allgemeine Einkaufsliste für Training oder Videomodelle.
Schreibe eine konkrete Aufgabe auf, etwa „einen kurzen technischen Text mit einem lokalen Modell zusammenfassen“. Notiere Modelltag, Quantisierung, gewünschten Kontext und die Zahl gleichzeitiger Anfragen. Eine Modellfamilie allein ist zu ungenau: Zwei Varianten derselben Familie können deutlich unterschiedlich groß sein.
Den vorhandenen Rechner für lokale KI prüfen: Das ist der erste Schritt. Vielleicht genügt eine kleinere Variante für deine Aufgabe. Ein neuer Beschleuniger ist erst sinnvoll begründet, wenn du weißt, welcher Teil des bisherigen Aufbaus nicht passt.
VRAM: Gewichte sind nur ein Teil
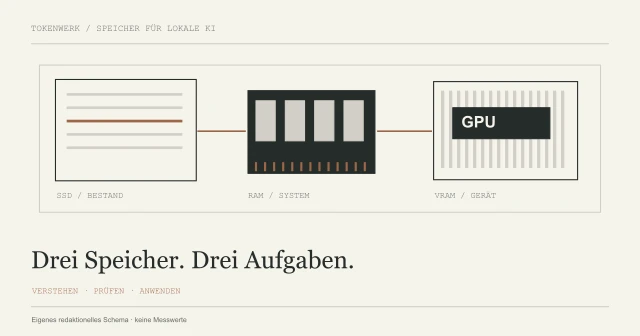
VRAM ist der Grafikspeicher einer separaten GPU. Ein geladenes Sprachmodell benötigt nicht nur seine Gewichte. Dazu kommen etwa Kontext- beziehungsweise KV-Cache, Laufzeitdaten und Reserven. Andere Programme können bereits Speicher belegen. Der Wert auf dem Karton ist daher nicht automatisch vollständig für deinen Lauf frei. Die Speicherplanung für lokale KI trennt Modellgewichte, Kontextcache und weitere Laufzeitdaten.
Eigene vereinfachte Rohgewichtsrechnung
Gewichtsbytes = Parameterzahl × Bit pro Gewicht / 8
7 Milliarden × 4 Bit / 8 = 3,5 Milliarden Bytes = 3,5 GB
14 Milliarden × 4 Bit / 8 = 7 Milliarden Bytes = 7 GB
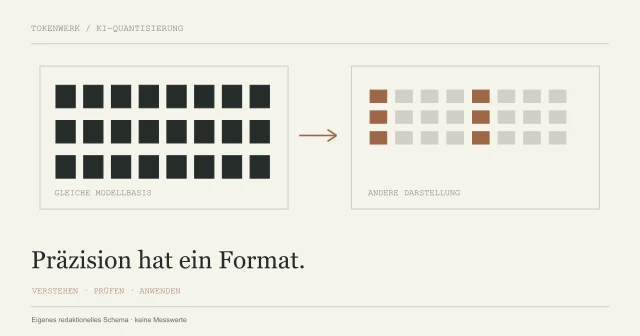
Nur rechnerische Rohgewichte; kein vollständiger VRAM-Bedarf.Das ist eine eigene Rechenschätzung in dezimalen GB. Tatsächliche Quantisierungsdateien enthalten zusätzliche Daten und verwenden nicht zwingend exakt vier Bit für jedes Gewicht. Die Rechnung beweist daher weder, dass eine bestimmte Karte genügt, noch wie schnell das Modell antwortet.
Größerer Kontext erhöht den Speicherbedarf. Prüfe deshalb die tatsächlich zugewiesene Größe statt nur das mögliche Maximum im Modellkatalog. Mit dem passenden Guide kannst du Das Ollama-Kontextfenster gezielt einstellen. Mehrere parallele Anfragen sind ein zusätzlicher eigener Lastfall.

GPU, Betriebssystem und Laufzeit zusammen prüfen
Ein Backend ist der Rechenweg zwischen Programm und Hardware. Eine grundsätzlich leistungsfähige Karte hilft wenig, wenn deine konkrete Laufzeit sie auf dem gewählten System nicht unterstützt.
| Plattform | Was du konkret abgleichen solltest |
|---|---|
| NVIDIA unter unterstütztem System | Kartenmodell, Compute Capability und Treiber. Die Referenz nennt ab Capability 5.0 differenzierte Treiberanforderungen; nicht nur den RTX-Namen prüfen. |
| AMD unter Linux oder Windows | Die getrennten Kartenlisten und den erforderlichen ROCm-/HIP-Treiberstack lesen. Unterstützung unter Linux nicht automatisch auf Windows übertragen. |
| Vulkan unter Windows oder Linux | Installierten Vulkan-Backendpfad, passenden Treiber und die tatsächlich gewählte GPU prüfen. |
| Apple-GPU | Ollama verwendet Metal. Gemeinsamer Systemspeicher ist ein anderer Aufbau als der VRAM einer separaten PC-Karte. |
Die Herstellerreferenz ist eine Kompatibilitätsquelle und kein Vergleichstest. Übertrage außerdem nicht jedes hier genannte Backend auf beliebige andere Programme. Ein Framework, ein Bildgenerator und eine lokale Chat-App können unterschiedliche Versionen und Hardwarewege verlangen. Wenn du andere KI-Rechenbausteine abwägst, solltest du NPU, GPU und CPU unterscheiden und deren tatsächlich unterstützte Software prüfen.
Was ein aktuelles Datenblatt wirklich belegt
Als konkretes Beispiel nennt NVIDIA für die GeForce RTX 5090 unter anderem 32 GB GDDR7, CUDA Capability 12.0 und kein NVLink. Das sind veröffentlichte Produkteigenschaften. Daraus folgt keine gemessene Tokenrate für dein Modell und kein allgemeiner Preis-Leistungs-Sieg.
Die betrachtete Produktseite enthält Referenz-/Founders-Edition-Angaben und weist auf Abweichungen von Partnerkarten hin. Kontrolliere vor einem Kauf die tatsächlich angebotene Variante: Abmessungen, Stromanschlüsse, Netzteilanforderung und Kühlung. Die Seite enthält teilweise unterschiedliche Strom-/Einbauangaben; verwende deshalb die konsistente Dokumentation deiner konkreten Karte und deines Netzteils.
Dieser Artikel nennt bewusst keinen aktuellen Straßenpreis und keine Rangliste. Wir haben die Karten nicht gegeneinander vermessen. Der Preisvergleich muss Zeitpunkt, lieferbares Modell, Gewährleistungsumfang und Gesamtsystem berücksichtigen. Das Vorschaubild zeigt ein eigens erzeugtes, unmarkiertes Hardwarekonzept und kein Foto der RTX 5090.
Eine oder mehrere GPUs?
Zwei Karten sind nicht automatisch eine einzelne doppelt große und doppelt schnelle Karte. Die Laufzeit muss die beteiligten Geräte unterstützen und das Modell passend verteilen. Dazu kommen Steckplätze, Anbindung, Platz, Strom und Kühlung.
Ollama beschreibt seinen Ladeweg so: Passt ein Modell vollständig auf eine verfügbare GPU, wird diese bevorzugt. Passt es nicht auf eine einzelne, kann das Modell über die verfügbaren GPUs verteilt werden. Das vermeidet nicht jede Übertragung und garantiert keine lineare Beschleunigung.
Trenne außerdem Modellverteilung von mehreren gleichzeitigen Anfragen. Ein Team kann anderen Gesamtdurchsatz benötigen als eine einzelne Person eine kurze Antwortzeit. Vergleiche deshalb den ersten Antwortbeginn, weiteren Durchsatz und das Verhalten unter Parallelität getrennt. Fremde Podcastwerte mit einer anderen Karte oder einem anderen Modell sind dafür kein Ersatz.
Vor dem Kauf eine nachvollziehbare Probe planen
Halte beim vorhandenen oder geliehenen Testaufbau dieselben Bedingungen fest: exakter Modelltag, Quantisierung, Laufzeitversion, Prompt, Kontext und Parallelität. Stelle eine kleine Aufgabe mit überprüfbarer erwarteter Eigenschaft. Ein schneller fehlerhafter Entwurf ist kein brauchbares Ergebnis.
Nur anzeigen: aktuell geladene Ollama-Modelle
ollama psFühre den Befehl aus, während dein lokales Modell geladen ist. PROCESSOR unterscheidet CPU, GPU oder gemischte Auslagerung. Ein leerer Status, weil das Modell bereits entladen wurde, beweist keinen erfolgreichen GPU-Lauf. Ein vollständig auf GPU geladenes Modell belegt wiederum keine bestimmte Antwortqualität.
Wenn Ollama in Docker läuft, musst du zusätzlich den GPU-Zugriff im Ollama-Container prüfen. Eine funktionierende Hostkarte bedeutet nicht automatisch, dass der Container sie sieht.
Den eigenen GPU-Bedarfszettel herunterladen. Er trennt bekannte Angaben, beobachtete Werte und offene Fragen. Hier wurden keine GPU-Installation, Modellabfrage oder Leistungsmessung ausgeführt.
Quellen & Methode
Vorgehen und Grenzen
Originaldokumentation im dokumentierten Umfang am20.10.2026 geprüft. Historische Haupttexte dienen dem symmetrischen Intentvergleich. Eigene Feldpläne, Rechenbeispiele, Prüfschemata und Grafiken; keine echten n8n-/Node-RED-/Ollama-Läufe, Hardwaretests oder Deepfake-Detektortests. GPU-Cover ist ein erzeugtes unmarkiertes Konzept, kein reales Produktfoto.
Bei Recherche, Texterstellung und Grafiken wird KI eingesetzt. Welche eigenen Versuche vorliegen und was nur als Beispiel dient, beschreibt dieser Beitrag. Unser Redaktionsstandard erklärt die Anforderungen an Belege und Berichtigungen.