KI & Modelle / Guide
RAG-Chatbot bauen: Mit eigener Wissensdatei und Quellenprüfung
Einen RAG-Chatbot mit n8n nachvollziehbar aufbauen: eigene Übungsdaten laden, Textstellen abrufen und Antworten prüfen. Mit Testdatei, Prompt und klaren Grenzen.
Technologie verstehen.
Besser entscheiden.
KI, Werkzeuge und digitale Infrastruktur verständlich einordnen.
Die hier aufgeführten Beiträge erscheinen unter dem Namen Joel Heuchert. Bei Recherche, Texterstellung und Grafiken wird KI eingesetzt. Jeder Artikel nennt seine verwendeten Quellen und beschreibt, ob eigene Messungen vorliegen oder Herstellerdokumentationen ausgewertet wurden.
Eine Quellenangabe ersetzt keinen eigenen Praxistest. Wenn ein Beitrag keine Messung enthält, wird daraus keine Testerfahrung abgeleitet. Für Hinweise und Berichtigungen gibt es die Seite Korrekturen. Weitere Angaben zum Anbieter stehen im Impressum.
Einen RAG-Chatbot mit n8n nachvollziehbar aufbauen: eigene Übungsdaten laden, Textstellen abrufen und Antworten prüfen. Mit Testdatei, Prompt und klaren Grenzen.
Was eine NPU macht, wie sie sich von CPU und GPU unterscheidet und wann Software sie nutzt. Mit TOPS-Einordnung, Kompatibilitätskette und Rechnercheck.
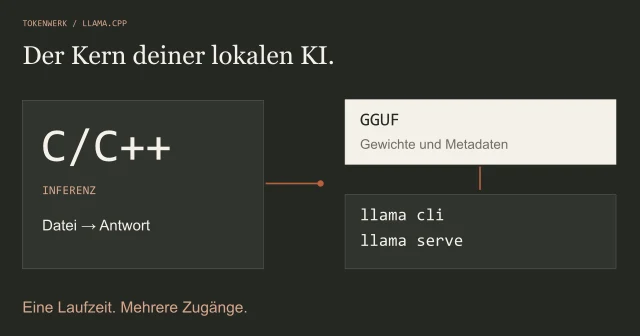
llama.cpp verständlich einrichten: offizielle App oder CLI wählen, GGUF laden, erste Antwort prüfen und eine lokale API starten. Mit Befehlen und Fehlerhilfe.
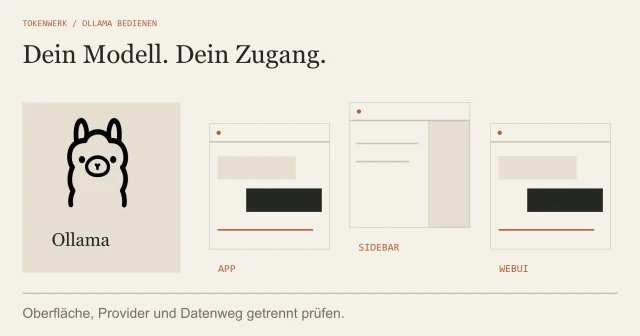
Welche Ollama-Oberfläche passt? Vergleiche App, Page Assist, Open WebUI und AnythingLLM nach Aufgabe und Datenweg. Mit Verbindungscheck und Dokumentenprobe.
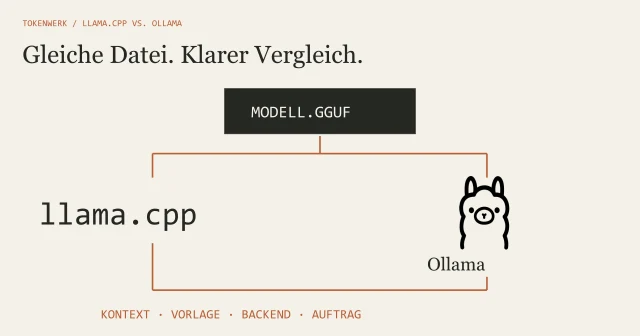
llama.cpp oder Ollama? Vergleiche Modellverwaltung, GGUF-Import, Laufzeitparameter und APIs. Mit gleichem Prüffall und ohne erfundenen Geschwindigkeitssieger.
Home Assistant mit n8n verbinden: Zugang einrichten, einen Zustand lesen und Fehler prüfen. Mit JSON-Importvorlage ohne Zugangsdaten und klaren Aktionsgrenzen.
RAG-Chatbot bauen: Mit eigener Wissensdatei und Quellenprüfung: Einen RAG-Chatbot mit n8n nachvollziehbar aufbauen: eigene Übungsdaten laden, Textstellen abrufen und Antworten prüfen. Mit Testdatei, Prompt und klaren Grenzen. Was ist eine NPU? KI-Hardware ohne die falschen Versprechen: Was eine NPU macht, wie sie sich von CPU und GPU unterscheidet und wann Software sie nutzt. Mit TOPS-Einordnung, Kompatibilitätskette und Rechnercheck. llama.cpp nutzen: Vom ersten Modell zur lokalen API: llama.cpp verständlich einrichten: offizielle App oder CLI wählen, GGUF laden, erste Antwort prüfen und eine lokale API starten. Mit Befehlen und Fehlerhilfe.
Wähle einen Titel nach deiner Frage und öffne den Beitrag. Dort stehen die ausführliche Erklärung, Quellen und gegebenenfalls Prüfschritte.
Die Themenübersicht bündelt Ressorts; über die Magazinsuche kannst du einen konkreten Begriff eingeben.