EmbeddingGemma 2 erzeugt Embeddings, keine fertigen Chatantworten. Für die Textsuche müssen Anfrage und Dokumente passend vorbereitet werden. Gleiche Vektorlänge, richtige Präfixe und Normalisierung gehören zur Prüfung.
Was EmbeddingGemma 2 zur Suche beiträgt
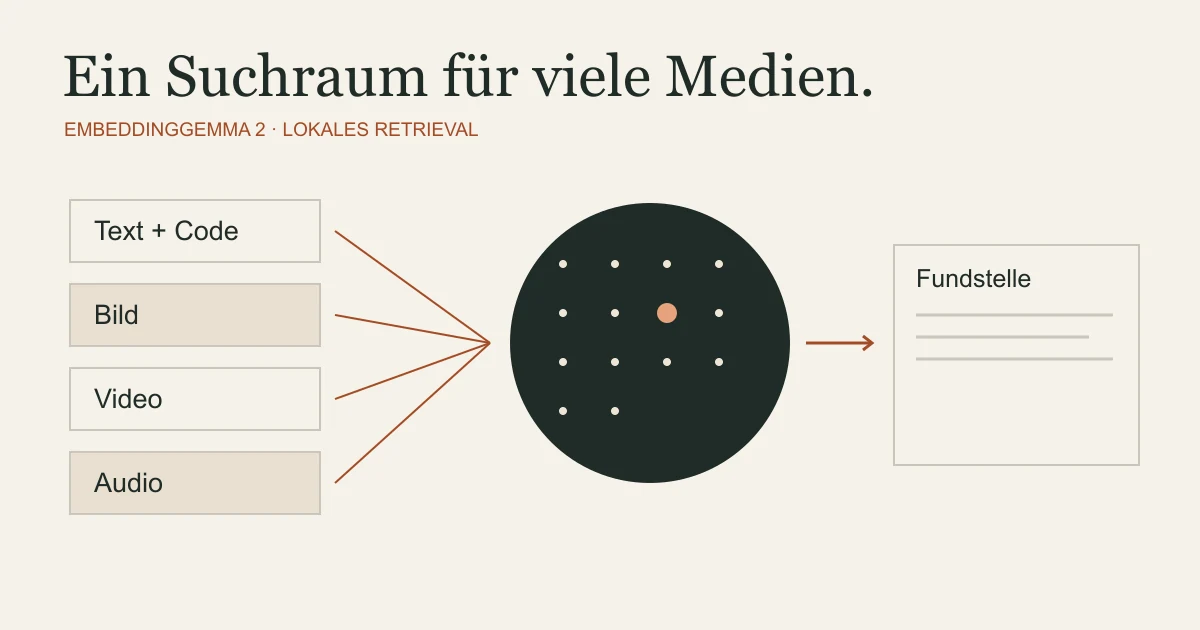
EmbeddingGemma 2 ordnet Text einschließlich Code sowie Bild-, Video- und Audioeingaben Zahlenfolgen zu, die ein Suchsystem auf Ähnlichkeit vergleichen kann. Google veröffentlichte das offene Modell am 6. Oktober 2026.
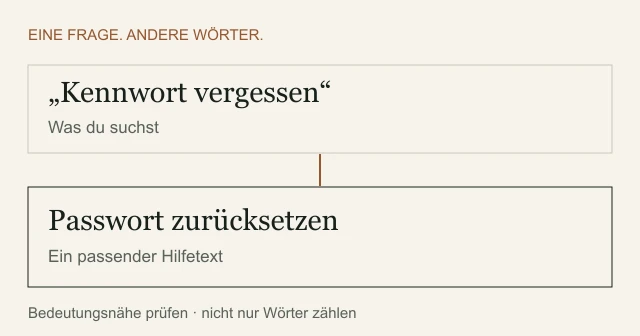
Für einen verständlichen Anfang genügt ein kleiner Hilfetextbestand. Eine Frage nach einem vergessenen Kennwort soll zur passenden Passwort-Anleitung führen. Im Grundlagenartikel kannst du semantische Suchtreffer nachvollziehbar prüfen. Die Modellwahl ist darin ein einzelner Schritt, nicht die gesamte Suchanwendung.

Nur die benötigten Encoder laden
| Verwendete Inhalte | Aktive Parameter | Entscheidung für den Einstieg |
|---|---|---|
| Text und Code | 270 Millionen | Für den ersten Hilfetextversuch ausreichend. |
| Zusätzlich Bilder und Videoframes | 440 Millionen | Wenn visuelle Inhalte Teil des Suchbestands sind. |
| Text und Audio | 570 Millionen | Wenn auch Aufnahmen im eigenen Material liegen. |
| Alle unterstützten Medien | 740 Millionen | Nur laden, wenn die Aufgabe diese Kombination braucht. |
Die Parameterzahl ist keine Speicherzusage für dein Gerät. Gewichte, Rechenpräzision, Laufzeit und Eingaben beeinflussen den tatsächlichen Bedarf. Die Quelle nennt 768 Ausgabedimensionen und einen gemeinsamen Kontext von 8.192 Tokens. Werden Medien kombiniert, teilen sie sich dieses Eingabebudget.
Die Modellkarte ist unter Apache 2.0 veröffentlicht; prüfe Lizenz- und Nutzungsbedingungen des tatsächlich geladenen Pakets sowie die Rechte an deinen Dokumenten. Für den folgenden Code bleiben die Bild- und Audioencoder ausgeschaltet.
Ein eigenes kleines Textbeispiel vorbereiten
Lege einen getrennten Übungsordner an. Der Google-Developer-Guide nennt Sentence Transformers ab 6.1.0. Die folgenden Befehle sind für eine macOS-/Linux-Shell geschrieben. Unter Windows aktivierst du die virtuelle Umgebung mit dem passenden Windows-Pfad.
Dokumentiertes Beispiel · nicht hier ausgeführt
python3 -m venv .venv
source .venv/bin/activate
python -m pip install "sentence-transformers>=6.1.0" transformersSpeichere den folgenden eigenen Lehrcode als textsuche.py. Er verwendet zwei erfundene Hilfetexte und eine Frage. Das Ergebnis wird erst beim tatsächlichen Ausführen auf deinem Rechner ermittelt; hier wird kein Platz-eins-Treffer behauptet.
Dokumentiertes Beispiel · nicht hier ausgeführt
import numpy as np
import torch
from sentence_transformers import SentenceTransformer

modell = SentenceTransformer(
    "google/embeddinggemma-2",
    config_kwargs={"vision_config": None, "audio_config": None},
    model_kwargs={"torch_dtype": torch.float32},
)
dokumente = [
    "title: Passwort | text: Über Kennwort zurücksetzen erhältst du einen neuen Zugang.",
    "title: Drucker | text: Für einen Papierstau öffnest du die hintere Klappe.",
]
optionen = {"truncate_dim": 256, "normalize_embeddings": True}
fragenvektor = modell.encode(
    ["Ich habe mein Kennwort vergessen."],
    prompt_name="SearchQuery", **optionen
)
dokumentvektoren = modell.encode(dokumente, **optionen)
assert np.isfinite(fragenvektor).all()
assert np.isfinite(dokumentvektoren).all()
werte = modell.similarity(fragenvektor, dokumentvektoren)[0]
for nummer in werte.argsort(descending=True).tolist():
print(nummer, float(werte[nummer]), dokumente[nummer])Die Frage erhält das Suchpräfix über SearchQuery. Die Dokumente besitzen schon die dokumentierte Titel-/Textform. Wiederhole die Probe danach mit einer Frage zum Papierstau und einer Frage, die keiner der Texte beantwortet. Ein hoher Ähnlichkeitswert ist noch keine Antwortprüfung.
Vektorlänge und Indexspeicher auseinanderhalten
Die Modellkarte dokumentiert Matryoshka-Verkürzung auf 512, 256 oder 128 Dimensionen. Kürzere Vektoren brauchen weniger Rohspeicher; ihre Qualität ist eine eigene Messfrage. Anfrage und Bestand müssen dieselbe Dimension verwenden und nach einer Verkürzung wieder normalisiert werden.
| Dimension | Reiner Zahlenpuffer | Nicht enthalten |
|---|---|---|
| 768 | 307,2 MB | Metadaten, Text, Indexstruktur und Laufzeit. |
| 512 | 204,8 MB | Dieselben zusätzlichen Bestandteile. |
| 256 | 102,4 MB | Dieselben zusätzlichen Bestandteile. |
| 128 | 51,2 MB | Dieselben zusätzlichen Bestandteile. |
MB ist hier dezimal gerechnet, also eine Million Byte. Die Zeile mit 128 Dimensionen benötigt ein Sechstel des Zahlenpuffers der 768er-Zeile. Daraus folgt weder ein sechsmal kleineres Gesamtprogramm noch eine sechsmal schnellere Suche.

Für größere Bestände musst du außerdem Vektoren und Metadaten speichern. Dokument-ID, Version und Zugriffsregeln bleiben wichtig, auch wenn die Vektoren kompakt gespeichert werden.
Drei typische Fehler vor dem Vergleich ausschließen
| Beobachtung | Mögliche Ursache | Sinnvolle Prüfung |
|---|---|---|
| NaN oder unplausible Vektoren | Ungeeignete Rechenpräzision | Die Modellkarte empfiehlt bfloat16 oder float32 und warnt vor float16. Endliche Werte prüfen. |
| Gleich lange Vektoren, schlechte Treffer | Falsche Präfixe oder verschiedene Modellstände | Modellrevision, Anfrage-/Dokumentvorbereitung und Indexherkunft abgleichen. |
| Nach Kürzung andere Reihenfolge | Nicht normalisiert oder Qualitätsverlust | Beide Seiten gleich kürzen, normalisieren und an denselben Sollfällen vergleichen. |
Ändere pro Gegenprobe eine Einstellung. Wenn du Modell, Dimension, Textaufteilung und Testfragen gleichzeitig austauschst, kannst du eine Verbesserung kaum einer Ursache zuordnen. Für den kleinen Einstieg bleiben daher Textbestand und Fragen zuerst unverändert.
Treffer prüfen, bevor ein Chatmodell antwortet
Lege vorab fest, welche Passage welche Frage beantworten soll. Halte unbeantwortbare Fragen separat fest. Dann prüfst du zuerst die gefundenen Texte und erst danach eine mögliche Formulierung durch ein weiteres Modell.
Als nächsten praktischen Schritt kannst du Abruf und Antwort in einer lokalen RAG-Probe trennen. Das dortige Beispiel hat seinen eigenen Modellstand; es ist keine bereits durchgeführte Messung von EmbeddingGemma 2.
Für Bilder, Audio oder Video ergänzt du neue Sollfälle mit klaren Fundstellen. Eine Einstellung, die bei zwei Hilfetexten funktioniert, ist noch keine belastbare Wahl für ein Medienarchiv. Die Google-Demos zeigen mögliche Aufbauten, ersetzen aber keinen Test auf deinen Daten.
Häufige Fragen
Ist EmbeddingGemma 2 ein generatives Sprachmodell?
Es ist ein Embedding-Modell. Es erzeugt Vektoren für Suche, Ähnlichkeit und verwandte Aufgaben. Eine ausformulierte Antwort benötigt einen zusätzlichen Schritt.
Muss ich alle 740 Millionen Parameter laden?
Nicht für jede Aufgabe. Google dokumentiert getrennt ladbare Encoder; die Text-/Codekonfiguration umfasst270 Millionen Parameter. Der tatsächliche Laufzeitspeicher ist eine andere Größe.
Kann ich 768er-Anfragen mit 256er-Dokumenten vergleichen?
Nicht direkt. Beide Seiten brauchen dieselbe passende Dimension und dieselbe Modellgrundlage. Die dokumentierte Verkürzung verlangt erneute Normalisierung.
Sind die Speicherzahlen im Artikel gemessen?
Nein. Es sind offengelegte Float32-Rechnungen für 100.000 Vektoren. Index, Metadaten und Laufzeit sind ausdrücklich ausgeschlossen.
Wurde das Python-Beispiel mit dem Modell ausgeführt?
Für diesen Guide nicht. Der Code wurde vorbereitet und syntaktisch geprüft; eine Ausgabe oder Trefferquote wird erst nach einem echten Modelllauf bewertet.
Quellen & Methode
Vorgehen und Grenzen
Vier vollständige Originalquellen am 26. Oktober 2026 gelesen und gegeneinander geprüft. Die Beispiele, Prüffälle und Grafiken wurden für diesen Guide erstellt. Es wurde dafür kein Modell aufgerufen, keine Audiodatei erzeugt und kein Benutzerkonto verändert. Code und erwartete Prüfkriterien sind von tatsächlichen Ergebnissen getrennt. Preise, Verfügbarkeit und Oberflächen können sich ändern.
Bei Recherche, Texterstellung und Grafiken wird KI eingesetzt. Welche eigenen Versuche vorliegen und was nur als Beispiel dient, beschreibt dieser Beitrag. Unser Redaktionsstandard erklärt die Anforderungen an Belege und Berichtigungen.