Knowledge Base und Chat-Anhang sind unterschiedliche Wege. Im aktuellen Native-Modus braucht am Modell hinterlegtes Wissen passende Knowledge-Werkzeuge. Full Context eines Chat-Anhangs und Focused Retrieval haben eigene Grenzen. Prüfe zwei bekannte Fakten und eine ausdrücklich fehlende Angabe.
Mit einem kleinen Dokument beginnen
Du brauchst eine laufende Open-WebUI-Instanz, einen verbundenen Modellzugang und die nötigen Rechte zum Anlegen einer Wissenssammlung und Hochladen von Dateien. Dieser Guide setzt den vorhandenen Zugang voraus. Wenn du noch die Oberfläche auswählst, hilft der Überblick Eine passende Oberfläche für Ollama auswählen.
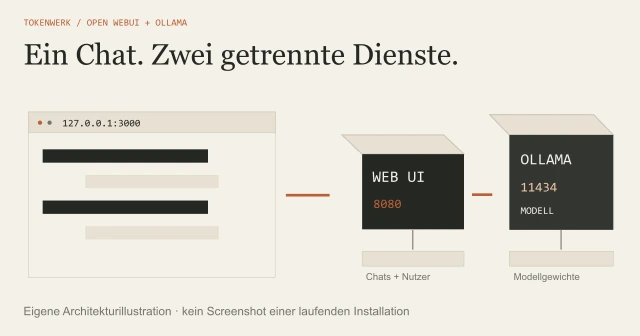
Die sichtbare Oberfläche sagt nicht allein, wo Daten verarbeitet werden. Extraktion, Embeddings und Antwortmodell können unterschiedliche lokale oder externe Anbieter nutzen. Verwende für die erste Probe keine privaten Unterlagen, sondern unsere eigene fiktive Textdatei.
Eigene kurze Testquelle
TOKENWERK · FIKTIVES TESTHANDBUCH ORBIS
Dokument-ID: ORBIS-TEST-01
Version: eigene Lernfassung 1

Das Wartungsfenster des fiktiven Systems Orbis ist dienstags von 09:00 bis 10:00 Uhr.
Die Statusdatei heißt orbis-status.log.
Eine Aufbewahrungsdauer und eine Passwortregel sind in diesem Handbuch nicht angegeben.
Alle Angaben sind erfunden; sie beschreiben keinen realen Dienst.
Das fiktive Orbis-Testhandbuch herunterladen. Es enthält zwei leicht überprüfbare Fakten und bewusst fehlende Informationen. Die Angaben sind keine Beschreibung eines realen Produkts.
Eine Knowledge Base anlegen und zuordnen
- Öffne Workspace → Knowledge und erstelle eine neue Wissenssammlung mit verständlichem Namen und Beschreibung.
- Wähle die passende Sichtbarkeit und prüfe, wer lesen oder bearbeiten darf. „Auf meinem Server“ bedeutet nicht automatisch „nur für mich“.
- Lade zunächst nur die Testdatei hoch und warte auf die abgeschlossene Verarbeitung.
- Öffne die Dateivorschau. Unterscheide Preview des Originals von Indexed text, dem tatsächlich extrahierten Suchtext.
- Beginne einen neuen Chat und ordne die Wissenssammlung ausdrücklich über # zu. Kontrolliere den sichtbaren Anhang.
Prüfe im indexierten Text die Dokument-ID, das Wartungsfenster und den Dateinamen. Wenn dort eine Zeile fehlt, kann ein Modell sie nicht allein deshalb korrekt nachschlagen, weil sie im Original schön lesbar aussieht.
Bei gescannten PDFs ist die Extraktion eine eigene Stufe. Der Guide Text aus gescannten PDFs mit OCR erschließen hilft dabei, eine unlesbare Textebene von einem Such- oder Modellproblem zu unterscheiden.

Focused Retrieval und Full Context unterscheiden
Focused Retrieval sucht passende Ausschnitte. Full Context eines im Chat angehängten Dokuments gibt den vollständigen extrahierten Inhalt weiter. Vollständig extrahiert heißt nicht automatisch vollständig vom Modell verarbeitet: Die Eingabe muss weiterhin in den verfügbaren Kontext passen. Die RAG-Grundlagen helfen dir, die Suche nach Textstellen von der anschließenden Antwortgenerierung zu unterscheiden.
| Zuordnung | Worauf du achten solltest |
|---|---|
| Datei oder Wissenssammlung im Chat | Anhang und gewählten Modus prüfen. File Context und Builtin Tools beeinflussen den tatsächlichen Weg. |
| Wissen am Modell oder Ordner, Default/Native | Kein automatisches Einfügen allein durch die Zuordnung. Das Modell muss Knowledge-Werkzeuge verwenden können. |
| Kleine Datei im Chat, Full Context | Gut für die überschaubare Gegenprobe; Kontextbudget und extrahierten Text weiterhin kontrollieren. |
Für den aktuellen Native-Weg prüfst du Builtin Tools und die Kategorie Knowledge Base sowie die tatsächliche Tool-Fähigkeit des Modells. Eine am Modell hinterlegte Sammlung wird durch ihren Namen oder ein Full-Context-Etikett allein nicht automatisch zu gelesenem Wissen. Schalte nicht wahllos Funktionen ab, um einen einzelnen alten Forentipp nachzubauen.
Wenn Ollama im Hintergrund läuft, kannst du Das tatsächlich zugewiesene Ollama-Kontextfenster prüfen. Ein großer Wert im Modellnamen ersetzt keine Statuskontrolle. Unsere Textprobe ist bewusst kurz und braucht keinen pauschalen riesigen Kontext.
Bekannte und unbekannte Angaben abfragen
Stelle die Fragen zunächst einzeln. Ein schöner Antwortstil ist noch keine Abnahme. Öffne die angegebene Quelle und vergleiche den konkret behaupteten Inhalt mit der Datei.
Eigener Prüfauftrag
Nutze die ausdrücklich beigefügte Orbis-Testquelle.
Nenne bei belegten Angaben die Dokument-ID und die passende Textstelle.
1. Wann liegt das Wartungsfenster?
2. Wie heißt die Statusdatei?
3. Welche Passwortregel ist vorgeschrieben?
Wenn die Quelle eine Angabe nicht enthält, benenne das ausdrücklich.Die erste Antwort muss sich auf dienstags 09:00–10:00 Uhr beziehen, die zweite auf orbis-status.log. Eine Passwortregel ist nicht angegeben. Das sind erwartete Eigenschaften unserer fiktiven Quelle, keine von uns beobachteten Modellantworten.
Auch eine eingeblendete Quellenmarkierung garantiert nicht, dass der Satz korrekt gestützt ist. Prüfe, ob die markierte Passage wirklich zur Behauptung gehört. Führe die Gegenprobe bei Bedarf mit derselben kleinen Datei im Chat und ausdrücklich gewähltem Full Context durch.
Was nach Änderungen neu verarbeitet werden muss
| Geändert | Was du unterscheiden musst |
|---|---|
| Embeddingmodell | Vorhandene Wissenssammlungen passend neu indexieren; unterschiedliche Modellräume nicht mischen. |
| Chunkgröße oder Überlappung | Neue Uploads verwenden neue Einstellungen. Bestehende Chunks bleiben bis zur Neuindexierung erhalten. |
| Extraktionsengine oder OCR-Einstellung | Eine Neuindexierung liest das Original nicht neu. Die Datei muss für eine neue Extraktion erneut hochgeladen werden. |
| Standalone-Datei nur im Chat | Die Knowledge-Base-Neuindexierung erfasst diesen getrennten Index nicht; gegebenenfalls neu hochladen. |
Sichere den benötigten Stand und plane Zeit sowie mögliche Kosten des Embeddinganbieters, bevor du einen großen Bestand neu verarbeitest. Eine neue Sucheinstellung ist keine Begründung, einen gesamten Ordner ungeprüft zu löschen.
Aktuelle Verzeichnissynchronisierung und ältere Anleitungen unterscheiden sich. Die gelesene Knowledge-Hilfe beschreibt seit Version 0.9.6 einen inkrementellen Abgleich mit Übernahme neuer, geänderter und entfernter Dateien. Ein Sync ist deshalb auch heute keine Aktion, die man ohne Prüfung der entfernten Dateien als bloßes Hinzufügen behandeln sollte.
Wenn die Datei da ist, aber keine Antwort trägt
Prüfe die Kette: Verarbeitung abgeschlossen → richtiger Benutzerzugriff → Indexed text vorhanden → richtiger Anhang → passender Abrufmodus und Werkzeuge → ausreichender Kontext → Aussage an Quelle geprüft. Ein stärkeres Modell kann eine vorher fehlende Textstelle nicht zuverlässig ersetzen.
Wenn die Sammlung am Modell hängt und in Native keine Suche erfolgt, kontrolliere wirksame globale und modellspezifische Einstellungen sowie die Knowledge-Kategorie. Für eine kleine Diagnose ist ein ausdrücklich zugeordneter Chat-Anhang oft überschaubarer als mehrere Sammlungen, Ordner und Modellpresets gleichzeitig.
Die aktuelle Fehlerhilfe nennt auch fehlende Einzeldatei-Indizes nach Änderungen an der Vektordatenbank. Gehe deshalb nicht direkt an Rohdatenbankdateien. Prüfe den dokumentierten Neuindexierungs- oder Uploadweg und dessen Umfang. Nach jeder Änderung wiederholst du dieselben drei kleinen Fragen und vergleichst die Quellen.
Es wurden für diesen Artikel keine Open-WebUI-Instanz eingerichtet, Dokumente an Anbieter übertragen oder Modellantworten gemessen. Die Testdatei, Prüffragen und Grafik sind eigene Lernhilfen.
Quellen & Methode
Vorgehen und Grenzen
Originalquellen am 20. Oktober 2026 im dokumentierten Umfang geprüft. Vier ausgewählte vollständige Haupttexte pro Thema symmetrisch verglichen. Beispiele und Grafiken sind eigene Lernhilfen. Rechenwerte und simulierte Clientaufrufe sind von echten Produktläufen getrennt; keine Botnachricht, Datenbankinstallation, Anbieterübertragung oder Modellmessung behauptet. Das Smartphone-Cover ist ein erzeugtes Konzept, kein echtes Produktfoto.
Bei Recherche, Texterstellung und Grafiken wird KI eingesetzt. Welche eigenen Versuche vorliegen und was nur als Beispiel dient, beschreibt dieser Beitrag. Unser Redaktionsstandard erklärt die Anforderungen an Belege und Berichtigungen.