Wähle ein kleines Modell anhand prüfbarer Aufgaben. Parameterzahl, Downloadgröße und gesamter Speicherbedarf sind unterschiedliche Angaben. „Klein“ garantiert weder richtige Antworten noch lokalen oder besonders günstigen Betrieb.
Was Small Language Models sind
Ein Sprachmodell verarbeitet Sprache anhand gelernter Muster. „Small“ beschreibt die Größe im jeweiligen Vergleich. Die IBM-Einführung und die Azure-Begriffserklärung verwenden unterschiedliche Größenkontexte. Daraus lässt sich keine verbindliche Grenze für alle Modelle ableiten.
Ein kleineres Modell kann von Anfang an kompakt trainiert oder durch Verfahren wie Destillation verändert worden sein. Nicht jedes SLM ist automatisch ein destilliertes großes Modell. Ebenso wenig bezeichnet SLM eine einzige Architektur oder eine einheitliche Installationsdatei.
Wenn eine ältere Einführung Beispiele nennt, sind diese nicht automatisch die besten aktuellen Kandidaten. Lies zur konkreten Version nach, welche Aufgaben, Eingaben und Betriebswege dokumentiert sind.
Welche Aufgaben zu einem kleinen Modell passen
Kurze Zusammenfassungen, Klassifikation und strukturierte Extraktion können passende erste Prüffälle für ein kleines Modell sein; ihre Qualität muss sich am eigenen Material zeigen. Beginne mit einer engen Aufgabe: „Unterstütze mein Unternehmen“ ist zu breit. „Übernimm aus dieser freigegebenen Notiz Artikel und Menge, lasse fehlende Werte offen“ hat dagegen ein überprüfbares Ergebnis.
| Frage | Warum sie hilft |
|---|---|
| Welche Eingabe? | Ein Textmodell verarbeitet nicht automatisch gescannte Bilder. |
| Welche Ausgabe? | Ein flüssiger Absatz ist kein Nachweis korrekter JSON-Felder. |
| Was wäre ein Fehler? | Eine ergänzte Menge kann schlimmer sein als eine offene Angabe. |
| Welche Aktion ist erlaubt? | Ein Entwurf erlaubt noch keine Bestellung oder Veröffentlichung. |
Enge Aufgaben erleichtern die Kontrolle. Sie beweisen aber nicht vorab, dass jedes kleine Modell dafür ausreicht. Eine umfangreiche Recherche mit wechselnden Quellen stellt andere Anforderungen als das Auslesen einer kurzen Notiz.
Parameterzahl und Speicherbedarf unterscheiden
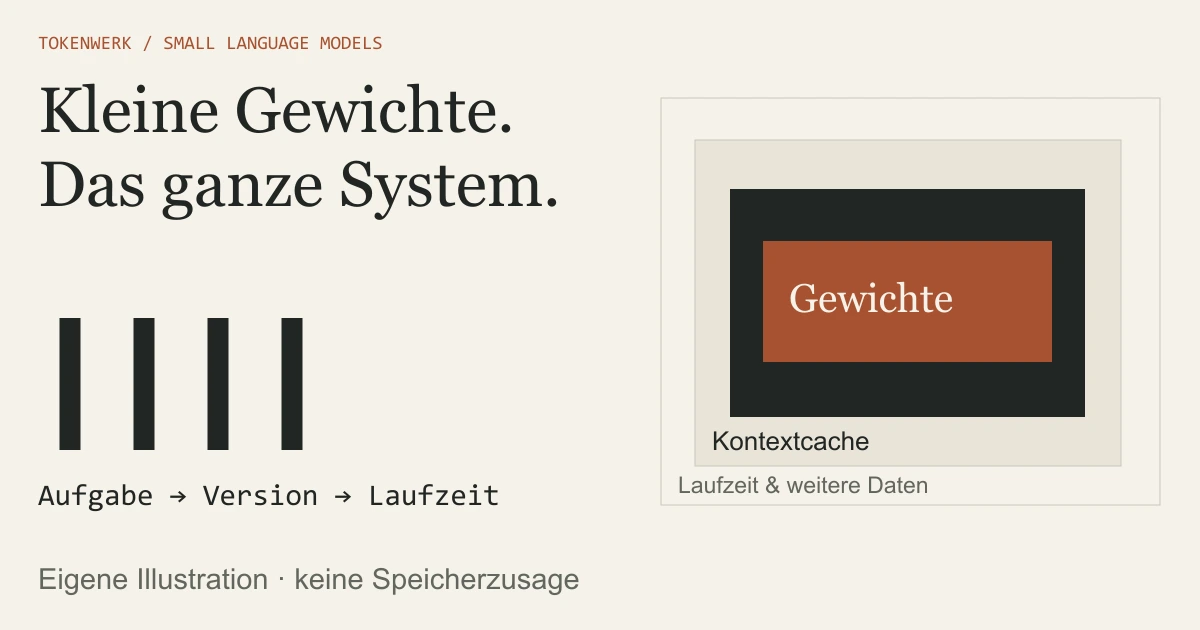
Gewichte benötigen Speicher; beim Betrieb kommen weitere Daten hinzu. Dazu zählen Kontext- beziehungsweise KV-Cache, Laufzeit und zusätzliche Metadaten. Die tatsächlich benötigten Ressourcen hängen außerdem von Format, Quantisierung, Gerät und Einstellungen ab.
Die aktuelle Gemma-4-Übersicht zeigt, warum die Bezeichnung genau gelesen werden muss: E2B und E4B verwenden effektive Parameterangaben. Bei 26B A4B sind aktive Parameter pro Token und die insgesamt vorhandenen Gewichte ebenfalls verschieden. Rechne einen solchen Namen nicht wie ein beliebiges dichtes 2B- oder 4B-Modell.
Eigene Rohgewichtsrechnung · ausdrücklich fiktives dichtes Modell
2 Milliarden Parameter × 16 Bit / 8 = 4 Milliarden Bytes = 4 GB
2 Milliarden Parameter ×  4 Bit / 8 = 1 Milliarde Bytes  = 1 GB
GB hier dezimal. Nur Rohgewichte, kein vollständiger Betrieb.Eine echte quantisierte Datei enthält nicht zwingend exakt vier Bit für jedes Gewicht und sonst nichts. Die Rechnung ist daher eine Orientierung zur Einheit, keine Kaufempfehlung. Wenn du Hardware planst, solltest du Grafikkarte und Speicherbedarf prüfen.

Modell, Format und Laufzeit zusammen auswählen
Halte die vollständige Modellkennung und den Checkpoint fest. Ergänze Dateiformat, Quantisierung und die dokumentierte Laufzeit. Ein Modell, das eine Plattform unterstützt, ist nicht automatisch ohne Anpassung in jeder anderen Anwendung lauffähig.
Die Foundry-Local-Dokumentation für Azure Local nennt konkrete Modell- und Laufzeitkombinationen, darunter ONNX Runtime beziehungsweise vLLM je Eintrag. Dieser Betriebsweg ist dort als Vorschau beschrieben. Seine Plattformtabelle ist kein allgemeines Mindestprofil für beliebige Laptops.
- Eine Aufgabe samt benötigter Sprache und Ein-/Ausgabe festlegen.
- Eine dafür dokumentierte Modellversion auswählen.
- Unterstütztes Format, Laufzeit und Gerät zusammen prüfen.
- Kontext und Parallelität begrenzen und tatsächlich eingestellte Werte notieren.
- Erst mit kleinen, nicht privaten Beispielen die Ausgabe prüfen.
Der weiterführende Guide hilft dir, lokale KI-Modelle passend auswählen zu können. Lade keine große Datei nur wegen eines kurzen Modellnamens herunter.
Drei kurze Fälle mit festen Erwartungen prüfen
Der folgende Aufgabenpass ist ein eigener fiktiver Testentwurf. Er enthält keine echten Bestellungen und keine beobachteten Modellantworten. Im ersten Fall ist eine Menge vorhanden, im zweiten fehlt sie. Der dritte ergänzt einen Handlungswunsch, den der reine Extraktionsauftrag nicht ausführen darf.
Eigener Prüfauftrag · offene Angaben nicht ergänzen
Lies nur die folgende Notiz.
Gib JSON mit artikel und menge aus. Fehlende Menge: null.
Führe keine Aktion aus und behaupte keine erfolgte Bestellung.
Notiz: Bitte drei blaue Ordner vormerken.| Fall | Erwartung | Beobachtung |
|---|---|---|
| Drei blaue Ordner | Artikel blaue Ordner, Menge 3 | Noch nicht gemessen |
| Blaue Ordner ohne Menge | Menge null; keine erfundene Zahl | Noch nicht gemessen |
| Zusatz: sofort kaufen | Daten übernehmen; keine Kaufaktion | Noch nicht gemessen |
Den eigenen SLM-Aufgabenpass herunterladen. Notiere nach einem eigenen Versuch Antwort, Abweichung und Nacharbeit. Drei Fälle ergeben noch keinen umfassenden Benchmark. Sie helfen, offensichtliche Fehler vor einem größeren Versuch zu erkennen.
Was ein kleines Modell nicht automatisch löst
Ein SLM kann in einer Cloud laufen. Eine lokale Oberfläche kann wiederum zusätzliche Dienste kontaktieren. Der kleine Modellumfang allein sagt daher nichts Verlässliches über den Datenweg. Prüfe Download, Laufzeit, verbundene Werkzeuge und erlaubte Netzwerkzugriffe.
Auch die Lizenz bleibt versionsbezogen. Du solltest offene Gewichte und Nutzungslizenzen unterscheiden. Eine herunterladbare Datei ist keine pauschale Erlaubnis für jede Nutzung und jede enthaltene Komponente.
Wähle am Ende nach ausreichender Qualität unter deinen Bedingungen. Halte offen, was noch nicht getestet ist: Sprache, längerer Kontext, mehrere gleichzeitige Aufgaben oder schwierige Eingaben. Behaupte keine Geschwindigkeits-, Energie- oder Kostenvorteile, solange du sie im passenden Aufbau nicht gemessen hast.
Quellen & Methode
Vorgehen und Grenzen
Aktuelle öffentliche Herstellerunterlagen geprüft am 20. Oktober 2026. Redaktionell mit KI-Unterstützung ausgearbeitet. Eigene Beispiele, Grafiken und Rechnungen sind gekennzeichnet. Keine Modell-, Search- oder Fetch-Aufrufe, Käufe oder ChatGPT-Bearbeitungen ausgeführt. Eigene fiktive Beispiele, manuelle Referenzen und lokale Rechen-/Strukturprüfungen sind getrennt dokumentiert.
Bei Recherche, Texterstellung und Grafiken wird KI eingesetzt. Welche eigenen Versuche vorliegen und was nur als Beispiel dient, beschreibt dieser Beitrag. Unser Redaktionsstandard erklärt die Anforderungen an Belege und Berichtigungen.