Mistral AI / Modellprofil
Ministral 3 14B
Ministral 3 14B ist ein KI-Modell von Mistral für Text und Bilder. Es antwortet mit Text und lässt sich auf eigener Hardware oder über eine API nutzen.
Für Chat und die Beispiele hier: Instruct. Base ist zum Weitertrainieren gedacht; Reasoning ist eine eigene Variante für mehrstufige Aufgaben.
Quellen geprüft am 24. Oktober 2026
Ministral 3 8B und 14B vergleichen ↗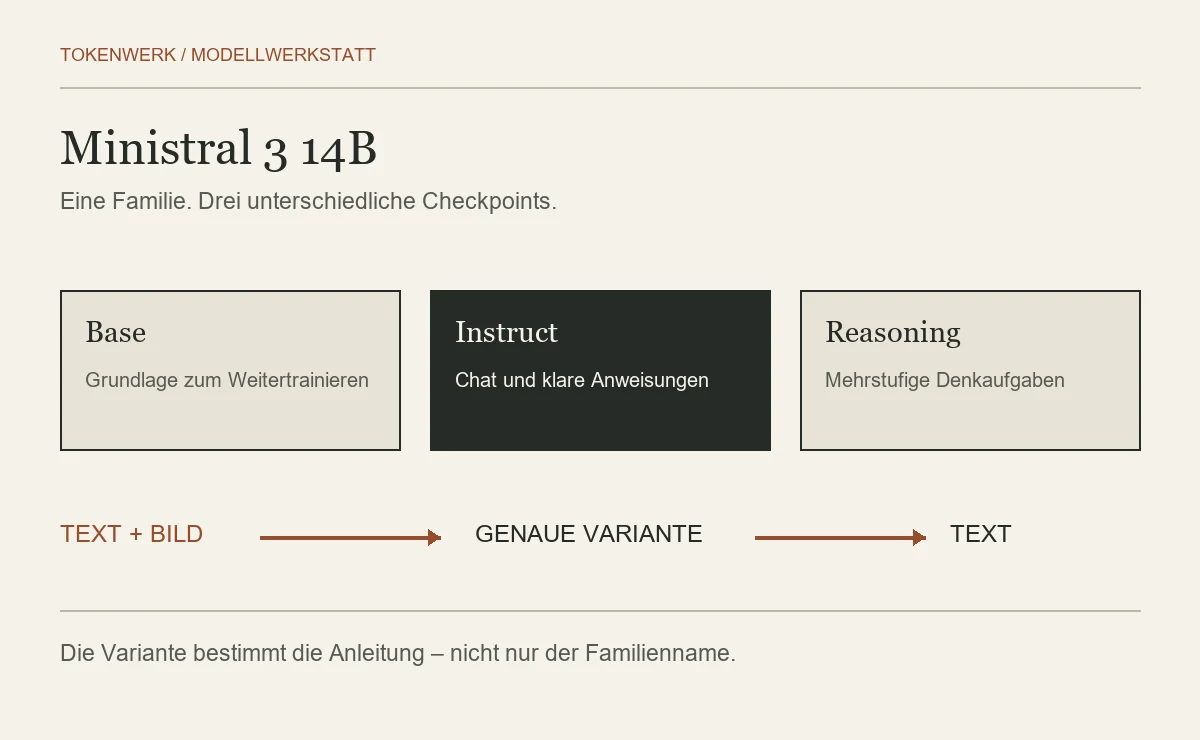
- Eingabe
- Text + Bild
- Ausgabe
- Text
- Kontext
- 256K laut Hersteller¹
- API je 1 Mio. Tokens
- 0,20 USD ein / 0,20 USD aus
Welche Ministral-Variante brauchst du?
Für einen Chat oder eine Aufgabe mit festem Antwortformat startest du mit Instruct. Möchtest du das Modell weitertrainieren, ist Base die dafür vorgesehene Grundlage. Reasoning ist eine eigene Variante für mehrstufige Aufgaben. Notiere immer den vollständigen Modellnamen: Der Checkpoint bezeichnet den veröffentlichten Modellstand, etwa Instruct-2512.
| Variante | Wofür gedacht? | Modellstand und Vorbereitung |
|---|---|---|
| Base | Weitertraining und angepasste Modellarbeit; kein erster Chat für Einsteiger. | Ministral-3-14B-Base-2512; eigener Trainings- und Auswertungsplan. |
| Instruct | Chat, Auslesen eines Belegs, Klassifikation und klare Arbeitsaufträge. | Ministral-3-14B-Instruct-2512; passendes Chat-Template und Ausgabeprüfung. |
| Reasoning | Mehrstufige Aufgaben, bei denen eine zusätzliche Denkphase zum Versuchsplan passt. | Ministral-3-14B-Reasoning-2512; eigene Sampling-Einstellungen und Tokenverbrauch. |
Die Beispiele auf dieser Seite verwenden Instruct. Wenn du Reasoning damit vergleichen möchtest, gib beiden dieselbe Aufgabe und lege vorher fest, welche Antwort richtig wäre.
Wie viel Speicher braucht Ministral 3 14B?
Das hängt vor allem vom Dateiformat und der eingestellten Kontextlänge ab. Mit dem Rechner schätzt du zunächst nur den Speicher für die Modellgewichte. Kontextcache und Laufzeit brauchen zusätzlichen Platz. Gerechnet wird mit gerundet 14 Milliarden Parametern; Mistral nennt rund 13,5 Milliarden Sprach- und 0,4 Milliarden Bildparameter.
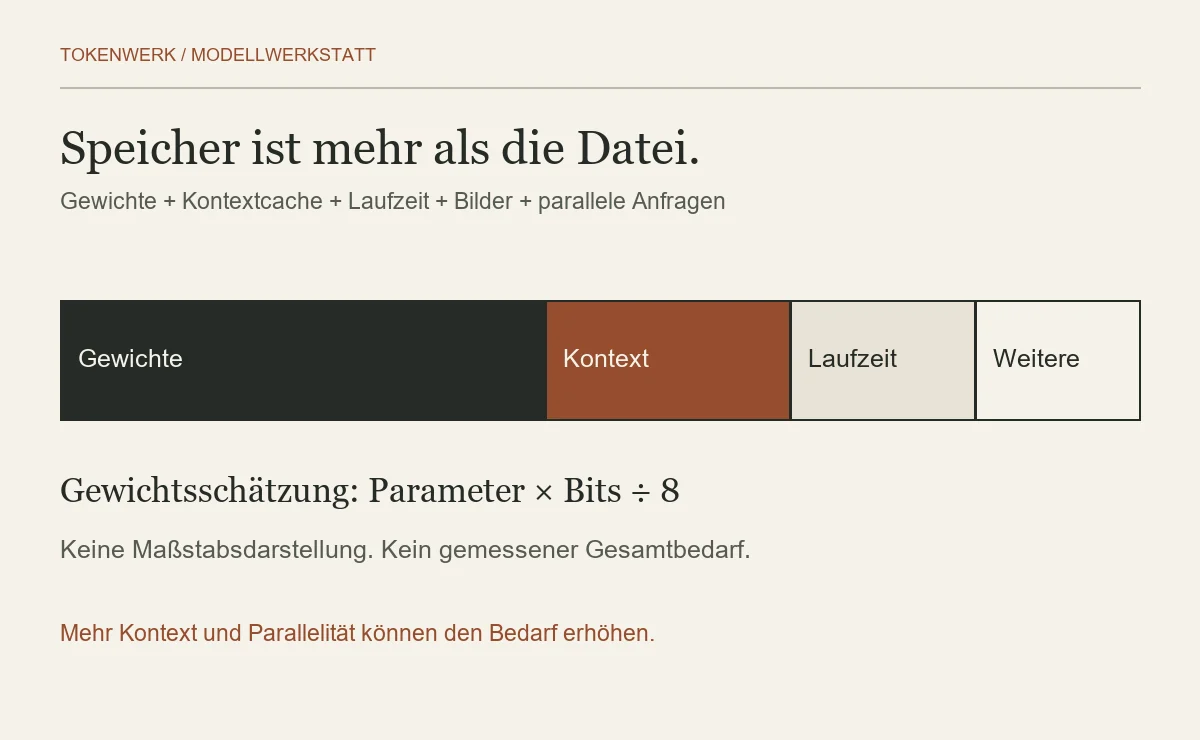
Die Rechnung ist noch keine Hardwareempfehlung. Zusätzlich werden Speicher für den Kontext, die Laufzeit, Bilder und gegebenenfalls mehrere gleichzeitige Anfragen benötigt. Auch Dateimetadaten und gemischte Präzision können die tatsächliche Größe verändern. Ob sich RAM und Grafikspeicher gemeinsam nutzen lassen, hängt von der Laufzeit ab.
Die Instruct-Modellkarte nennt einen Betrieb auf einer einzelnen 24-GB-GPU im beschriebenen FP8-Szenario. Die Reasoning-Karte beschreibt ihr BF16-Szenario mit 32 GB. Das sind dokumentierte Szenarien, keine universellen Mindestanforderungen. Der Guide zu lokalen KI-Modellen hilft dir, Aufgabe, Format und Laufzeit zusammen auszuwählen.
Was kostet Ministral 3 14B?
| Weg | Kosten und Voraussetzungen | Darauf kommt es an |
|---|---|---|
| Lokale Gewichte | Eigener Rechner, Speicher, Energie und Betrieb; keine Mistral-Tokenrechnung für die lokale Inferenz. | Apache-2.0-Lizenz, Laufzeit, Gewichteformat und Netzwerkzugriff. |
| Mistral-API | 0,20 USD / Million Eingabe; 0,20 USD / Million Ausgabe; 0,02 USD / Million tatsächlich gecachte Eingabe. | Konkrete Modell-ID ministral-14b-2512, Cache-Nutzung und aktuelle Tarifbedingungen. |
| Anderer Hoster | Eigener Tarif und gegebenenfalls abweichende Endpunktgrenzen. | Region, Datenverarbeitung, Kontext, Ausgabegrenze und Preis. |
Die Modellfamilie hat offene Gewichte unter Apache 2.0. Das macht einen lokalen Versuch möglich, ersetzt aber weder Betriebsarbeit noch die Prüfung deiner Daten und verbundenen Dienste.
Ministral 3 14B lokal einrichten
Der folgende Befehl ist für Linux mit einer von vLLM unterstützten GPU- und Treiberumgebung gedacht. Die Vorlage basiert auf der Instruct-Modellkarte; wir begrenzen den Server hier ausdrücklich auf den eigenen Rechner und ein kleineres Startfenster. Du brauchst genug Speicher und Platz für den Download. Die Karte nennt mindestens vLLM 0.12.0 und mistral_common 1.8.6; prüfe zusätzlich, welche aktuellen Paketversionen zu deinem Rechner passen.
- Projektordner anlegen. Lege einen eigenen Projektordner und eine virtuelle Python-Umgebung an. Prüfe Treiber und Laufzeit vor der Installation.
- Instruct-2512 starten. Verwende Instruct-2512 und notiere die tatsächlich installierten Paketversionen. Der Download erfolgt auf deinem Rechner.
- Mit einer kurzen Aufgabe beginnen. Beginne mit kurzem Text und begrenzter Ausgabe. Prüfe den JSON-Entwurf anschließend unabhängig vom Modell.
python -m venv .venv
source .venv/bin/activate
# Unterstützte GPU-/Treiberumgebung vorher nach vLLM-Dokumentation prüfen.
python -m pip install vllm mistral_common

vllm serve mistralai/Ministral-3-14B-Instruct-2512 \
  --tokenizer_mode mistral --config_format mistral --load_format mistral \
  --enable-auto-tool-choice --tool-call-parser mistral \
--host 127.0.0.1 --port 8000 --max-model-len 8192Warum 8192? Das ist ein gewähltes Startlimit für Eingabe und Ausgabe zusammen, kein Modellmaximum. Ein kleineres Kontextfenster begrenzt den benötigten Kontextcache; es garantiert trotzdem nicht, dass die Gewichte und Laufzeit in deinen Speicher passen. 127.0.0.1:8000 ist nur vom selben Rechner erreichbar. Ein Container braucht eine zusätzlich passende Netzwerkkonfiguration.
Startparameter und Kontextwert nachgelesen am 28. Oktober 2026: vLLM-CLI und offizielle Instruct-Konfiguration. Kein neuer Modelllauf.
Wir haben diesen Startbefehl nicht mit einem heruntergeladenen 14B-Modell ausgeführt. Reicht der Speicher nicht, prüfe Kontextlänge, gleichzeitige Anfragen und ein zur Laufzeit passendes quantisiertes Format. Halte dabei fest, ob du die Modellvariante wechselst.
Beispiel: Auftragsdaten als JSON auslesen
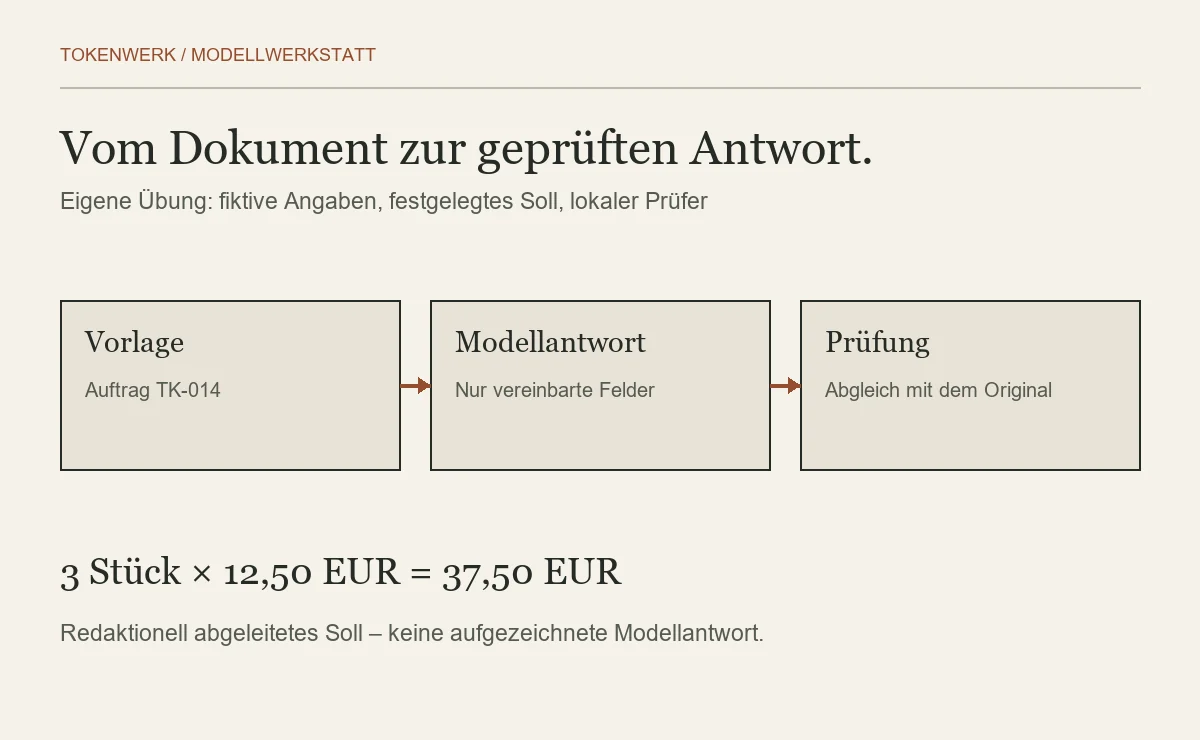
Mit dieser kurzen Aufgabe siehst du, ob die Antwort die Vorlage korrekt übernimmt. Menge und Einzelpreis ergeben 37,50 EUR. Ein Liefertermin ist nicht genannt und muss deshalb null bleiben.
Vorlage zum Kopieren
Lies ausschließlich diesen fiktiven Auftrag. Gib genau ein JSON-Objekt aus.
Auftrag TK-014. Artikel: USB-C-Adapter. Menge: 3. Einzelpreis: 12,50 EUR. Termin noch offen.
Felder: auftrag_id, artikel, menge, einzelpreis_eur, gesamt_eur, liefertermin.
Preise als JSON-Zahlen. Nicht genannte Termine bleiben null. Keine weiteren Felder.Speichere nur das JSON-Objekt deiner Antwort als antwort.json. Lade den Prüfer herunter und führe python pruefen-extraktion.py antwort.json lokal aus. Er nutzt ausschließlich die Python-Standardbibliothek, führt keinen generierten Code aus und sendet keine Daten.
Lösung und Prüfkriterien ansehen
Alle sechs Schlüssel sind vorhanden. Auftrag und Artikel stimmen exakt, Menge ist die ganze Zahl 3, Einzelpreis 12,50 und Gesamtpreis 37,50. liefertermin bleibt null. Zusätzliche Schlüssel, Zeichenketten statt Zahlen und erfundene Termine bestehen die Prüfung nicht. Der Prüfer bestätigt nur diese konkrete Aufgabe.
Zweites Beispiel
Beispiel: Überschneidung zweier Termine berechnen
Praxisergänzung geprüft am 22. Oktober 2026 · eigene Aufgabe, kein Modellbenchmark
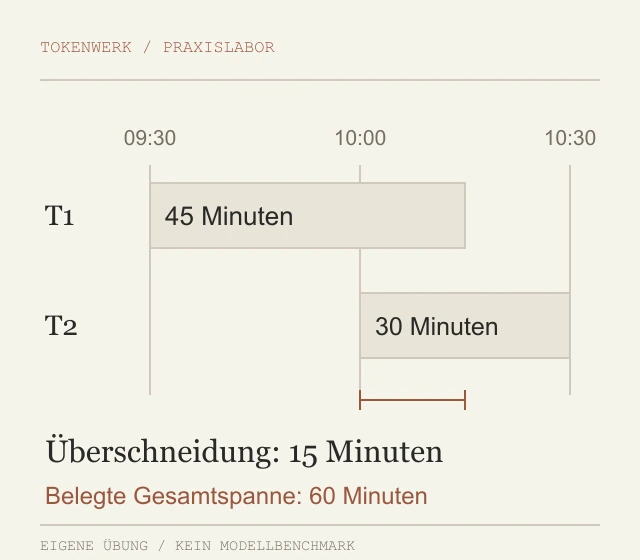
Zwei fiktive Termine liegen teilweise zur selben Zeit. Addiere die Dauern nicht ungeprüft: Die gemeinsame Zeit zählt bei der tatsächlich belegten Gesamtspanne nur einmal. Du kannst die Aufgabe zunächst auf dem eigenen Zeitstrahl nachvollziehen und danach eine Modellantwort daran prüfen.
Vorbereitung
Mistral dokumentiert Ministral 3 14B Instruct als Modell mit Text- und Bildverständnis. Base-, Instruct- und Reasoning-Varianten sind eigene Checkpoints. Diese Textprobe bezieht sich auf die Instruct-Variante; sie verlangt weder Kalenderzugriff noch Werkzeugaufrufe. Verwende die passende Laufzeit und Formatierung. Eine kleine Rechenaufgabe ersetzt keinen Vergleich der Varianten oder ihrer Hardwareanforderungen.
Halte Modellversion, gewählten Zugang und Einstellungen fest. Nutze nur die fiktiven Angaben dieser Vorlage.
Bearbeite die Aufgabe und speichere den geforderten JSON-Teil unverändert als antwort.json. Bei einer freien Antwort erstellst du den Prüfteil selbst und kennzeichnest das.
Vergleiche mit dem Soll und prüfe mindestens einen veränderten Eingabefall. Ein bestandener Beispielsatz ersetzt keine Abnahme auf deinen eigenen Daten.
Aufgabe
Die Angaben sind fiktiv. Speichere den geforderten JSON-Teil der Antwort separat als antwort.json; zusätzliche Erklärungen gehören in eine andere Datei.
Fiktiver Plan, alle Uhrzeiten am selben Tag und in derselben Zeitzone. T1 beginnt 09:30 und dauert 45 Minuten. T2 beginnt 10:00 und dauert 30 Minuten. JSON: ende_t1 (HH:MM), ende_t2 (HH:MM), ueberlappung_minuten, belegte_gesamtspanne_minuten. Die Gesamtspanne zählt gleichzeitige Minuten nur einmal. Keine Kalenderaktion ausführen.Vorlage herunterladenLokalen JSON-Prüfer herunterladen
Lösung und Prüfkriterien
- T1 endet um 10:15, T2 um 10:30.
- Die gemeinsame Zeit reicht von 10:00 bis 10:15.
- 45 plus 30 Minuten ergeben 75 Einzelminuten, aber nur 60 unterschiedlich belegte Minuten.
{
  "ende_t1": "10:15",
  "ende_t2": "10:30",
  "ueberlappung_minuten": 15,
  "belegte_gesamtspanne_minuten": 60
}Das Soll ist redaktionell aus der Vorlage abgeleitet, keine aufgezeichnete Modellantwort. Der lokale Prüfer vergleicht die festgelegten Felder und führt keinen generierten Code oder API-Aufruf aus. Er bewertet keine freien Begründungen.
Speichere Prüfer und deine Antwort im selben Ordner. Mit installiertem Python: python pruefen.py antwort.json.
| Beobachtung | Was du prüfst |
|---|---|
| Die Gesamtspanne ist 75 Minuten | Ziehe die doppelt gezählten 15 Minuten ab. |
| Die Überschneidung beginnt 09:30 | Zu diesem Zeitpunkt hat T2 noch nicht begonnen. |
| Die Aufgabe verändert einen Kalender | Die Vorlage ist eine Textprobe ohne verbundenes Kalenderwerkzeug. |
Passende Anleitungen
Wie du einen eigenen kleinen Versuch abgrenzt, zeigt eine Alltagsaufgabe mit klaren Kriterien vorbereiten.
Wenn daraus später ein echter Kalenderablauf werden soll, hilft dir Modell und Werkzeug passend zur Aufgabe wählen beim Trennen von Textantwort und Aktion.
Gezielte Praxisergänzung auf Basis aktueller Herstellerunterlagen. Der Datenstand der bisherigen Modell-Faktentabellen bleibt separat ausgewiesen. Neue Beispiele und Grafiken sind eigene Erklärungen; es wurden keine Modellantworten oder Leistungswerte gemessen.
Herstellerunterlagen zur Ergänzung: Ministral 3 14B Instruct 2512 (Abruf 2026-10-22) · Ministral 3 14B - Mistral AI | Mistral Docs (Abruf 2026-10-22).
Quellen und Prüfstand
Die Modellangaben und Preise wurden am 24. Oktober 2026 mit den folgenden Herstellerunterlagen abgeglichen. Die Preise sind in US-Dollar angegeben und können sich ändern. Die Grafiken und Aufgaben stammen von Tokenwerk. Sollantworten sind aus den Beispielen abgeleitet, keine gemessenen Modellantworten.
Häufige Fragen
Welche Ministral-3-14B-Variante soll ich zum Einstieg nehmen?
Für einen angeleiteten Chat- oder Extraktionsversuch ist Instruct der hier verwendete Einstieg. Base richtet sich an Weitertraining und Anpassung. Reasoning ist ein separater Checkpoint für einen eigenen Versuchsplan mit mehrstufigen Aufgaben. Notiere den vollständigen Namen einschließlich 2512.
Reichen 16 oder 24 GB Speicher für Ministral 3 14B?
Das lässt sich aus der Gewichtegröße allein nicht zusagen. Der Rechner zeigt nur eine theoretische Untergrenze. Kontextcache, Bilder, Laufzeit und Parallelität kommen hinzu. Die Instruct-Karte beschreibt ein FP8-Szenario mit einer 24-GB-GPU; andere Formate und Laufzeiten verändern den Bedarf.
Kann Ministral 3 14B Bilder verarbeiten?
Ja. Die dokumentierte Familie nimmt Text und Bilder entgegen und erzeugt Text. Ob dein konkreter lokaler Server Bilder korrekt annimmt, hängt zusätzlich von Laufzeit, Template und gewähltem Checkpoint ab.
Hat Ministral 3 14B immer 256K Kontext?
Mistral nennt 256K; die offizielle Instruct-2512-Konfiguration enthält 262144 Positionen. Ein Hoster kann andere Grenzen setzen; die untersuchte AWS-Dokumentation beschreibt 128K Kontext und 8K Ausgabe. Prüfe daher die Grenze des konkreten Zugangs statt nur den Familiennamen.
Was kostet die Mistral-API für dieses Modell?
Die am 24. Oktober 2026 gelesene Preisseite nennt für Ministral 3 14B jeweils 0,20 US-Dollar pro Million Eingabe- und Ausgabetokens sowie 0,02 US-Dollar für tatsächlich gecachte Eingabetokens. Das sind API-Preise, keine lokalen Hardwarekosten. Andere Hoster haben eigene Tarife.
Hat Tokenwerk die Modellantworten dieser Übungen selbst gemessen?
Nein. Die Sollwerte sind redaktionell aus den fiktiven Vorlagen abgeleitet. Die lokalen Prüfer wurden mit passenden und fehlerhaften Dateien getestet. Daraus wird keine gemessene Qualität, Geschwindigkeit oder Erfolgsquote von Ministral abgeleitet.
Warum startet die Vorlage mit 8192 statt dem maximalen Kontext?
8192 ist ein bewusst kleineres Startlimit für Prompt und Ausgabe zusammen. Es ist keine Modellgrenze und keine Zusage, dass dein Rechner genügend Speicher hat. Notiere den tatsächlich gestarteten Wert und erhöhe ihn erst nach einem eigenen Speichertest. Zur lokalen Startvorlage.