 Embeddings
Gemini Embedding 2
Gemini Embedding 2 ist ein Embedding-Modell von Google DeepMind. Gemini embedding 2: Text, Bild, Video, Audio, PDF → Text embeddings. Für semantische Suche und Retrieval.
Nutze den in den Quellen genannten Anbieterzugang für genau diese Version. Ein Produktabo enthält nicht automatisch API-Guthaben.
Aktiv · stabilQuellenstand 2026-10-13
Google DeepMind im Verzeichnis
Technische Daten
Identität, Funktionen und Betrieb getrennt lesen. Die Angaben beziehen sich auf diese konkrete Version.
„Nicht bestätigt“ kennzeichnet eine offene Angabe. Es bedeutet weder „nicht vorhanden“ noch „unbegrenzt“.
| Hersteller | Google DeepMind |
|---|---|
| Modellfamilie | Gemini |
| Modell-/API-ID | gemini-embedding-2 |
| Status | Aktiv · stabil |
| Modellart | Embeddings |
|---|---|
| Eingabe | Text, Bild, Video, Audio, PDF |
| Ausgabe | Embedding-Vektoren |
| Kontext | 8.192 Tokens |
|---|---|
| Maximaler Output / Horizont | Nicht bestätigt |
| Bereitstellung | Gehosteter Zugang |
|---|---|
| Gewichte | Gehosteter oder integrierter Zugang |
| Lizenz | Anbieterbedingungen |
Daten im Überblick
Die Grafik zeigt die im Profil dokumentierten Grenzen. Kontext und maximale Ausgabe sind keine addierbaren Budgets und keine Qualitätsbewertung. Zusätzliche Bedingungen stehen im Datenblatt.
- Kontext
- 8.192 Tokens
- Maximaler Output / Horizont
- Nicht bestätigt
Datenbasis: Herstellerangaben im Quellenstand 2026-10-13. Quellen zu diesem Profil ↓

Einsatz und Grenzen
Embeddings sind Vektoren für Ähnlichkeit und Retrieval. Nutze dieselben Dokumente und Suchfragen, halte Dimension und Vorverarbeitung fest und bewerte relevante Treffer. Die Grundlagen zu Vektordatenbanken erklären, wie solche Repräsentationen bei der Suche verwendet und passende Treffer geprüft werden.
Prüfe vor einem API-Aufruf, ob dein Konto Zugriff hat und welchen Endpunkt, Tarif und welche Region du verwenden musst. Notiere die genaue Modellversion. Ein Kurzname in der API kann später auf einen anderen Modellstand verweisen.
Leistung: Wir haben die Leistung dieses Modells hier nicht selbst gemessen. Nutze die Aufgabe unten, um es an deinen Anforderungen zu prüfen.
Was kostet Gemini Embedding 2?
Tarife und Zugang vor Nutzung in der Anbieterquelle prüfen.
Zugang: Gehosteter Zugang. Prüfe vor einer Integration die für dein Konto und deine Region verfügbaren Endpunkte. Ein Eintrag im öffentlichen Katalog ist keine Bestätigung eines freigeschalteten Kontos.
Praxis: Bild- und Textvektoren richtig zuordnen
Praxisergänzung geprüft am 22. Oktober 2026 · eigene Aufgabe, kein Modellbenchmark
Für eine multimodale Suche musst du zuerst entscheiden, welche Inhalte gemeinsam einen Suchgegenstand bilden. Ein Bild und seine Beschreibung können zusammen eingebettet werden. Zwei getrennte Dokumente brauchen dagegen einzeln zuordenbare Ergebnisse. Diese Planungsaufgabe prüft die Gruppierung vor einem kostenpflichtigen Modellaufruf.
Vorbereitung
Google dokumentiert gemini-embedding-2 für Text, Bild, Video, Audio und PDF mit Vektorausgabe. Im Abschnitt Embedding aggregation unterscheidet die Dokumentation mehrere Teile in einem gemeinsamen Content von mehreren getrennten Content-Objekten. Die Ausgabe ist kein Antworttext. Halte Modell, Dimension und die Zuordnung zu Quelldateien fest; eine neue Modellversion passt nicht automatisch zu einem älteren Suchindex.
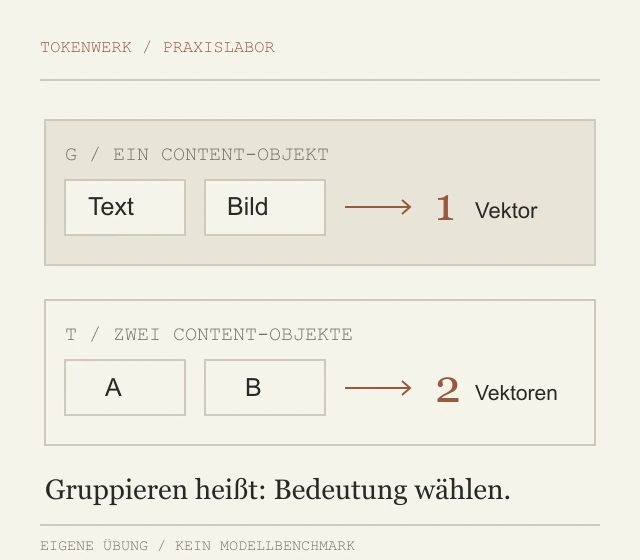
Lies die Herstellerabgrenzung und bearbeite die fiktive Vorlage zuerst von Hand. Diese Trockenübung braucht keinen API-Aufruf.
Speichere deine Kontrollwerte als antwort.json. Das ist eine eigene Rechen- oder Planungsantwort, kein behaupteter Modelloutput.
Vergleiche mit dem Soll und verändere einen Grenzfall. Prüfe echte Modellantworten und produktive Abläufe später gesondert.
Aufgabe zum Kopieren
Die Angaben sind fiktiv. Speichere den geforderten JSON-Teil der Antwort separat als antwort.json; zusätzliche Erklärungen gehören in eine andere Datei.
Offline-Planung, nicht als Chatprompt an den Embedding-Endpunkt senden. Fall G: Ein einzelnes Content-Objekt enthält Beschreibung und Bild desselben fiktiven Geräts. Fall T: Zwei getrennte Content-Objekte enthalten Dokument A und Dokument B. Nach der dokumentierten Gruppierungsregel entsteht je Content-Objekt ein Vektor. JSON: g_vektoren, t_vektoren, gesamt_vektoren, g_gemeinsam (bool). Berechne keine tatsächlichen Vektorwerte.Vorlage herunterladenLokalen JSON-Prüfer herunterladen
Lösung und Prüfkriterien ansehen
- G steht für eine gemeinsame Repräsentation von Bild und Beschreibung.
- T bewahrt zwei getrennt zuordenbare Dokumentrepräsentationen.
- Die Anzahl lässt sich aus der Gruppierung planen; konkrete Vektorwerte entstehen erst durch eine tatsächliche Berechnung.
{
  "g_vektoren": 1,
  "t_vektoren": 2,
  "gesamt_vektoren": 3,
  "g_gemeinsam": true
}Das Soll ist redaktionell aus der Vorlage abgeleitet, keine aufgezeichnete Modellantwort. Der lokale Prüfer vergleicht die festgelegten Felder und führt keinen generierten Code oder API-Aufruf aus. Er bewertet keine freien Begründungen.
Speichere Prüfer und deine Antwort im selben Ordner. Mit installiertem Python: python pruefen.py antwort.json.
| Beobachtung | Was du prüfst |
|---|---|
| Jeder Teil von G erhält automatisch einen eigenen Vektor | Unterscheide Parts innerhalb eines Content-Objekts von getrennten Content-Objekten. |
| A und B werden zu einem Treffer verschmolzen | Prüfe, ob die Anfrage tatsächlich getrennte Objekte enthält. |
| Eine Vektorzahl wird als Suchqualität interpretiert | Die Anzahl sagt nichts darüber aus, welche Treffer für deine Aufgabe relevant sind. |
Passende Anleitungen
Wie die einzelnen Dokumentrepräsentationen in einen prüfbaren Ablauf passen, lernst du unter Dokumentabruf und Antwort getrennt prüfen.
Ein konkreter nächster Einstieg ist einen RAG-Ablauf mit Embeddings nachvollziehen. Der Guide zeigt einen eigenen Betriebsweg; er behauptet keine Austauschbarkeit unterschiedlicher Embeddingmodelle.
Gezielte Praxisergänzung auf Basis aktueller Herstellerunterlagen. Der Datenstand der bisherigen Modell-Faktentabellen bleibt separat ausgewiesen. Neue Beispiele und Grafiken sind eigene Erklärungen; es wurden keine Modellantworten oder Leistungswerte gemessen.
Herstellerunterlagen zur Ergänzung: Embeddings | Gemini API | Google AI for Developers (Abruf 2026-10-22) · Gemini Embedding 2 model | Gemini API | Google AI for Developers (Abruf 2026-10-22).
Quellen und Prüfstand
Quellenstand: 2026-10-13. Spezifikationen, Tarife und Zugang können sich ändern. Die Illustration zeigt den dokumentierten Datenweg, keine gemessene Leistung.
Häufige Fragen
Was ist Gemini Embedding 2?
Gemini embedding 2: Text, Bild, Video, Audio, PDF → Text embeddings. Für semantische Suche und Retrieval. Hersteller: Google DeepMind. Dokumentierte ID: gemini-embedding-2.
Was verarbeitet Gemini Embedding 2?
Eingabe: Text, Bild, Video, Audio, PDF. Ausgabe: Embedding-Vektoren. Maßgeblich sind die Funktionen des konkreten Endpunkts in der Herstellerquelle.
Kannst du Gemini Embedding 2 lokal betreiben?
Der dokumentierte Zugang lautet: Gehosteter Zugang. Öffentlich verfügbare offene Gewichte werden damit nicht bestätigt. Ein integriertes On-Device-Modell kann besondere Hardware und Plattformvorgaben haben.
Was kostet Gemini Embedding 2?
Kein bestätigter Einheitspreis im geprüften Quellenstand. Tarife und Zugang vor Nutzung in der Anbieterquelle prüfen. Bei selbst betriebenen Gewichten kommen Hardware- und Betriebskosten hinzu.
Ist das ein Leistungstest oder eine Rangliste?
Nein. Das Profil dokumentiert Herstellerangaben mit Quellenstand 2026-10-13. Die Testidee ist redaktionell formuliert und wurde hier nicht ausgeführt; sie ist keine Qualitätsgarantie.
Wie groß ist das Kontextfenster von Gemini Embedding 2?
Im dokumentierten Quellenstand: 8.192 Tokens. Beachte die Bedingungen der konkreten Modellversion und des verwendeten Endpunkts. Kontext ist keine Wortzahl und kein Nachweis, dass jede enthaltene Information zuverlässig verarbeitet wird.
Wie prüfst du Gemini Embedding 2 für deine Aufgabe?
Lege eine kleine Aufgabe mit bekanntem oder nachprüfbarem Ergebnis fest. Notiere Version, Eingabe und Einstellungen. Vergleiche die Ausgabe mit deinem Prüfkriterium und halte Fehler sowie tatsächliche Kosten getrennt fest. Die Testidee auf dieser Seite ist ein Vorschlag und wurde hier nicht als Modelltest ausgeführt.
Antwortet Gemini Embedding 2 auf eine Frage wie ein Chatmodell?
Das Modell erzeugt numerische Repräsentationen. Suche, Auswahl von Treffern und eine gegebenenfalls anschließende Textantwort sind weitere Schritte deiner Anwendung.
Sind Bild und Beschreibung immer ein gemeinsamer Vektor?
Das hängt von der Gruppierung ab. Die Herstellerdokumentation unterscheidet mehrere Teile eines Content-Objekts von mehreren getrennten Content-Objekten.
Erzeugt die Planungsübung echte Embeddings?
Nein. Sie zählt die vorgesehenen Repräsentationen aus einer fiktiven Eingabestruktur. Es wurden keine Bilddaten hochgeladen und keine Vektorwerte gemessen.