Text & Reasoning
Command A
Command A ist ein Text & Reasoning-Modell von Cohere. Eingabe: Text. Ausgabe: Text.
Technologie verstehen.
Besser entscheiden.
 Text & Reasoning
Command A+ ist ein Sprachmodell von Cohere. Für die Auswahl zählen deine Aufgabe, die unterstützten Eingaben und der konkrete Zugang. Das Praxisbeispiel hilft dir, eine Antwort selbst zu prüfen.
Wenn du lokal arbeiten möchtest, prüfe zuerst Lizenz, passende Laufzeit und den Speicherbedarf deiner Modellvariante. Offene Gewichte allein sagen noch nicht, ob dein Rechner dafür ausreicht.
Aktuell im HerstellerkatalogQuellenstand 2026-10-13
Cohere im Verzeichnis
Identität, Funktionen und Betrieb getrennt lesen. Die Angaben beziehen sich auf diese konkrete Version.
„Nicht bestätigt“ kennzeichnet eine offene Angabe. Es bedeutet weder „nicht vorhanden“ noch „unbegrenzt“.
| Hersteller | Cohere |
|---|---|
| Modellfamilie | Command · North · Aya |
| Modell-/API-ID | command-a-plus-05-2026 |
| Status | Aktuell im Herstellerkatalog |
| Modellart | Text & Reasoning |
|---|---|
| Eingabe | Text, Bild |
| Ausgabe | Text |
| Kontext | 128.000 Tokens |
|---|---|
| Maximaler Output / Horizont | 64.000 Tokens |
| Bereitstellung | Offene Gewichte; API zusätzlich prüfen |
|---|---|
| Gewichte | Offene Gewichte dokumentiert |
| Lizenz | Apache 2.0 |
Die Grafik zeigt die im Profil dokumentierten Grenzen. Kontext und maximale Ausgabe sind keine addierbaren Budgets und keine Qualitätsbewertung. Zusätzliche Bedingungen stehen im Datenblatt.
Datenbasis: Herstellerangaben im Quellenstand 2026-10-13. Quellen zu diesem Profil ↓

Command A+ ist ein Text & Reasoning-Modell von Cohere. Eingabe: Text, Bild. Ausgabe: Text.
Wähle eine kleine Aufgabe mit einer überprüfbaren Lösung: etwa fünf Informationen aus einem gegebenen Dokument extrahieren. Prüfe die Antworten am Original, nicht nur die Formulierung.
Vor einem lokalen Test zuerst Gewichteformat, Lizenz, Arbeitsspeicher und unterstützte Runtime prüfen. Notiere die genaue Modellversion. Ein Kurzname in der API kann später auf einen anderen Modellstand verweisen. Der Auswahlguide für lokale KI-Modelle vertieft die Prüfung von Aufgabe, Gewichteformat, Speicher und Lizenz vor einem eigenen Versuch.
Lokaler Betrieb: Verfügbare Gewichte allein belegen nicht, dass dieses Modell auf deinem Rechner läuft. Speicherbedarf, Quantisierung, Kontext und unterstützte Hardware müssen zusammenpassen.
Leistung: Wir haben die Leistung dieses Modells hier nicht selbst gemessen. Nutze die Aufgabe unten, um es an deinen Anforderungen zu prüfen.
Tarife und Zugang vor Nutzung in der Anbieterquelle prüfen.
Zugang: Offene Gewichte; API zusätzlich prüfen. Prüfe vor einer Integration die für dein Konto und deine Region verfügbaren Endpunkte. Ein Eintrag im öffentlichen Katalog ist keine Bestätigung eines freigeschalteten Kontos.
Praxisergänzung geprüft am 22. Oktober 2026 · eigene Aufgabe, kein Modellbenchmark
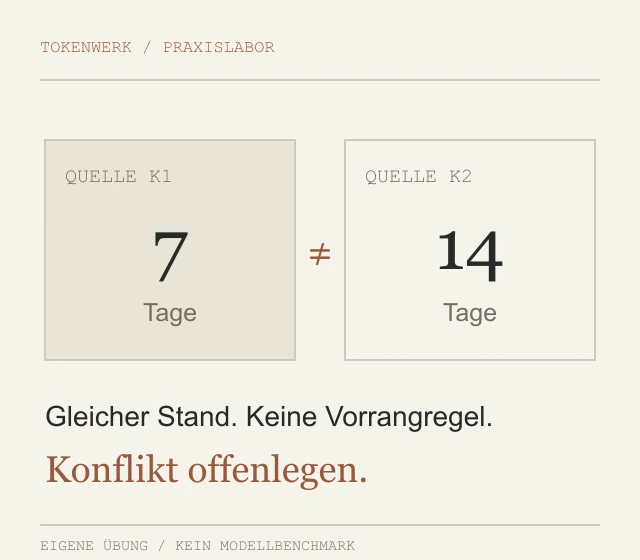
Ein Antwortmodell soll nicht jede Lücke mit einer eindeutigen Aussage füllen. Unsere beiden fiktiven Unterlagen tragen denselben Geltungsbereich und denselben Freigabestand, nennen aber unterschiedliche Fristen. Es gibt keine Prioritätsregel, die den Konflikt auflöst. Die hilfreiche Antwort macht genau diesen Konflikt sichtbar und bewahrt beide Belege.
Cohere dokumentiert Command A+ für Text- und Bildeingaben sowie dokumentengestützte Anwendungen. Die Modell-ID lautet command-a-plus-05-2026. Hersteller-API, Model Vault und eigener Betrieb sind verschiedene Zugänge mit eigenen Voraussetzungen. Die Übung nutzt nur Text und einfache Quellen-IDs. Diese IDs sind unsere Kontrollhilfe und kein behaupteter Nachweis für ein bestimmtes API-Zitationsformat.
Halte Modellversion, gewählten Zugang und Einstellungen fest. Nutze nur die fiktiven Angaben dieser Vorlage.
Bearbeite die Aufgabe und speichere den geforderten JSON-Teil unverändert als antwort.json. Bei einer freien Antwort erstellst du den Prüfteil selbst und kennzeichnest das.
Vergleiche mit dem Soll und prüfe mindestens einen veränderten Eingabefall. Ein bestandener Beispielsatz ersetzt keine Abnahme auf deinen eigenen Daten.
Die Angaben sind fiktiv. Speichere den geforderten JSON-Teil der Antwort separat als antwort.json; zusätzliche Erklärungen gehören in eine andere Datei.
Beantworte die Frage nur aus den fiktiven Quellen: Wie viele Tage gilt die Freigabe für Projekt N?
K1: Freigegebene Richtlinie, Version 2, gültig für Projekt N: Die Freigabe gilt 7 Tage.
K2: Freigegebene Richtlinie, Version 2, gültig für Projekt N: Die Freigabe gilt 14 Tage.
Es gibt keine Vorrangregel und kein genaueres Datum. JSON: tage (bei unaufgelöstem Konflikt null), konflikt (bool), belege (alphabetisch sortierte IDs). Keine Quelle willkürlich bevorzugen.Vorlage herunterladenLokalen JSON-Prüfer herunterladen
{
  "tage": null,
  "konflikt": true,
  "belege": [
    "K1",
    "K2"
  ]
}Das Soll ist redaktionell aus der Vorlage abgeleitet, keine aufgezeichnete Modellantwort. Der lokale Prüfer vergleicht die festgelegten Felder und führt keinen generierten Code oder API-Aufruf aus. Er bewertet keine freien Begründungen.
Speichere Prüfer und deine Antwort im selben Ordner. Mit installiertem Python: python pruefen.py antwort.json.
| Beobachtung | Was du prüfst |
|---|---|
| Der Mittelwert 10,5 wird ausgegeben | Eine Richtlinienfrage wird nicht durch Mitteln widersprüchlicher Angaben gelöst. |
| K2 gewinnt, weil sie zuletzt steht | Listenreihenfolge ist keine dokumentierte Vorrangregel. |
| Eine Quelle verschwindet | Bewahre beide Fundstellen, damit die widersprüchliche Aussage nachvollziehbar bleibt. |
Wie Suche und Antwort zusammenarbeiten, erklärt einen RAG-Chatbot mit überprüfbaren Quellen bauen.
Wenn eine Antwort den Widerspruch verdeckt, hilft dir KI-Halluzinationen erkennen und prüfen beim Prüfen von Behauptung und Beleg.
Gezielte Praxisergänzung auf Basis aktueller Herstellerunterlagen. Der Datenstand der bisherigen Modell-Faktentabellen bleibt separat ausgewiesen. Neue Beispiele und Grafiken sind eigene Erklärungen; es wurden keine Modellantworten oder Leistungswerte gemessen.
Herstellerunterlagen zur Ergänzung: Cohere's Command A+ Model | Cohere (Abruf 2026-10-22) · An Overview of Cohere's Models | Cohere (Abruf 2026-10-22).
Quellenstand: 2026-10-13. Spezifikationen, Tarife und Zugang können sich ändern. Die Illustration zeigt den dokumentierten Datenweg, keine gemessene Leistung.
Command A+ ist ein Text & Reasoning-Modell von Cohere. Eingabe: Text, Bild. Ausgabe: Text. Hersteller: Cohere. Dokumentierte ID: command-a-plus-05-2026.
Eingabe: Text, Bild. Ausgabe: Text. Maßgeblich sind die Funktionen des konkreten Endpunkts in der Herstellerquelle.
Offene Gewichte sind dokumentiert. Die Lizenz Apache 2.0, unterstützte Runtime und benötigte Hardware musst du zusätzlich prüfen.
API-Evaluation kostenlos bis zum Rate-Limit; Produktion über Model Vault. Tarife und Zugang vor Nutzung in der Anbieterquelle prüfen. Bei selbst betriebenen Gewichten kommen Hardware- und Betriebskosten hinzu.
Nein. Das Profil dokumentiert Herstellerangaben mit Quellenstand 2026-10-13. Die Testidee ist redaktionell formuliert und wurde hier nicht ausgeführt; sie ist keine Qualitätsgarantie.
Im dokumentierten Quellenstand: 128.000 Tokens. Beachte die Bedingungen der konkreten Modellversion und des verwendeten Endpunkts. Kontext ist keine Wortzahl und kein Nachweis, dass jede enthaltene Information zuverlässig verarbeitet wird.
Lege eine kleine Aufgabe mit bekanntem oder nachprüfbarem Ergebnis fest. Notiere Version, Eingabe und Einstellungen. Vergleiche die Ausgabe mit deinem Prüfkriterium und halte Fehler sowie tatsächliche Kosten getrennt fest. Die Testidee auf dieser Seite ist ein Vorschlag und wurde hier nicht als Modelltest ausgeführt.
Das wird hier nicht behauptet. Die Vorlage hat einen bewusst deutlichen Widerspruch und wurde nicht als Modellbenchmark ausgeführt.
Nein. Es sind einfache Dokumentkennungen für diese redaktionelle Übung. Eine API-Integration muss ihr tatsächliches Zitationsformat getrennt prüfen.
Die Vorlage liefert zwei widersprüchliche, gleichrangige Angaben. Ohne zusätzliche Klärung wäre eine einzelne Zahl unbelegt.
Text & Reasoning
Command A ist ein Text & Reasoning-Modell von Cohere. Eingabe: Text. Ausgabe: Text.
Text & Reasoning
Command A Reasoning ist ein Text & Reasoning-Modell von Cohere. Eingabe: Text. Ausgabe: Text.
Text & Reasoning
Command A Translate ist ein Text & Reasoning-Modell von Cohere. Eingabe: Text. Ausgabe: Text.