Trenne eine sichtbare Erklärung vom internen Rechenprozess des Modells. Schreibe klare Aufgaben, erhalte fehlende Angaben als offen und prüfe das Ergebnis unabhängig. Die Länge einer Begründung ist kein Qualitätsmaß.
Was Chain-of-Thought-Prompting bezeichnet
Der englische Begriff bedeutet ungefähr „Gedankenkette“. In einem klassischen Promptbeispiel werden nicht nur Aufgabe und Endantwort gezeigt, sondern auch Zwischenschritte. Eine ähnliche neue Aufgabe soll dadurch in mehreren passenden Schritten bearbeitet werden.
Das historische Muster ist leicht zu verstehen: Ein vorgerechnetes Beispiel kann zeigen, welche Angaben zusammengehören und wie das gewünschte Ausgabeformat aussieht. Die gelesenen Einführungen nutzen dafür unter anderem einfache Rechenaufgaben. Sie beziehen sich teilweise auf frühere Modellgenerationen und damalige Untersuchungen.
Solche historischen Angaben lassen sich nicht unverändert auf jedes aktuelle Modell übertragen. Insbesondere ist daraus keine allgemeine Mindestzahl von Modellparametern, keine feste Erfolgsquote und keine Garantie für mehr Richtigkeit abzuleiten. Auch „mindestens fünf Schritte“ ist kein sinnvoller Standard für jede Aufgabe.
Was sich bei Reasoning-Modellen ändert
Reasoning-Modelle bearbeiten bestimmte Aufgaben mit einem dafür vorgesehenen internen Prozess. In der gelesenen OpenAI-Empfehlung sind einfache, direkte Prompts und klare Erfolgskriterien der Ausgangspunkt. Zusätzliche Aufforderungen wie „think step by step“ sind dort nicht notwendig und können die Leistung auch beeinträchtigen.
Beginne deshalb mit Aufgabe, Eingabematerial, Grenzen und Ausgabeformat. Probiere zunächst eine klare Anweisung ohne lange Beispielsammlung. Beispiele können sinnvoll sein, wenn sie ein tatsächlich benötigtes Format oder schwierige Grenzfälle zeigen. Sie müssen zur Aufgabe passen und dürfen der Anweisung nicht widersprechen.
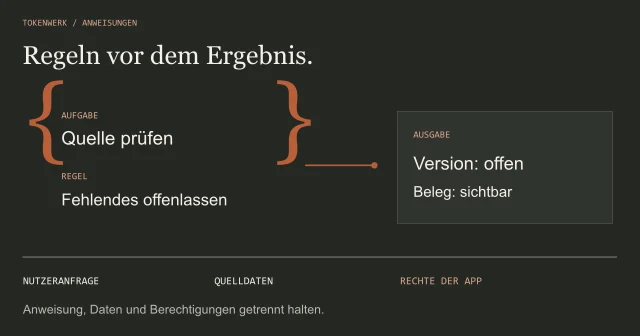
Du solltest außerdem Aufgaben und Systemanweisungen unterscheiden. Ein sichtbares Wort wie „System“ in einem Chattext verleiht diesem Text keine besondere technische Rolle. Ebenso ersetzt die Forderung nach sorgfältiger Arbeit keine technische Berechtigung.
Diese Aussagen sind keine aktuelle Rangliste einzelner Modellfamilien. Die OpenAI-Referenz enthält auch ältere o1-/o3-Beispiele. Für konkrete Modellwahl und API-Einstellungen sind die jeweils passenden aktuellen Unterlagen maßgeblich.
Erklärung, Zusammenfassung und internen Prozess trennen
| Ebene | Was du daraus ableiten kannst |
|---|---|
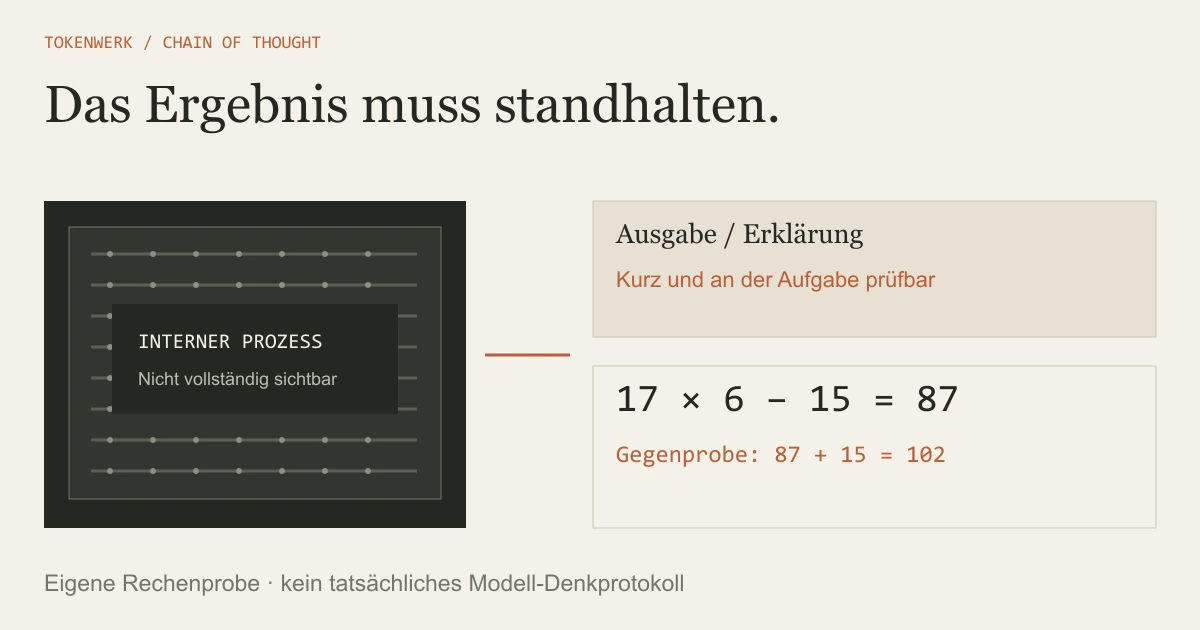
| Interner Prozess | Er ist nicht vollständig als normaler Antworttext sichtbar. |
| Sichtbare Erklärung oder Zusammenfassung | Sie kann beim Verstehen helfen, beweist aber nicht jeden internen Verarbeitungsschritt. |
| Prüfbarer Ergebnisnachweis | Rechnung, Quelle oder Test kann unabhängig mit der Aufgabe abgeglichen werden. |
Die Gemini-Thinking-Dokumentation unterscheidet beispielsweise interne Thinking-Schritte, optionale Zusammenfassungen und verschlüsselte Signaturen. Eine Zusammenfassung ist nicht der vollständige interne Zustand. Eine Signatur ist wiederum kein Text, den man als gewöhnliche Erklärung lesen kann.
Auch eine ausführliche sichtbare Begründung kann einen falschen Schluss enthalten. Deshalb solltest du plausible KI-Fehler und Halluzinationen erkennen, statt Selbstsicherheit oder Textlänge als Beleg zu nehmen. Für die Belegfrage trennt Quellen in KI-Antworten Trainingswissen, bereitgestellte Dokumente und Websuche.
Für Lernaufgaben ist ein kurzer Lösungsweg nützlich, wenn er tatsächlich überprüfbare Schritte zeigt. Dazu brauchst du keine angeblich vollständige Offenlegung eines verborgenen Denkprotokolls.

Eine Rechenaufgabe mit kurzer Gegenprobe
Unsere eigene Aufgabe lautet: 17 Packungen enthalten jeweils sechs Teile. 15 Teile werden entnommen. Wie viele bleiben? Das Sollresultat lässt sich direkt nachrechnen: 17 × 6 = 102, anschließend 102 − 15 = 87. Als Gegenprobe gilt 87 + 15 = 102.
Eigene Aufgabe mit knappem Ergebnisnachweis
17 Packungen enthalten jeweils 6 Teile. 15 Teile werden entnommen.
Wie viele Teile bleiben?
Gib das Ergebnis, eine kurze Rechnung und eine passende Gegenprobe aus.
Verwende nur die angegebenen Mengen.Die Rechnung ist hier von uns als Lehrbeispiel vorgegeben. Es handelt sich nicht um die protokollierte Antwort eines getesteten KI-Modells. Du kannst eine eigene Modellantwort daran prüfen: Sind alle Mengen richtig übernommen, stimmen Einheiten und Rechenoperationen und passt die Gegenprobe?
Eine lange Erklärung bringt bei diesem Beispiel keinen zusätzlichen Richtigkeitsbeleg. Ein kurzer Fehler bleibt ein Fehler; ein langer richtiger Text ist nicht automatisch die effizientere Lösung. Entscheidend ist die Aufgabe.
Bei fehlenden Angaben nicht weiterrechnen
Jetzt die Gegenaufgabe: „Ich kaufe 17 Teile und bekomme zehn Prozent Rabatt. Wie viel bezahle ich?“ Ein eindeutiger Geldbetrag ist damit nicht bestimmbar. Der Stückpreis fehlt; außerdem muss klar sein, worauf sich der Rabatt bezieht.
Eigener Fall mit fehlender Eingabe
Ich kaufe 17 Teile und bekomme 10 Prozent Rabatt.
Wie viel bezahle ich?
Wenn eine notwendige Angabe fehlt, benenne sie und frage danach.
Erfinde weder einen Stückpreis noch einen Endbetrag.Eine geeignete Antwort fragt nach dem Preis und der Rabattbasis oder gibt nur eine ausdrücklich bedingte Formel an. „Das Ergebnis fehlt“ ist hier kein Versagen der Prüfung, sondern der richtige Umgang mit unvollständigem Material.
Die eigenen Prüffälle als JSON enthalten die vollständige und die unvollständige Variante samt Sollkriterien. Sie sind keine Modellantworten, API-Konfiguration oder Sammlung interner Gedankengänge.
Promptvarianten nachvollziehbar vergleichen
Wenn du selbst Varianten prüfst, erhalte Eingabe, Modellversion, Einstellungen und Auswertung möglichst gleich. Bewerte Ergebnis, Umgang mit Lücken und Nacharbeit. Ändere nicht gleichzeitig das Modell und die ganze Aufgabenstellung und schreibe den Unterschied dann allein einem Promptwort zu. Die Promptvorlagen mit klaren Prüfkriterien geben dir dafür einen konkreten Ausgangspunkt, ohne einen bestimmten internen Denkprozess vorauszusetzen.
Die verfügbaren Thinking-Einstellungen hängen vom Modell und der API ab. Gemini beschreibt eigene Thinking-Level, Zusammenfassungen und Kosten für erzeugte Thinking-Tokens. Mehr interner Aufwand kann Zeit und Kosten verändern; eine gewünschte lange Erklärung ist damit nicht identisch.
Ein zu knappes Ausgabelimit kann je nach Modell und API auch zu einer unvollständigen Ausgabe führen. Prüfe die dazugehörige Dokumentation und tatsächlichen Nutzungsdaten, statt aus einer leeren Antwort auf fehlende Denkfähigkeit zu schließen.
Der Lernpfad zeigt, wie du Prompts mit überprüfbaren Kriterien aufbauen kannst. Notiere bei einem eigenen Versuch auch Fälle, in denen eine klare direkte Aufgabe bereits genügt.
Stand: 20. Oktober 2026. Historische Einführungen wurden mit Anbieterreferenzen abgeglichen. Die Rechenfälle sind eigene Lehrbeispiele; es wurden keine Modellanfragen oder Leistungstests ausgeführt.
Quellen & Methode
Vorgehen und Grenzen
Originalunterlagen am 20. Oktober 2026 im dokumentierten Umfang gelesen; vier vollständige Haupttexte je Thema verglichen. Eigene Illustrationen, Sollfälle und Kopiervorlagen sind Lernhilfen. Keine echten Modell-, Suchmaschinen- oder Produkttests behauptet.
Bei Recherche, Texterstellung und Grafiken wird KI eingesetzt. Welche eigenen Versuche vorliegen und was nur als Beispiel dient, beschreibt dieser Beitrag. Unser Redaktionsstandard erklärt die Anforderungen an Belege und Berichtigungen.