Text & Reasoning
Qwen3.8 2.4T-A95B
Qwen3.8 2.4T-A95B ist ein Text & Reasoning-Modell von Alibaba / Qwen. Eingabe: Text. Ausgabe: Text.
Technologie verstehen.
Besser entscheiden.
 Text & Reasoning
Qwen3.8 Flash ist ein Sprachmodell von Alibaba / Qwen. Im Alibaba-Cloud-Katalog empfohlenes Qwen-Modell für Textaufgaben und Tool-Aufrufe. Regionale Verfügbarkeit und Tarife unterscheiden sich.
Nutze den in den Quellen genannten Anbieterzugang für genau diese Version. Ein Produktabo enthält nicht automatisch API-Guthaben.
Aktuell im HerstellerkatalogQuellenstand 2026-10-13
Alibaba / Qwen im Verzeichnis
Identität, Funktionen und Betrieb getrennt lesen. Die Angaben beziehen sich auf diese konkrete Version.
„Nicht bestätigt“ kennzeichnet eine offene Angabe. Es bedeutet weder „nicht vorhanden“ noch „unbegrenzt“.
| Hersteller | Alibaba / Qwen |
|---|---|
| Modellfamilie | Qwen |
| Modell-/API-ID | qwen3.8-flash |
| Status | Aktuell im Herstellerkatalog |
| Modellart | Text & Reasoning |
|---|---|
| Eingabe | Text |
| Ausgabe | Text |
| Kontext | 1.000.000 Tokens |
|---|---|
| Maximaler Output / Horizont | Nicht bestätigt |
| Bereitstellung | Gehosteter Zugang |
|---|---|
| Gewichte | Gehosteter oder integrierter Zugang |
| Lizenz | Anbieterbedingungen |
Die Grafik zeigt die im Profil dokumentierten Grenzen. Kontext und maximale Ausgabe sind keine addierbaren Budgets und keine Qualitätsbewertung. Zusätzliche Bedingungen stehen im Datenblatt.
Datenbasis: Herstellerangaben im Quellenstand 2026-10-13. Quellen zu diesem Profil ↓

Wähle eine kleine Aufgabe mit einer überprüfbaren Lösung: etwa fünf Informationen aus einem gegebenen Dokument extrahieren. Prüfe die Antworten am Original, nicht nur die Formulierung. Das Vergleichsblatt für KI-Tools hilft dir, Ergebnis, Datenweg und erforderliche Nacharbeit für dieselbe Aufgabe festzuhalten.
Prüfe vor einem API-Aufruf, ob dein Konto Zugriff hat und welchen Endpunkt, Tarif und welche Region du verwenden musst. Notiere die genaue Modellversion. Ein Kurzname in der API kann später auf einen anderen Modellstand verweisen.
Leistung: Wir haben die Leistung dieses Modells hier nicht selbst gemessen. Nutze die Aufgabe unten, um es an deinen Anforderungen zu prüfen.
Tarife und Zugang vor Nutzung in der Anbieterquelle prüfen.
Zugang: Gehosteter Zugang. Prüfe vor einer Integration die für dein Konto und deine Region verfügbaren Endpunkte. Ein Eintrag im öffentlichen Katalog ist keine Bestätigung eines freigeschalteten Kontos.
Praxisergänzung geprüft am 22. Oktober 2026 · eigene Aufgabe, kein Modellbenchmark
Ein Log-Auszug sieht oft einfacher aus, als er ist. Einheiten werden gemischt, Grenzwerte gelten nur für einzelne Zeilen und ein fehlender Wert wird schnell als null interpretiert. Diese drei fiktiven Einträge geben dir eine kleine Probe für strukturierte Textauswertung. Die Sollwerte folgen allein aus den angegebenen Zahlen.
Alibaba führt qwen3.8-flash als gehostetes Modell für allgemeine Text- und Büroaufgaben. Die Dokumentation nennt strukturierte Ausgabe, aber die genaue Aktivierung und mögliche Kombination mit Thinking hängen vom gewählten API-Weg ab. Für die folgende kleine Vorlage genügt ein bewusst gewählter Chat-Zugang. Notiere Region, Modell-ID und Formatmodus; ein gültiges JSON ist noch keine rechnerisch richtige Antwort.
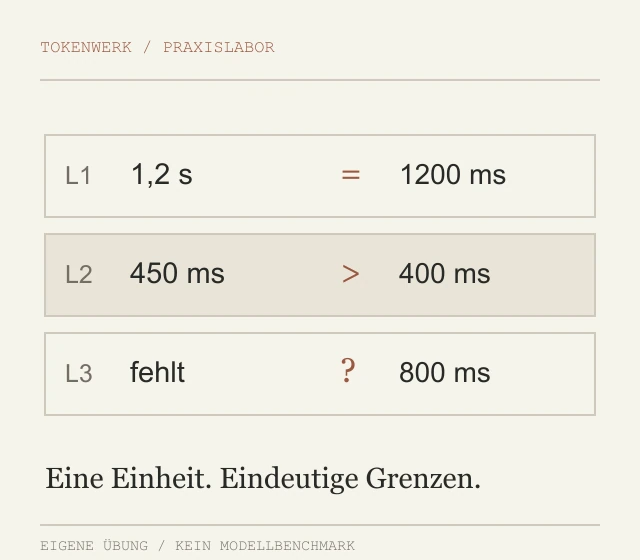
Halte Modellversion, gewählten Zugang und Einstellungen fest. Nutze nur die fiktiven Angaben dieser Vorlage.
Bearbeite die Aufgabe und speichere den geforderten JSON-Teil unverändert als antwort.json. Bei einer freien Antwort erstellst du den Prüfteil selbst und kennzeichnest das.
Vergleiche mit dem Soll und prüfe mindestens einen veränderten Eingabefall. Ein bestandener Beispielsatz ersetzt keine Abnahme auf deinen eigenen Daten.
Die Angaben sind fiktiv. Speichere den geforderten JSON-Teil der Antwort separat als antwort.json; zusätzliche Erklärungen gehören in eine andere Datei.
Normalisiere diese fiktiven Laufzeiten in ganze Millisekunden. 1 Sekunde = 1000 Millisekunden. Zeitlimit überschritten bedeutet strikt größer, nicht gleich.
L1: Laufzeit 1,2 s, Limit 1200 ms
L2: Laufzeit 450 ms, Limit 0,4 s
L3: Laufzeit fehlt, Limit 800 ms
JSON: dauer_ms als Objekt L1/L2/L3 (fehlend null), ueberschritten als sortierte IDs, unbekannt als sortierte IDs. Keine Durchschnittswerte ergänzen.Vorlage herunterladenLokalen JSON-Prüfer herunterladen
{
  "dauer_ms": {
    "L1": 1200,
    "L2": 450,
    "L3": null
  },
  "ueberschritten": [
    "L2"
  ],
  "unbekannt": [
    "L3"
  ]
}Das Soll ist redaktionell aus der Vorlage abgeleitet, keine aufgezeichnete Modellantwort. Der lokale Prüfer vergleicht die festgelegten Felder und führt keinen generierten Code oder API-Aufruf aus. Er bewertet keine freien Begründungen.
Speichere Prüfer und deine Antwort im selben Ordner. Mit installiertem Python: python pruefen.py antwort.json.
| Beobachtung | Was du prüfst |
|---|---|
| L1 überschreitet das Limit | Prüfe die Regel strikt größer und beide Einheiten. |
| L2 wird mit 0,4 verglichen | Rechne erst alle Zeiten in dieselbe Einheit um. |
| L3 erhält null Millisekunden als Zahl | Fehlend ist hier JSON null, nicht die Zahl 0. |
Wenn du die Auswertung in einen Workflow einbaust, zeigt dir JSON-Anfragen mit n8n prüfen den Datenweg von Anfrage zu Statuscode und Antwort.
Wie du Auftrag, Ausgabeformat und Abnahme zusammen formulierst, übst du im Lernpfad Cloud-KI und Prompting.
Gezielte Praxisergänzung auf Basis aktueller Herstellerunterlagen. Der Datenstand der bisherigen Modell-Faktentabellen bleibt separat ausgewiesen. Neue Beispiele und Grafiken sind eigene Erklärungen; es wurden keine Modellantworten oder Leistungswerte gemessen.
Herstellerunterlagen zur Ergänzung: Text generation models - Qwen, DeepSeek, GLM | Model Studio - Alibaba Cloud Model Studio - Alibaba Cloud Documentation Center (Abruf 2026-10-22) · How to make Qwen generate a JSON string - Alibaba Cloud Model Studio - Alibaba Cloud Documentation Center (Abruf 2026-10-22).
Quellenstand: 2026-10-13. Spezifikationen, Tarife und Zugang können sich ändern. Die Illustration zeigt den dokumentierten Datenweg, keine gemessene Leistung.
Im Alibaba-Cloud-Katalog empfohlenes Qwen-Modell für Textaufgaben und Tool-Aufrufe. Regionale Verfügbarkeit und Tarife unterscheiden sich. Hersteller: Alibaba / Qwen. Dokumentierte ID: qwen3.8-flash.
Eingabe: Text. Ausgabe: Text. Maßgeblich sind die Funktionen des konkreten Endpunkts in der Herstellerquelle.
Der dokumentierte Zugang lautet: Gehosteter Zugang. Öffentlich verfügbare offene Gewichte werden damit nicht bestätigt. Ein integriertes On-Device-Modell kann besondere Hardware und Plattformvorgaben haben.
Kein bestätigter Einheitspreis im geprüften Quellenstand. Tarife und Zugang vor Nutzung in der Anbieterquelle prüfen. Bei selbst betriebenen Gewichten kommen Hardware- und Betriebskosten hinzu.
Nein. Das Profil dokumentiert Herstellerangaben mit Quellenstand 2026-10-13. Die Testidee ist redaktionell formuliert und wurde hier nicht ausgeführt; sie ist keine Qualitätsgarantie.
Im dokumentierten Quellenstand: 1.000.000 Tokens. Beachte die Bedingungen der konkreten Modellversion und des verwendeten Endpunkts. Kontext ist keine Wortzahl und kein Nachweis, dass jede enthaltene Information zuverlässig verarbeitet wird.
Lege eine kleine Aufgabe mit bekanntem oder nachprüfbarem Ergebnis fest. Notiere Version, Eingabe und Einstellungen. Vergleiche die Ausgabe mit deinem Prüfkriterium und halte Fehler sowie tatsächliche Kosten getrennt fest. Die Testidee auf dieser Seite ist ein Vorschlag und wurde hier nicht als Modelltest ausgeführt.
Nein. Das sind fiktive Eingabedaten für eine Umrechnungsaufgabe, keine gemessenen Antwortzeiten des Modells.
Nein. Eine Oberfläche mit ausdrücklich gewählter Modellversion reicht für den Textversuch. Für eine Integration prüfst du zusätzlich Region, API-Weg und Formatmodus.
Nein. Ein Formatmodus kann Syntax und Struktur begrenzen. Einheiten, Grenzwerte und fehlende Angaben brauchen eigene Prüfregeln.
Text & Reasoning
Qwen3.8 2.4T-A95B ist ein Text & Reasoning-Modell von Alibaba / Qwen. Eingabe: Text. Ausgabe: Text.
Text & Reasoning
Qwen3.8 27B ist ein Text & Reasoning-Modell von Alibaba / Qwen. Eingabe: Text, Bild, Video. Ausgabe: Text.
Text & Reasoning
Qwen3.8 Flash Next ist ein Text & Reasoning-Modell von Alibaba / Qwen. Eingabe: Text, Bild, Video. Ausgabe: Text.