Text & Reasoning
Grok 4.6
Weiterhin auf dem globalen und US-Endpunkt geführt. US-Verarbeitung kostet 10 % mehr; die Garantie schließt Werkzeuge und Dateien nicht vollständig ein.
Technologie verstehen.
Besser entscheiden.
 Text & Reasoning
Grok 4.7 ist ein Sprachmodell von xAI / SpaceXSI. Für die Auswahl zählen deine Aufgabe, die unterstützten Eingaben und der konkrete Zugang. Das Praxisbeispiel hilft dir, eine Antwort selbst zu prüfen.
Nutze den in den Quellen genannten Anbieterzugang für genau diese Version. Ein Produktabo enthält nicht automatisch API-Guthaben.
Aktuell im HerstellerkatalogQuellenstand 2026-10-13
xAI / SpaceXSI im Verzeichnis
Identität, Funktionen und Betrieb getrennt lesen. Die Angaben beziehen sich auf diese konkrete Version.
„Nicht bestätigt“ kennzeichnet eine offene Angabe. Es bedeutet weder „nicht vorhanden“ noch „unbegrenzt“.
| Hersteller | xAI / SpaceXSI |
|---|---|
| Modellfamilie | Grok |
| Modell-/API-ID | grok-4.7 |
| Status | Aktuell im Herstellerkatalog |
| Modellart | Text & Reasoning |
|---|---|
| Eingabe | Text, Bild |
| Ausgabe | Text |
| Kontext | 500.000 Tokens |
|---|---|
| Maximaler Output / Horizont | Nicht bestätigt |
| Bereitstellung | Gehosteter Zugang |
|---|---|
| Gewichte | Gehosteter oder integrierter Zugang |
| Lizenz | In der Herstellerquelle prüfen |
Input und Output sind getrennte Texttarife je einer Million Tokens. Preisstufen, Cache, Werkzeuge und weitere Bedingungen stehen im Kostenabschnitt. Kein Preis für eine konkrete Aufgabe.
Datenbasis: Herstellerangaben im Quellenstand 2026-10-13. Quellen zu diesem Profil ↓

Grok 4.7 ist ein Text & Reasoning-Modell von xAI / SpaceXSI. Eingabe: Text, Bild. Ausgabe: Text.
Wähle eine kleine Aufgabe mit einer überprüfbaren Lösung: etwa fünf Informationen aus einem gegebenen Dokument extrahieren. Prüfe die Antworten am Original, nicht nur die Formulierung. Das Vergleichsblatt für KI-Tools hilft dir, Ergebnis, Datenweg und erforderliche Nacharbeit für dieselbe Aufgabe festzuhalten.
Prüfe vor einem API-Aufruf, ob dein Konto Zugriff hat und welchen Endpunkt, Tarif und welche Region du verwenden musst. Notiere die genaue Modellversion. Ein Kurzname in der API kann später auf einen anderen Modellstand verweisen.
Leistung: Wir haben die Leistung dieses Modells hier nicht selbst gemessen. Nutze die Aufgabe unten, um es an deinen Anforderungen zu prüfen.
Standardtarif; Werkzeug-, Such- und Verarbeitungskosten können hinzukommen. Regionale Verfügbarkeit separat prüfen.
Textkosten im Rechner schätzen →Zugang: Gehosteter Zugang. Prüfe vor einer Integration die für dein Konto und deine Region verfügbaren Endpunkte. Ein Eintrag im öffentlichen Katalog ist keine Bestätigung eines freigeschalteten Kontos.
Praxisergänzung geprüft am 21. Oktober 2026 · eigene Aufgabe, kein Modellbenchmark
Eine Antwort kann zeitlich plausibel klingen und trotzdem etwas als geschehen darstellen, das nur angekündigt war. Du arbeitest hier mit zwei erfundenen Meldungen. Sie belegen einen Testlauf und einen geplanten Ausbau, aber keinen bereits erfolgten Start des Ausbaus. So übst du Quellenprüfung ohne echte Nachrichten zu erfinden.
Die xAI-Dokumentation beschreibt grok-4.7 als Text- und Reasoning-Modell. Sie warnt außerdem: Aktuelle Ereignisse stehen ohne zugeschaltete Suchwerkzeuge nicht automatisch zur Verfügung. Diese Übung verwendet nur die zwei gelieferten Textquellen und keine Websuche. Ein späterer Live-Check braucht datierte Originalbelege und eine getrennte Prüfung der Suchresultate.
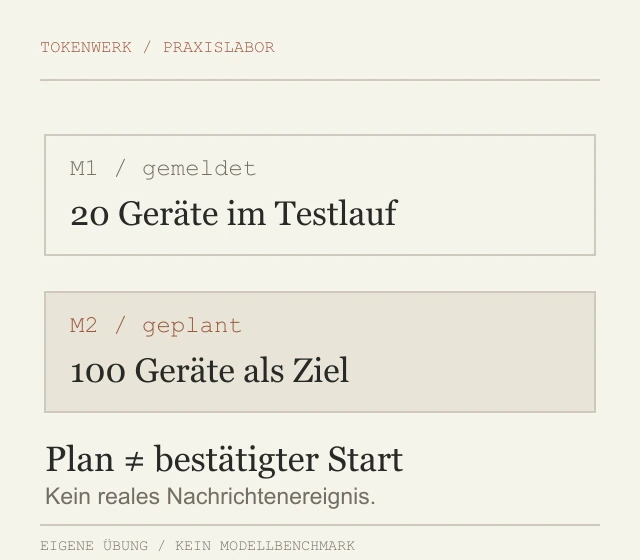
Lies M1 und M2. Unterscheide gemeldetes Ereignis, geplantes Ereignis und fehlende Bestätigung.
Lass die feste JSON-Ausgabe erstellen. Die Aufgabe verbietet zusätzliche Recherche, damit der kleine Versuch reproduzierbar bleibt.
Prüfe Status und Quelle gemeinsam. Für echte aktuelle Nachrichten öffnest du danach die Originalquelle und kontrollierst Veröffentlichungs- sowie Ereignisdatum.
Die Angaben sind fiktiv. Speichere den geforderten JSON-Teil der Antwort separat als antwort.json; zusätzliche Erklärungen gehören in eine andere Datei.
Nur diese fiktiven Meldungen verwenden; keine echten Nachrichten, keine Websuche.
M1, veröffentlicht 10.10.2026: Ein Testlauf startete am 09.10.2026 mit 20 Geräten.
M2, veröffentlicht 12.10.2026: Der Ausbau auf 100 Geräte ist für November geplant. Eine tatsächliche Inbetriebnahme des Ausbaus wird nicht bestätigt.
Prüfe zum Materialstand 12.10.2026.
Gib JSON: testlauf={status="gemeldet",geraete,ereignisdatum,quelle}, ausbau={status="geplant",zielgeraete,quelle}, ausbau_bereits_gestartet=null.
Die letzte Angabe bleibt unbekannt; aus geplant folgt weder durchgeführt noch endgültig abgesagt.Vorlage herunterladenLokalen JSON-Prüfer herunterladen
{
  "testlauf": {
    "status": "gemeldet",
    "geraete": 20,
    "ereignisdatum": "09.10.2026",
    "quelle": "M1"
  },
  "ausbau": {
    "status": "geplant",
    "zielgeraete": 100,
    "quelle": "M2"
  },
  "ausbau_bereits_gestartet": null
}Das Soll ist redaktionell aus der Vorlage abgeleitet, keine aufgezeichnete Modellantwort. Der lokale Prüfer vergleicht die festgelegten Felder und führt keinen generierten Code oder API-Aufruf aus. Er bewertet keine freien Begründungen.
Speichere Prüfer und deine Antwort im selben Ordner. Mit installiertem Python: python pruefen.py antwort.json.
| Beobachtung | Was du prüfst |
|---|---|
| 100 Geräte werden als bereits aktiv beschrieben | M2 nennt nur einen Plan. Übernimm den Status zusammen mit der Zahl. |
| Publikationsdatum ersetzt das Ereignisdatum | M1 erschien am 10.10., der Testlauf begann laut Text am 09.10. |
| Ohne Websuche wird ein neuer aktueller Stand behauptet | Kennzeichne den Materialstand. Für neue Ereignisse brauchst du gesondert geprüfte Originalbelege. |
Für echte Meldungen kannst du KI-Aussagen an Originalquellen prüfen und Datum, Geltungsbereich sowie Belegstelle getrennt festhalten.
Den vollständigen Ablauf übst du in der Lektion mit KI recherchieren und Quellen kontrollieren mit einer eigenen überprüfbaren Frage.
Gezielte Praxisergänzung auf Basis aktueller Herstellerunterlagen. Der Datenstand der bisherigen Modell-Faktentabellen bleibt separat ausgewiesen. Neue Beispiele und Grafiken sind eigene Erklärungen; es wurden keine Modellantworten oder Leistungswerte gemessen.
Herstellerunterlagen zur Ergänzung: Grok Models & Pricing | SpaceXSI Docs (Abruf 2026-10-21) · Web Search | SpaceXSI Docs (Abruf 2026-10-21).
Quellenstand: 2026-10-13. Spezifikationen, Tarife und Zugang können sich ändern. Die Illustration zeigt den dokumentierten Datenweg, keine gemessene Leistung.
Grok 4.7 ist ein Text & Reasoning-Modell von xAI / SpaceXSI. Eingabe: Text, Bild. Ausgabe: Text. Hersteller: xAI / SpaceXSI. Dokumentierte ID: grok-4.7.
Eingabe: Text, Bild. Ausgabe: Text. Maßgeblich sind die Funktionen des konkreten Endpunkts in der Herstellerquelle.
Der dokumentierte Zugang lautet: Gehosteter Zugang. Öffentlich verfügbare offene Gewichte werden damit nicht bestätigt. Ein integriertes On-Device-Modell kann besondere Hardware und Plattformvorgaben haben.
2 / 6 USD je 1 Mio. Texttokens. Standardtarif; Werkzeug-, Such- und Verarbeitungskosten können hinzukommen. Regionale Verfügbarkeit separat prüfen. Bei selbst betriebenen Gewichten kommen Hardware- und Betriebskosten hinzu.
Nein. Das Profil dokumentiert Herstellerangaben mit Quellenstand 2026-10-13. Die Testidee ist redaktionell formuliert und wurde hier nicht ausgeführt; sie ist keine Qualitätsgarantie.
Im dokumentierten Quellenstand: 500.000 Tokens. Beachte die Bedingungen der konkreten Modellversion und des verwendeten Endpunkts. Kontext ist keine Wortzahl und kein Nachweis, dass jede enthaltene Information zuverlässig verarbeitet wird.
Lege eine kleine Aufgabe mit bekanntem oder nachprüfbarem Ergebnis fest. Notiere Version, Eingabe und Einstellungen. Vergleiche die Ausgabe mit deinem Prüfkriterium und halte Fehler sowie tatsächliche Kosten getrennt fest. Die Testidee auf dieser Seite ist ein Vorschlag und wurde hier nicht als Modelltest ausgeführt.
Die Herstellerdokumentation verneint einen automatischen Zugriff auf aktuelle Ereignisse ohne aktivierte Suchwerkzeuge. Eine neu klingende Antwort ist deshalb kein Beleg für eine aktuelle Recherche.
Die fiktive Quelle bestätigt keine Inbetriebnahme, sagt aber auch keine Absage. null erhält diese Wissenslücke. false würde hier eine zusätzliche, nicht belegte Behauptung ausdrücken.
Nein. Beide Texte und ihre Zahlen sind redaktionell konstruierte Übungsdaten. Sie zeigen eine Prüfmethode und sind keine Behauptung über ein tatsächliches Projekt.
Text & Reasoning
Weiterhin auf dem globalen und US-Endpunkt geführt. US-Verarbeitung kostet 10 % mehr; die Garantie schließt Werkzeuge und Dateien nicht vollständig ein.