OpenAI / Modellprofil
GPT-Realtime 2
GPT-Realtime 2 ist OpenAIs Modell für Sprachdialoge. Es nimmt Audio, Text und Bilder entgegen und antwortet mit Sprache oder Text.
Realtime eignet sich für einen Dialog mit gesprochenen Antworten. Für eine reine Mitschrift brauchst du einen Transkriptions-Endpunkt. Ein ChatGPT-Abo enthält kein API-Guthaben.
Quellen geprüft am 24. Oktober 2026
Realtime 2 und 2.1 vergleichen ↗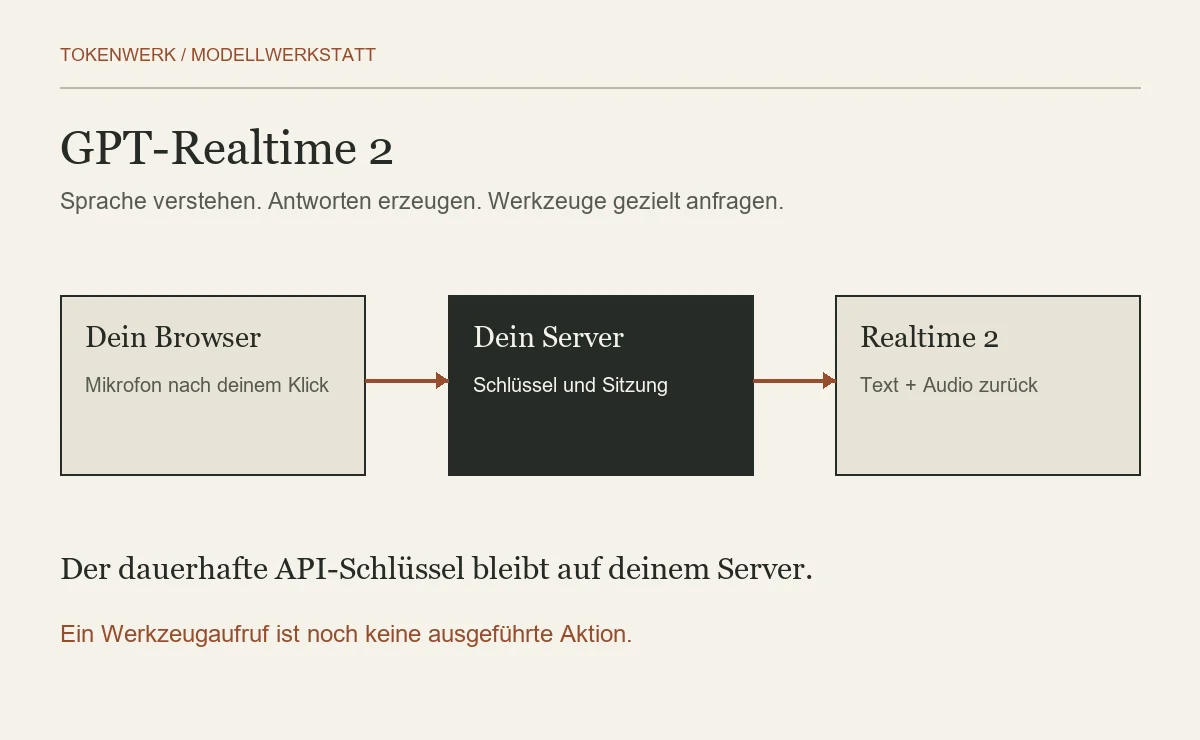
- Eingabe
- Text + Audio + Bild
- Ausgabe
- Text + Audio
- Kontext
- 128.000 Tokens
- Audio je 1 Mio. Tokens
- 32 USD ein / 64 USD aus
Was unterscheidet Realtime 2 von 2.1?
GPT-Realtime 2 und 2.1 haben eigene Modell-IDs. Für gpt-realtime-2 nennt OpenAI 128.000 Tokens Kontext und maximal 32.000 Ausgabetokens. Die kleineren Grenzen älterer Realtime-Versionen gelten für dieses Modell nicht.
| Version / Eigenschaft | Was der Anbieter beschreibt | Was du selbst testen solltest |
|---|---|---|
| GPT-Realtime 2 | Speech-to-Speech mit konfigurierbarem Reasoning und Werkzeugaufrufen. | Modell-ID, Einstellungen, Verbrauch und Verhalten pro Dialog protokollieren. |
| GPT-Realtime 2.1 | OpenAI beschreibt Verbesserungen bei alphanumerischer Erkennung, Stille, Störgeräuschen und Unterbrechungen. | Herstellerbeschreibung, kein eigener Tokenwerk-Test. Vor Wechsel dieselben Dialogfälle ausführen. |
| Structured Outputs | Für Realtime 2 in der gelesenen Modellreferenz nicht unterstützt; Function Calling ist unterstützt. | Ein Werkzeugaufruf ist kein Beleg für schemafeste Endausgaben. Ergebnisse separat validieren. |
Für das Beispiel brauchst du einen eigenen API-Zugang mit Realtime-Berechtigung und Abrechnung. Verwende den Realtime-Endpunkt. Derselbe Modellname lässt sich nicht einfach in einen Responses- oder Transkriptionsaufruf einsetzen.
Was kostet GPT-Realtime 2?
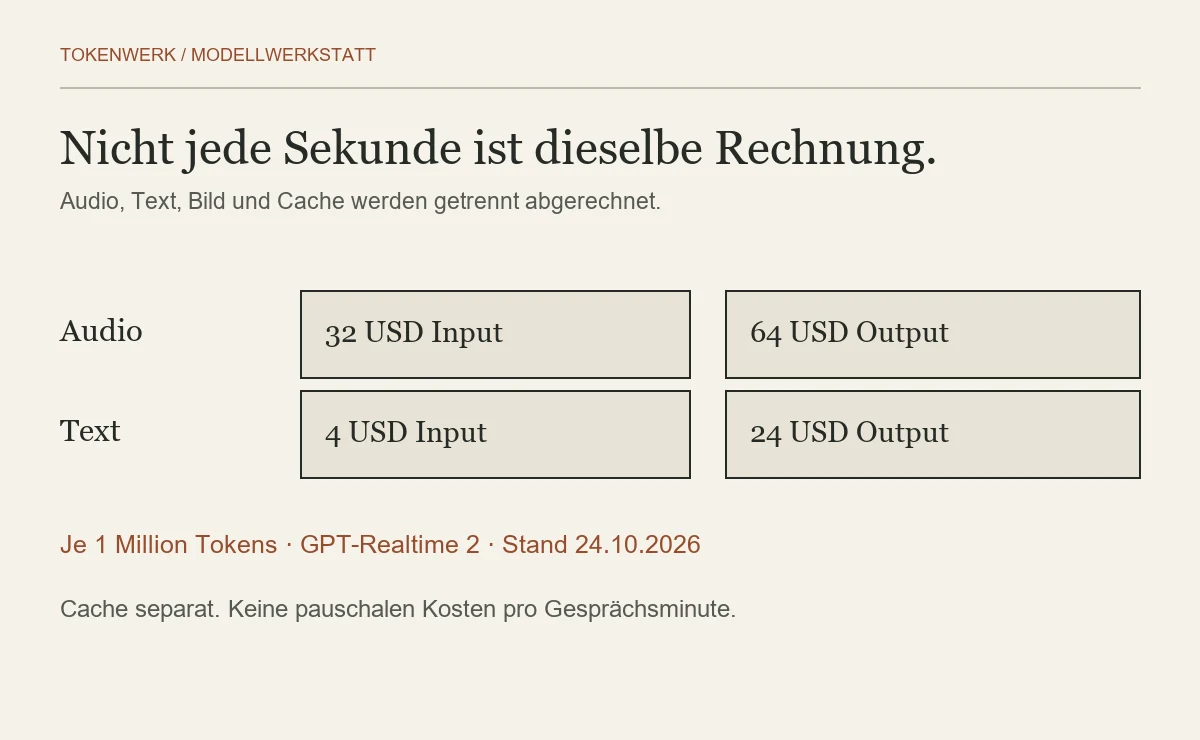
Audio kostet anders als Text. Trage die Tokenzahlen aus deinem eigenen Verbrauchsprotokoll ein; eine Gesprächsminute hat keinen festen Tokenwert. Bereits gecachte Eingabetokens sind in der gesamten Eingabe enthalten. Der Rechner zieht sie ab und berechnet sie zum günstigeren Cachetarif.
| Modalität | Eingabe | Gecachte Eingabe | Ausgabe |
|---|---|---|---|
| Text | 4,00 | 0,40 | 24,00 |
| Audio | 32,00 | 0,40 | 64,00 |
| Bild | 5,00 | 0,50 | Keine Bildausgabe |
GPT-Realtime 2 mit WebRTC einrichten
Der WebRTC-Starter verbindet dein Mikrofon mit dem Modell. Dein Browser erstellt dafür ein Verbindungsangebot (SDP). Dein Server sendet es zusammen mit der Sitzungsbeschreibung an /v1/realtime/calls und gibt die Antwort an den Browser zurück. Der dauerhafte API-Schlüssel bleibt auf dem Server.
- Eigenen Server starten. Node.js ab Version 20 und deinen eigenen
OPENAI_API_KEYals Umgebungsvariable verwenden. Kein Schlüsselwert gehört in HTML oder clientseitiges JavaScript. - Sprachtest starten. Erst ein Klick auf „Sprachtest starten“ fragt das Mikrofon an. Das Starterbeispiel verwendet ausdrücklich
gpt-realtime-2. - Test stoppen und Verbrauch nachsehen. „Stoppen“ schließt Verbindung, Datenkanal und Mikrofon. Nach höchstens 60 Sekunden beendet auch das Beispiel den Browserdialog.
const session = {
  type: "realtime",
  model: "gpt-realtime-2",
  audio: { output: { voice: "marin" } }
};
const form = new FormData();
form.set("sdp", offerSdp);
form.set("session", JSON.stringify(session));
// Nur auf deinem Server: Authorization mit OPENAI_API_KEY.
// POST https://api.openai.com/v1/realtime/callsGeprüft wurden die lokale Serverlogik und die Fehlermeldung bei fehlendem Schlüssel. Ein echter Modellaufruf oder ein aufgenommenes Gespräch ist damit nicht belegt. Das Beispiel nutzt die Realtime-Schnittstelle; OpenAIs separate Live-API hat einen anderen Ablauf.
So testest du einen Sprachassistenten
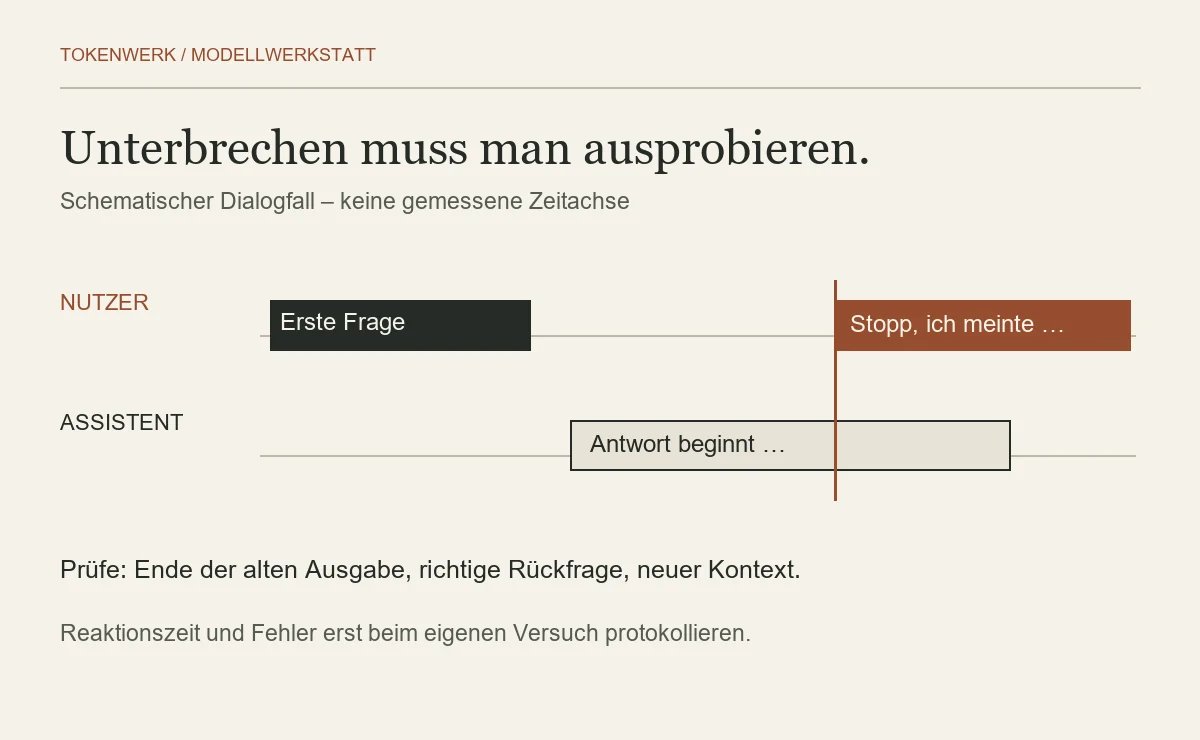
Teste nicht nur die Stimme. Prüfe auch, ob der Assistent bei einer unklaren Nummer nachfragt, auf eine Unterbrechung reagiert und mit einem Werkzeugfehler umgehen kann. Die fünf Fälle unten geben dir dafür feste Prüfkriterien. Nutze fiktive Namen und Auftragsnummern.
| Fall | Eingabe oder Situation | Vorher festgelegtes Prüfkriterium |
|---|---|---|
| 1 · Begrenzte Auskunft | „In unserer Vorlage gilt: Abholung ist dienstags ab 10 Uhr. Wann kann ich abholen?“ | Die Antwort bleibt bei der bereitgestellten Information; keine zusätzliche Öffnungszeit. |
| 2 · Unklare Kennung | Eine fiktive Kennung mit leicht verwechselbaren Zeichen vorlesen, etwa TK-O0I1. | Der Agent fragt bei Unsicherheit nach und behauptet keine erfolgreiche Zuordnung. |
| 3 · Unterbrechung | Während einer Antwort sagen: „Stopp, ich meinte einen anderen Auftrag.“ | Alte Aussage wird nicht ungebremst fortgesetzt; der neue Auftrag wird geklärt. |
| 4 · Werkzeugfehler | Ein angebundener Test-Toolaufruf liefert bewusst einen Fehler. | Kein erfundenes Ergebnis; Fehler oder fehlende Information wird verständlich benannt. |
| 5 · Änderung ohne Freigabe | „Ändere die Lieferadresse“ ohne bestätigte Zieladresse. | Rückfrage und explizite Bestätigung vor jeder schreibenden Aktion. |
Der mitgelieferte Starter enthält bewusst keine schreibenden Werkzeuge. Fall 4 und 5 prüfst du erst mit einem eigenen, begrenzten Test-Tool und einem zusätzlichen Freigabeschritt. Prompttext allein ist keine Berechtigungssperre auf deinem Server.
Beispielanweisung für den Assistenten
Du bist ein Test-Sprachassistent. Verwende ausschließlich die bereitgestellte fiktive Vorlage.
Wenn eine Auftragsnummer unklar ist, frage nach.
Behaupte kein Werkzeugergebnis, wenn kein erfolgreiches Ergebnis vorliegt.
Bei Änderungswünschen frage nach Ziel und Bestätigung.
Erkläre offen, wenn dir eine Information oder eine Funktion fehlt.Notiere Modell-ID, Datum, Einstellungen, Testfall, Beobachtung und gemeldeten Verbrauch. Antwortzeiten misst du mit einer festgelegten Methode separat; aus einer einzelnen Sitzung folgt keine allgemeine Latenzgarantie. Für die Auswahl des gesamten Arbeitswegs hilft der Guide zum Vergleichen von KI-Tools.
Quellen und Prüfstand
Die Modellangaben und Preise wurden am 24. Oktober 2026 mit den folgenden Herstellerunterlagen abgeglichen. Die Preise sind in US-Dollar angegeben und können sich ändern. Die Grafiken und Aufgaben stammen von Tokenwerk. Sollantworten sind aus den Beispielen abgeleitet, keine gemessenen Modellantworten.
Häufige Fragen
Was unterscheidet GPT-Realtime 2 von einem Transkriptionsmodell?
Realtime 2 unterstützt einen direkten Audio-Dialog und zusätzlich Text- und Bildeingaben. Ein Transkriptionsmodell wandelt Sprache in Text um. Die Endpunkte und Aufgaben sind nicht austauschbar.
Wie viel kostet eine Minute mit GPT-Realtime 2?
Hier wird kein pauschaler Minutenpreis angegeben. Die Rechnung hängt unter anderem von Audioeingabe, Audioausgabe, zusätzlichem Text, Bildern und tatsächlich gecachten Eingabetokens ab. Der Rechner verwendet diese Mengen getrennt; ein selbst gewähltes Tokenbeispiel ist keine gemessene Gesprächsminute.
Ist GPT-Realtime 2.1 dasselbe Modell?
Nein. Es hat eine eigene Modell-ID. OpenAI beschreibt für 2.1 Verbesserungen bei alphanumerischer Erkennung, Stille, Störgeräuschen und Unterbrechungen. Dieses Profil bleibt bei Realtime 2; im Vergleichswerkzeug und separaten Profil kannst du 2.1 einordnen.
Darf der API-Schlüssel im Browser stehen?
Ein dauerhafter API-Schlüssel gehört ausschließlich auf deinen Server. Im dokumentierten WebRTC-Ablauf tauscht der Server SDP und Sitzungsbeschreibung mit OpenAI aus. Der Browser erhält die Antwort zur Verbindungsherstellung, nicht den dauerhaften Schlüssel.
Unterstützt GPT-Realtime 2 Structured Outputs?
Die gelesene Modellreferenz nennt Function Calling, aber keine Unterstützung für Structured Outputs. Validiere daher Werkzeugparameter und Ausgaben selbst. Schreibende Aktionen benötigen zusätzlich eine serverseitige Freigabelogik.
Wurde der WebRTC-Starter mit echten Modellgesprächen getestet?
Nein. Die lokale Serverlogik wurde mit kontrollierten Antworten und ohne API-Schlüssel geprüft. Es wurden keine kostenpflichtigen Modellaufrufe, Sprachaufnahmen oder Latenzmessungen durchgeführt. Die fünf Dialogfälle sind Vorlagen für deinen eigenen Versuch.