Beginne mit einem kurzen deutschen Test und dem mehrsprachigen Modell base. Wandle die Aufnahme in eine eindeutig definierte WAV-Datei um, exportiere Text und Untertitel und höre Namen, Zahlen sowie Verneinungen nach. Lokal berechnet heißt nicht automatisch fehlerfrei oder ohne weitere Datenverbindungen.
Whisper lokal: Modell, Laufzeit und Oberfläche
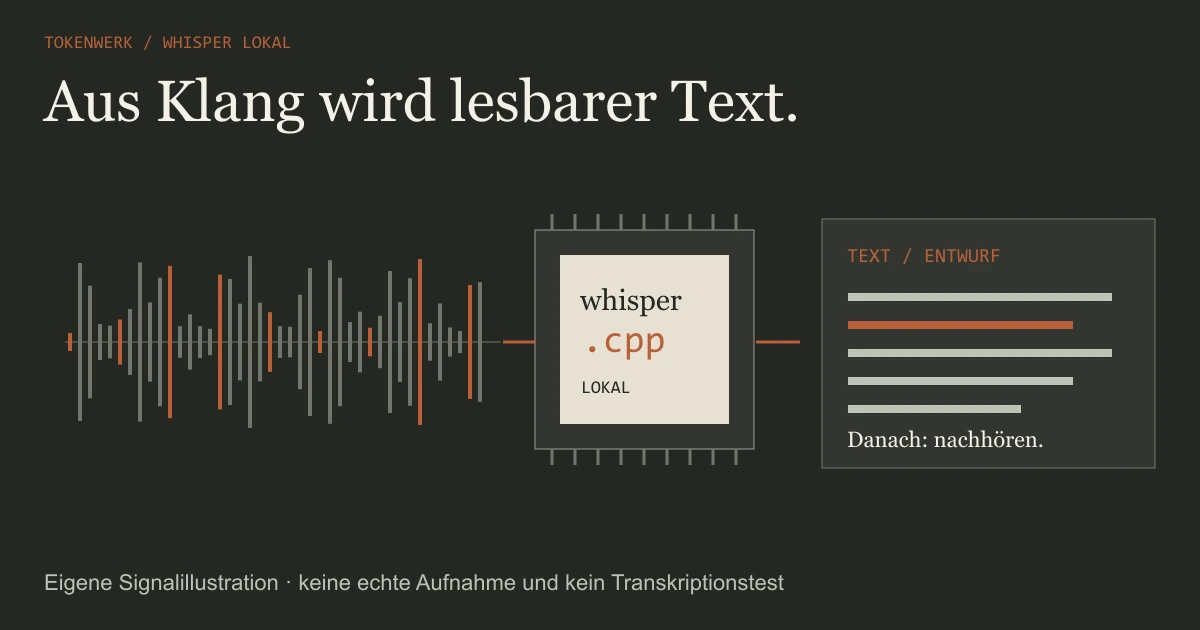
Whisper bezeichnet das Spracherkennungsmodell. whisper.cpp ist eine eigenständige Community-Laufzeit, mit der du passende Modellgewichte auf deinem Rechner verwenden kannst. Eine grafische Anwendung kann diese Arbeit hinter einer Oberfläche verbergen. Die OpenAI-API ist wiederum ein anderer, gehosteter Zugangsweg.
| Weg | Passt zu dir, wenn … | Worauf du achtest |
|---|---|---|
| whisper.cpp im Terminal | du Dateipfade, Modell und Export selbst nachvollziehen möchtest. | Buildwerkzeuge, kompatibles Modellformat und Audioeingang. |
| noScribe als Anwendung | du Interviews mit einem Editor nachbearbeiten und Sprecher unterscheiden möchtest. | Eigenes Programm mit weiteren Komponenten; aktuelle Downloads nur über den Maintainer. |
Dieser Guide erklärt den Terminalweg. noScribe ist eine zusätzliche Option und keine Oberfläche, die du auf unsere Befehle aufsetzen musst. Zum Einordnen anderer Verfahren kannst du Transkriptionswerkzeuge nach deinem Aufnahmezweck vergleichen.
Eine Transkription ist zunächst ein Entwurf dessen, was gesprochen wurde. Sie ersetzt weder das Nachhören noch die Entscheidung, welche Informationen du weitergeben möchtest.
Vor dem Start: Rechner, Werkzeuge und Aufnahme
Du brauchst Speicherplatz für Programm und Modell, eine zulässige eigene Aufnahme und beim beschriebenen Quellcodeweg Git, CMake und einen C/C++-Compiler. Für den Konvertierungsbefehl kommt FFmpeg hinzu. Die folgende Befehlsfolge richtet sich an Linux oder macOS mit bereits verfügbaren Werkzeugen; deren Installation unterscheidet sich je nach System.
Werkzeuge vorhanden? – lesende Versionsabfragen
git --version
cmake --version
ffmpeg -versionFehlt ein Werkzeug, richte es über dessen offizielle Anleitung für dein Betriebssystem ein. Unter Windows gibt es einen separaten MSVC- oder MinGW-Buildweg. Verwende dort die Projektdokumentation und den tatsächlich erzeugten Pfad zur whisper-cli.exe; ein Linuxpfad ist kein Windows-Installationsschritt.
Nimm für den ersten Versuch etwa diesen eigenen fiktiven Prüfsatz auf: „Der Test beginnt um 09:30 Uhr. Nicht am Montag, sondern am Dienstag. Der Raum heißt Kupfer 7.“ So kennst du den Sollinhalt und kannst Zahl, Verneinung und Namen kontrollieren.
Bevor du fremde Interviews oder persönliche Aufnahmen verarbeitest, solltest du private Angaben vor einer KI-Verarbeitung prüfen. Verwende zum Lernen keine vertraulichen Gespräche.

whisper.cpp bauen und ein deutsches Modell laden
Öffne einen eigenen Arbeitsordner. Die ersten beiden Zeilen laden den Quellcode und wechseln hinein. Die folgenden Zeilen bauen das Programm. Führe sie selbst aus und lies Fehlermeldungen, bevor du zum Modell weitergehst.
Linux/macOS – Quellcode holen und bauen
git clone https://github.com/ggml-org/whisper.cpp.git
cd whisper.cpp
cmake -B build
cmake --build build -j --config ReleaseDer Standardbeispielpfad im Projekt verwendet oft base.en. Für unseren deutschen Versuch wählen wir bewusst base ohne .en. Das Downloadskript bezieht ein zum Projekt passendes, umgewandeltes ggml-Modell. Der Download benötigt eine Netzwerkverbindung.
Mehrsprachiges Modell laden und CLI-Hilfe prüfen
sh ./models/download-ggml-model.sh base
./build/bin/whisper-cli -hNach dem Download sollte der zum folgenden Aufruf passende Modellpfad models/ggml-base.bin vorhanden sein. Prüfe den tatsächlichen Dateinamen. Ein Ordner voller anderer Modellformate wird durch Umbenennen nicht kompatibel.
Für einen ersten CPU-Versuch brauchst du keinen zusätzlichen GPU-Build. Beschleuniger wie Metal, CUDA, Vulkan oder ROCm haben eigene Voraussetzungen. Wie schnell deine Aufnahme verarbeitet wird, hängt unter anderem von Rechner, Modell und Einstellungen ab; wir nennen hier keine erfundene Laufzeit.
Audio umwandeln und TXT sowie SRT erzeugen
Lege deine Testaufnahme als probe.mp3 im Projektordner ab oder ersetze den Dateipfad im Befehl. Die Hauptanleitung empfiehlt 16-Bit-WAV; die CLI-Hilfe nennt außerdem weitere Audioformate. Für einen eindeutig beschriebenen Einstieg verwenden wir deshalb Mono-WAV mit 16 kHz und PCM16.
Eigene Aufnahme in ein klares Eingangsformat bringen
ffmpeg -i probe.mp3 -ar 16000 -ac 1 -c:a pcm_s16le probe.wavVerwende einen neuen Ausgabepfad und behalte das Original. Die Konvertierung verbessert keine bereits unverständliche Aufnahme und stellt abgeschnittene Wörter nicht wieder her. Sie vereinheitlicht zunächst das technische Format.
Deutsch transkribieren, Text und Untertitel ausgeben
./build/bin/whisper-cli -m models/ggml-base.bin -f probe.wav -l de -otxt -osrt -of probe-transkript-m wählt die Modelldatei, -f die Aufnahme und -l de die gesprochene Sprache. -otxt und -osrt aktivieren Text- und Untertiteldatei. Bei -of steht der Ausgabename ohne Dateiendung; prüfe anschließend probe-transkript.txt und probe-transkript.srt.
Die Übersetzungsoption -tr gehört nicht zu diesem Versuch: Sie übersetzt laut CLI-Hilfe in Englisch. Für ein deutsches Transkript lassen wir sie weg.
Transkript prüfen und Sprecher nicht erraten
Öffne den Text neben der Aufnahme. Höre die drei Prüfpunkte einzeln ab: 09:30, die Korrektur von Montag zu Dienstag und Kupfer 7. Eine gut lesbare Formulierung kann trotzdem eine falsche Zahl enthalten. Markiere unklare Stellen mit Zeitbezug, statt sie aus dem Zusammenhang zu ergänzen.
Speichere Rohtranskript und korrigierte Fassung getrennt. Für Untertitel kontrollierst du zusätzlich Anfang, Ende und sinnvolle Segmentgrenzen. Automatische Zeitmarken sind ein Arbeitsmittel und müssen zum Ton passen.
Sprechertrennung ist ein eigener Schritt. Die CLI unterscheidet unter anderem Stereo-Diarisierung und experimentelles tinydiarize mit passendem Zusatzmodell. Beides ist kein sicherer Nachweis realer Namen. noScribe nutzt für seinen Interviewablauf weitere Komponenten und einen Revieweditor. Ob eine Person richtig zugeordnet wurde, prüfst du am Audio.
Eigene Transkriptionsprüfliste herunterladen. Sie enthält unseren fiktiven Prüfsatz und freie Felder für deine tatsächlichen Beobachtungen, keine vorgetäuschten Erkennungsergebnisse.
Wenn Modell, Audio oder Ausgabe nicht passen
| Symptom | Nächster sinnvoller Schritt |
|---|---|
| Programm nicht gefunden | Buildabschluss und tatsächlichen Binärpfad prüfen; nicht sofort ein anderes Modell laden. |
| Modell lässt sich nicht öffnen | Arbeitsordner, Dateiname und erfolgreichen ggml-Download prüfen. |
| Unpassende Sprache oder englischer Text | Mehrsprachige Variante und -l de prüfen; ungewolltes -tr entfernen. |
| Audio kann nicht gelesen werden | Die WAV-Konvertierung kontrollieren und mit einer kurzen eigenen Aufnahme beginnen. |
| Text ist flüssig, aber inhaltlich falsch | Am Original nachhören; schwierige Stellen markieren und Aufnahmequalität prüfen. |
| Kein Export am erwarteten Ort | Ausgabebasis nach -of und aktuellen Arbeitsordner kontrollieren. |
Verändere jeweils nur eine Sache und notiere das Ergebnis. Ein größerer Modellname ist keine Antwort auf einen falschen Dateipfad. Für längere Aufnahmen prüfst du erst einen kurzen Ausschnitt, bevor du einen großen Auftrag startest.
Der lokale Rechenweg vermeidet den notwendigen Audio-Upload an eine gehostete Erkennungs-API. Ob dein gesamter Arbeitsablauf lokal bleibt, hängt zusätzlich von Programmfunktionen, Synchronisierung und verbundenen Diensten ab. Dazu kannst du lokale und gehostete KI nach ihren Datenwegen unterscheiden.
Quellen & Methode
Vorgehen und Grenzen
Vier aktuelle Originaltexte vollständig gelesen: OpenAI-Modellbeschreibung, whisper.cpp-Hauptanleitung, CLI-Referenz und noScribe-Maintainer. Befehle redaktionell gegen diese Dokumentation geprüft; keine Installation, Audioverarbeitung oder Geschwindigkeitsmessung ausgeführt.
Bei Recherche, Texterstellung und Grafiken wird KI eingesetzt. Welche eigenen Versuche vorliegen und was nur als Beispiel dient, beschreibt dieser Beitrag. Unser Redaktionsstandard erklärt die Anforderungen an Belege und Berichtigungen.