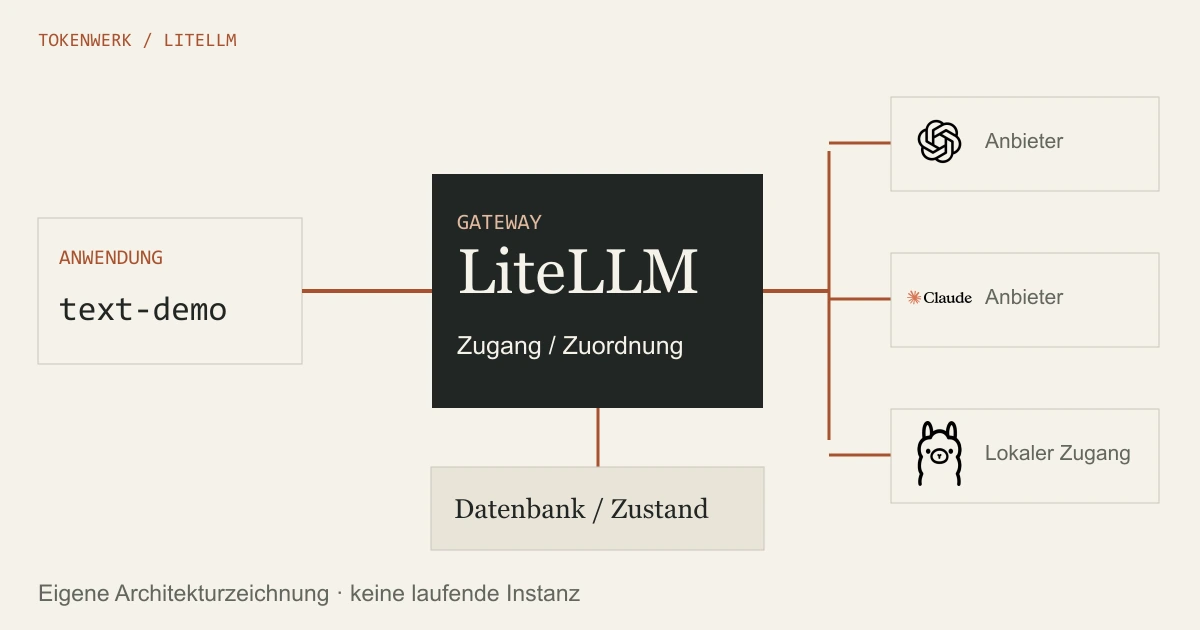
Trenne Anwendung, Gateway und Anbieter. Verwende für Anwendungen freigegebene virtuelle Schlüssel statt des Adminschlüssels. Prüfe Datenbank und gemeinsamen Zustand, bevor du dich auf Budgets oder verteilte Limits verlässt. Eine Konfigurationszeile allein beweist keine wirksame Kostengrenze.
Was LiteLLM zwischen Anwendung und Modell übernimmt
Die Projektübersicht beschreibt zwei grundlegende Wege. Mit dem Python-SDK ruft deine Anwendung die Bibliothek direkt auf. Beim Gateway läuft ein eigener Dienst, den mehrere Anwendungen ansprechen können. Das schlankere Core-Paket ist wiederum ein eigener Installationsweg und soll nicht mit derselben vollständigen Distribution in dieselbe Umgebung gemischt werden.
| Rolle | Aufgabe | Bleibt separat |
|---|---|---|
| Anwendung | Sendet einen erlaubten Auftrag an einen Modellalias | Eigener Zweck und Ergebnisprüfung |
| LiteLLM-Gateway | Ordnet Modellzugang, Berechtigung und Verwaltung zu | Betrieb, Schlüssel und gespeicherter Zustand |
| Modellanbieter | Verarbeitet die weitergeleitete Modellanfrage | Vertrag, Modellfunktionen und Verbrauch |
Eine ähnliche Anfrageform macht Modelle nicht gleich. Unterstützte Funktionen, Kontext, Ausgabe und Preise müssen weiterhin zum gewählten Anbieter passen. Ein lokal betriebener Proxy bedeutet außerdem nicht, dass auch die Inferenz lokal bleibt.
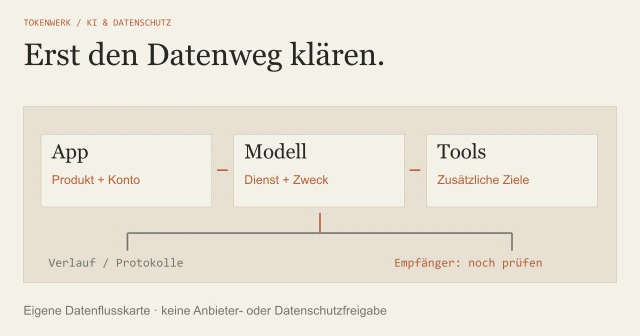
Gateway, Protokollierung und angebundene Anbieter sind zusätzliche Stationen des Datenwegs. Vor vertraulicher Nutzung solltest du Datenwege und Kontozugänge bei KI prüfen.

Einen ersten Gateway-Aufbau planen
Der aktuelle Gateway-Quickstart beschreibt einen Compose-Aufbau aus LiteLLM und PostgreSQL. Die Datenbank speichert unter anderem verwaltete Modelle, Schlüssel und Verbrauchsprotokolle. Dieser Weg ist von einem einfachen Proxy ohne Verwaltungsdatenbank zu unterscheiden.
- Lege den vorgesehenen Zweck und den erreichbaren Nutzerkreis fest.
- Lies die offizielle Compose-Datei vor dem Start und kontrolliere Dienste sowie Portfreigaben.
- Verwende einen bewusst gewählten Versionsstand und geschützte Werte außerhalb des öffentlichen Webverzeichnisses.
- Starte zunächst einen begrenzten Aufbau und prüfe dessen Meldungen.
- Konfiguriere einen erlaubten Anbieter und ein passendes Modell.
- Prüfe anschließend eine einzelne freigegebene Anfrage.
Die Dokumentation bietet auch einen Einzeiler an, der ein Skript lädt und direkt ausführt. Für den eigenen Aufbau ist es nachvollziehbarer, die beteiligten Dateien zuerst zu lesen und die Ausführung bewusst zu starten. Keine Anleitung auf dieser Seite hat einen Container, eine Cloudressource oder einen Gatewaydienst auf dem Tokenwerk-Server installiert.
Für einen öffentlichen Betrieb kommen unter anderem TLS, Zugriffskontrolle, Versionsbindung, Sicherung und Überwachung hinzu. Eine lokal erreichbare Verwaltungsseite ist noch keine abgeschlossene Betriebsfreigabe.
Adminzugang und Anwendungsschlüssel trennen
Der Masterkey ist ein Verwaltungszugang. Er gehört nicht in eine öffentliche Webseite oder in ein gewöhnliches Anwendungsskript. Für Anwendungen und Teammitglieder beschreibt LiteLLM virtuelle Schlüssel mit jeweils erlaubten Modellen und weiteren Grenzen.
Ein weiterer Wert, der Saltkey, schützt gespeicherte Anbieterzugänge. Ihn nachträglich einfach neu zu erzeugen, kann vorhandene Daten unlesbar machen. Bewahre die vorgesehenen Werte geschützt auf und plane Änderungen nach der aktuellen Herstelleranleitung.
Die UI-Hilfe unterscheidet den gemeinsamen Bootstrapzugang aus Umgebungswerten und persönliche Administratorkonten. Erstelle und prüfe einen erlaubten persönlichen Verwaltungszugang, bevor ein bestehender Bootstrapweg abgeschaltet wird. Sonst kannst du dich selbst aussperren.
Fehlgeschlagene Anmeldungen und zu viele Versuche können eigene Sperrfenster haben. Eine verweigerte Anmeldung ist daher kein Grund, Ratelimits oder andere Schutzmechanismen pauschal auszuschalten. Prüfe Meldung, Konto, Zeitpunkt und den konkret verwendeten Zugangsweg.
Eine Anfrage über einen Modellalias vorbereiten
Ein Modellalias ist ein Name, den die Anwendung anspricht. In unserer eigenen Dokumentationsprobe heißt er text-demo. Damit die Anfrage funktioniert, muss dieser Alias im Gateway bereits auf einen tatsächlich verfügbaren Anbieterzugang zeigen. Der Name allein installiert oder lädt kein Modell.
Eigene JSON-Anfrage · Alias vorher konfigurieren
{
  "model": "text-demo",
  "messages": [
    {
      "role": "user",
      "content": "Antworte mit dem Wort bereit."
    }
  ]
}Die Anfrage gehört zum dokumentierten Chat-Completions-Weg, etwa unter /v1/chat/completions. Dazu kommt die Anmeldung mit dem dafür freigegebenen Anwendungsschlüssel. Die Payload enthält absichtlich keinen Schlüssel und kein angeblich beobachtetes Antwortobjekt.
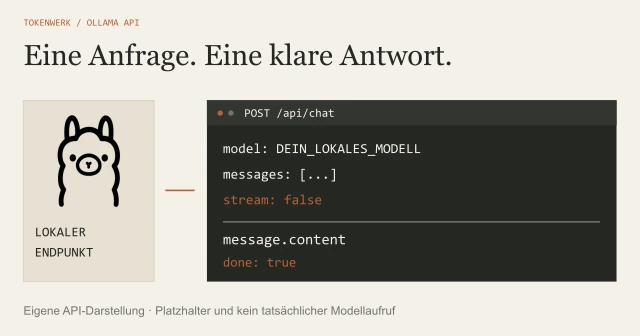
Wenn du einen lokalen Anbieter anbinden möchtest, kannst du Ollama über die lokale API ansprechen. Prüfe dabei den tatsächlich gewählten Modellnamen und den Betriebsmodus. Eine Adresse mit localhost belegt nicht automatisch, dass ein ausgewähltes Cloudmodell lokal rechnet.
Prüfe bei einem Fehler zuerst vier Zuordnungen: Zieladresse des Gateways, angesprochener Alias, Modellfreigabe des Anwendungsschlüssels und Anbieterzugang. Eine erfolgreich geöffnete Adminseite belegt noch keine erfolgreiche Modellanfrage.
Budgets und gemeinsame Limits richtig einordnen
Die aktuelle Startanleitung nennt eine wichtige Grenze ausdrücklich: Ohne verbundene Datenbank wird ein eingestelltes globales max_budget nicht als verlässliche Ausgabengrenze durchgesetzt. Der laufende Verbrauch kann auf diesem Weg unbekannt bleiben. Eine eingetragene Zahl ist deshalb kein Nachweis eines wirksamen Stopps.
Auch virtuelle Schlüssel, UI-Verwaltung und Verbrauchsverfolgung benötigen die passenden Speicherfunktionen. Für mehrere Prozesse oder Instanzen beschreibt die Betriebsdokumentation gemeinsamen Zustand, etwa über Redis. Ohne ihn können bestimmte Zähler pro Prozess statt für den gesamten Aufbau gelten.
Prüfe außerdem die Grenzen beim Anbieter selbst. Ein Proxy kann zusätzliche Aufrufe weiterleiten; er macht einen kostenpflichtigen Zugang nicht kostenlos. Wiederholungen, Fallbacks und verschiedene Modelle müssen zum vorgesehenen Budget und Datenweg passen.
Für die Gesamtplanung kannst du KI-Kosten an einem begrenzten Einsatz prüfen. Trenne Hosting, Datenbank, Modellverbrauch und Betreuung. Unbekannte Verbrauchswerte bleiben offene Annahmen.
Den vollständigen Anfrageweg prüfen
Eine Startmeldung, ein Healthendpunkt und eine Modellantwort beantworten unterschiedliche Fragen. Die Betriebsdokumentation nennt /health/readiness für die Bereitschaft des Aufbaus. Eine erfolgreiche Modellanfrage prüft zusätzlich den Weg über Alias, Berechtigung und Anbieter.
| Prüfung | Was sie belegen soll | Was offen bleibt |
|---|---|---|
| Prozess startet | Dienst kann mit seiner Konfiguration laufen | Anbieterzugang und Modellfreigabe |
| Bereitschaft und Datenbank | Benötigter Speicher ist erreichbar | Richtigkeit einer Modellantwort |
| Erlaubte Anfrage | Freigegebener Alias wird korrekt weitergeleitet | Andere Modelle und Grenzfälle |
| Verweigerte Anfrage | Nicht freigegebener Zugriff wird abgelehnt | Alle denkbaren Angriffe |
| Begrenzter Budgettest | Die vorgesehenen Kostenbedingungen werden wirksam geprüft | Verhalten bei anderen Betriebsbedingungen |
Eigene Anfrage und Abnahmematrix herunterladen. Die Beobachtungsfelder sind bewusst leer. Hier wurde keine API-Anfrage ausgeführt und kein Durchsatz gemessen. Nutze kleine, erlaubte Versuche und dokumentiere die tatsächlichen Antworten, bevor du den Zugang erweiterst.
Quellen & Methode
Vorgehen und Grenzen
Die Anleitung beruht auf den unten verlinkten LiteLLM-Unterlagen zu SDK, Gateway, Zugängen und Betrieb. Die Anfrage und Abnahmematrix sind eigene Vorlagen; sie dokumentieren keinen ausgeführten Proxy- oder Anbieteraufruf. Eine Konfiguration allein belegt weder ein wirksames gemeinsames Limit noch die Einhaltung eines Kostenbudgets.
Bei Recherche, Texterstellung und Grafiken wird KI eingesetzt. Welche eigenen Versuche vorliegen und was nur als Beispiel dient, beschreibt dieser Beitrag. Unser Redaktionsstandard erklärt die Anforderungen an Belege und Berichtigungen.